
机器学习与深度学习 / 系统课时
模型保存与安全加载
模型保存与安全加载
本课解决模型文件“能保存却难以可靠恢复”的问题,比较不同保存粒度,并用权重字典、元数据校验、CPU 映射和输出一致性测试构建一条可复用的安全加载流程。
学习目标
- 根据训练续跑、推理部署和模型分发选择保存方式
- 使用权重优先的方式加载模型并处理设备差异
- 通过元数据、严格匹配和冒烟测试验证加载结果
先选择保存粒度
模型保存方式决定了文件对代码结构、运行环境和安全边界的依赖。推理部署通常优先保存 state_dict,训练续跑则在检查点中额外保存优化器、轮次和调度器状态。
| 方式 | 适用场景 | 主要特点 |
|---|---|---|
state_dict |
推理部署、模型版本发布 | 只保存参数张量,需由代码重新创建模型结构 |
| 检查点字典 | 中断恢复、实验复现 | 可同时保存权重、优化器状态、轮次和必要元数据 |
| Safetensors | 需要纯张量格式的模型分发 | 不依赖任意 Python 对象反序列化,但需生态支持 |
| 完整模型对象 | 临时实验 | 强依赖类路径和 Python 序列化,不适合作为不可信分发格式 |
部署格式与训练检查点不是同一概念。ONNX、TorchScript 或推理引擎文件面向运行时执行,而检查点主要用于恢复参数和训练状态;不要用一个文件同时承担所有职责。
建立安全加载链路
安全加载不是只加一个参数,而是从来源校验开始,经过受限反序列化、设备映射、元数据检查、结构匹配,最后用固定输入验证输出。任何一步失败都应终止发布。
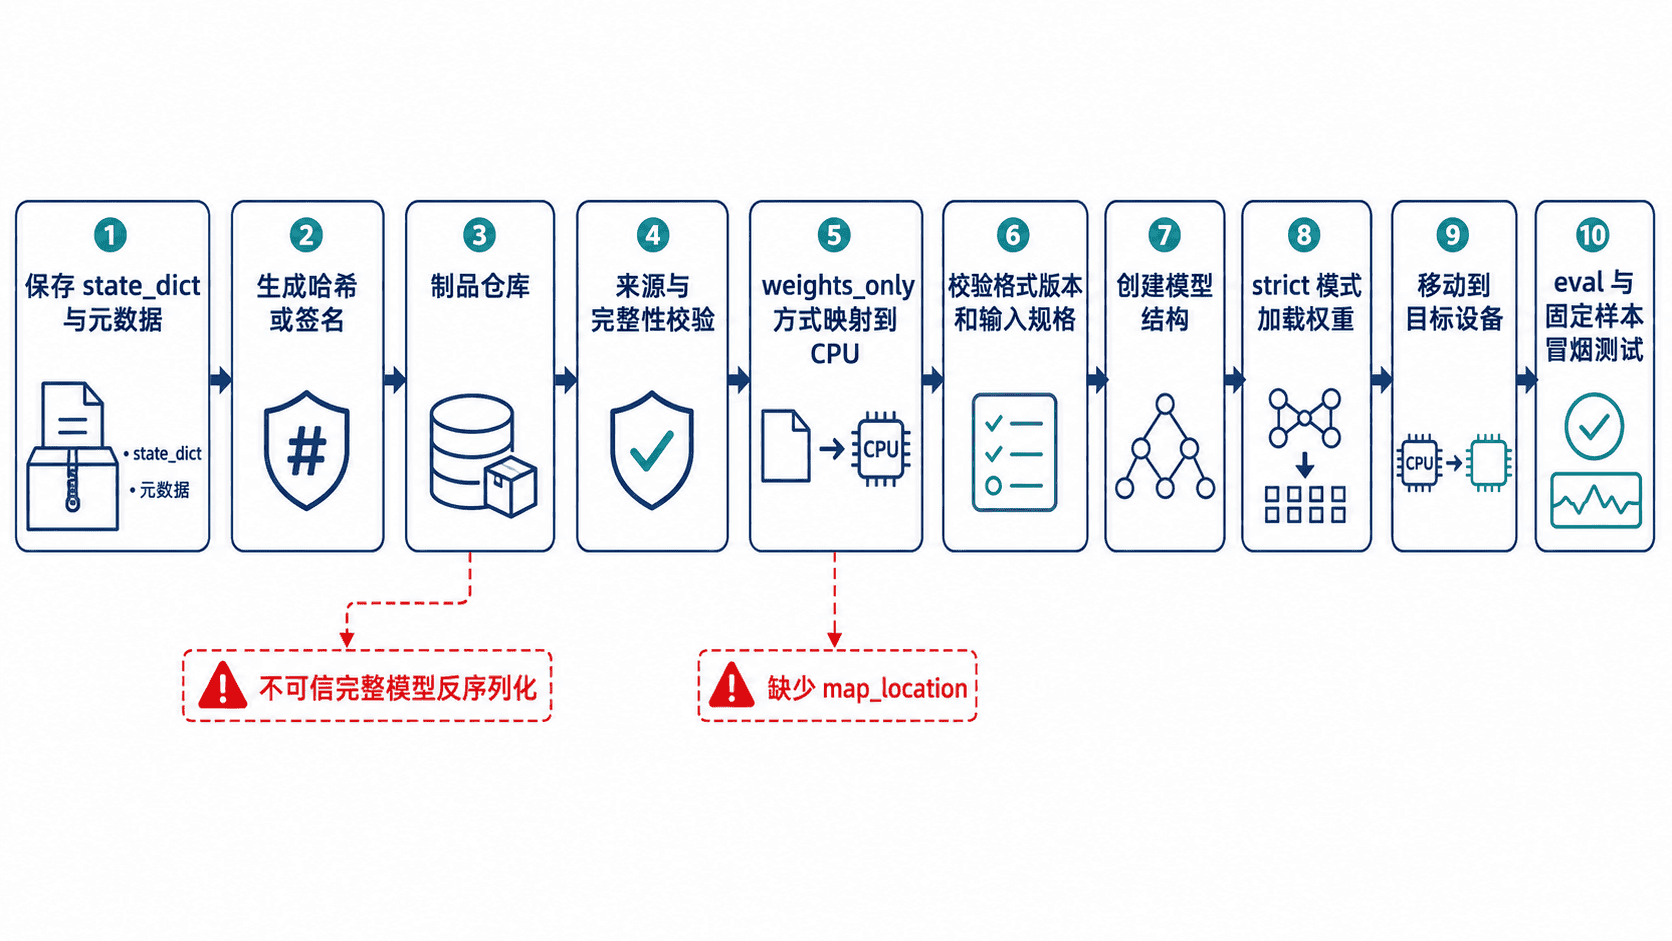
来源可信仍然是第一道边界。weights_only=True 可以限制加载对象的范围,但不能替代文件哈希、签名、制品仓库权限和版本审批。跨设备加载时先映射到 CPU,再由应用决定是否移动到 CUDA,能够避免保存端 GPU 编号与部署端不一致。
保存并恢复权重
下面的示例保存模型参数和最小元数据,加载时启用权重优先模式,校验格式版本与输入特征数,并用 strict=True 阻止缺失或多余参数被静默忽略。
from pathlib import Path

import torch
from torch import nn

CHECKPOINT_PATH = Path("model_checkpoint.pt")
LABELS = ["cat", "dog"]
FORMAT_VERSION = 1

class SmallClassifier(nn.Module):
    def __init__(self) -> None:
        super().__init__()
        self.network = nn.Sequential(
            nn.Linear(4, 8),
            nn.ReLU(),
            nn.Linear(8, len(LABELS)),
        )

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        return self.network(x)

def save_checkpoint(model: nn.Module) -> None:
    # 检查点只保存权重和恢复模型所需的最小元数据。
    checkpoint = {
        "format_version": FORMAT_VERSION,
        "model_state": model.state_dict(),
        "labels": LABELS,
        "input_features": 4,
    }
    torch.save(checkpoint, CHECKPOINT_PATH)

def load_checkpoint(
    runtime_device: torch.device,
) -> tuple[nn.Module, list[str]]:
    # 先映射到 CPU,避免加载端必须拥有保存端的 GPU。
    checkpoint = torch.load(
        CHECKPOINT_PATH,
        map_location="cpu",
        weights_only=True,
    )

    if checkpoint["format_version"] != FORMAT_VERSION:
        raise ValueError("unsupported checkpoint format")
    if checkpoint["input_features"] != 4:
        raise ValueError("checkpoint does not match model input")

    model = SmallClassifier()
    # strict=True 会暴露模型结构与权重键不一致的问题。
    model.load_state_dict(checkpoint["model_state"], strict=True)
    model.to(runtime_device).eval()
    return model, checkpoint["labels"]

def main() -> None:
    torch.manual_seed(7)
    source_model = SmallClassifier().eval()
    sample = torch.tensor([[0.2, 0.4, 0.6, 0.8]])

    with torch.inference_mode():
        expected = source_model(sample)

    save_checkpoint(source_model)

    runtime_device = torch.device(
        "cuda" if torch.cuda.is_available() else "cpu"
    )
    loaded_model, labels = load_checkpoint(runtime_device)

    # 使用同一输入比较保存前后的输出,作为最小冒烟测试。
    with torch.inference_mode():
        actual = loaded_model(sample.to(runtime_device)).cpu()

    print(f"device={runtime_device.type}")
    print(f"labels={labels}")
    print(f"same_output={torch.allclose(expected, actual, atol=1e-6)}")

if __name__ == "__main__":
    main()
预期输出:
device=<DEVICE>
labels=['cat', 'dog']
same_output=True
其中 <DEVICE> 在具备可用 CUDA 环境时为 cuda,否则为 cpu。same_output=True 表示保存前后的模型在同一测试输入上结果一致;若为 False,应停止部署并检查结构、精度类型或设备计算差异。
处理典型加载失败
完整保存 torch.save(model, path) 后,一旦类名、模块路径或依赖版本变化,加载可能直接失败。更严重的是,传统 Python 反序列化能够构造对象,因此不应加载来源不可信的完整模型文件。
从 GPU 保存的文件在纯 CPU 机器上报设备错误时,应通过 map_location="cpu" 恢复,而不是要求部署机复制训练环境。若 load_state_dict 报缺失键或多余键,应核对模型代码与检查点版本,不要轻易改成 strict=False 掩盖结构漂移。
模型加载成功后仍要调用 eval(),否则 Dropout 和 BatchNorm 可能保持训练行为。还应校验标签列表、输入尺寸、格式版本和模型哈希,防止“权重正确但外围契约错误”。
上线前验证
发布流程应把模型文件、哈希或签名、模型结构版本、标签映射和输入规范视为同一个制品集合。加载后先在 CPU 完成结构与元数据校验,再移动到目标设备执行固定样本冒烟测试。
验收结果至少包含加载是否严格成功、固定样本输出是否一致、目标设备是否可用,以及失败时是否阻止服务接管流量。这样才能把模型恢复从一次文件操作变成可审计的部署步骤。
本课总结
- 推理部署优先保存参数权重,训练续跑再增加必要状态
- 安全加载需要来源校验、受限加载、设备映射和严格结构匹配
- 固定输入的输出一致性测试是模型上线前的最后一道验证
下一课预告
下一课将把通过验证的模型转换为部署格式,并检查动态维度、算子兼容性和导出前后的推理一致性。