
机器学习与深度学习 / 系统课时
部署监控与模型回滚
部署监控与模型回滚
本课将建立一套可执行的模型上线保护机制:为每次预测绑定版本信息,持续监控服务、数据和质量指标,并通过灰度发布、自动判定与快速回滚降低故障影响。
学习目标
- 设计覆盖服务状态、输入数据和预测质量的监控指标。
- 为模型、预处理和阈值建立可追溯的版本体系。
- 制定灰度发布、触发回滚和回滚后验证流程。
监控三层信号
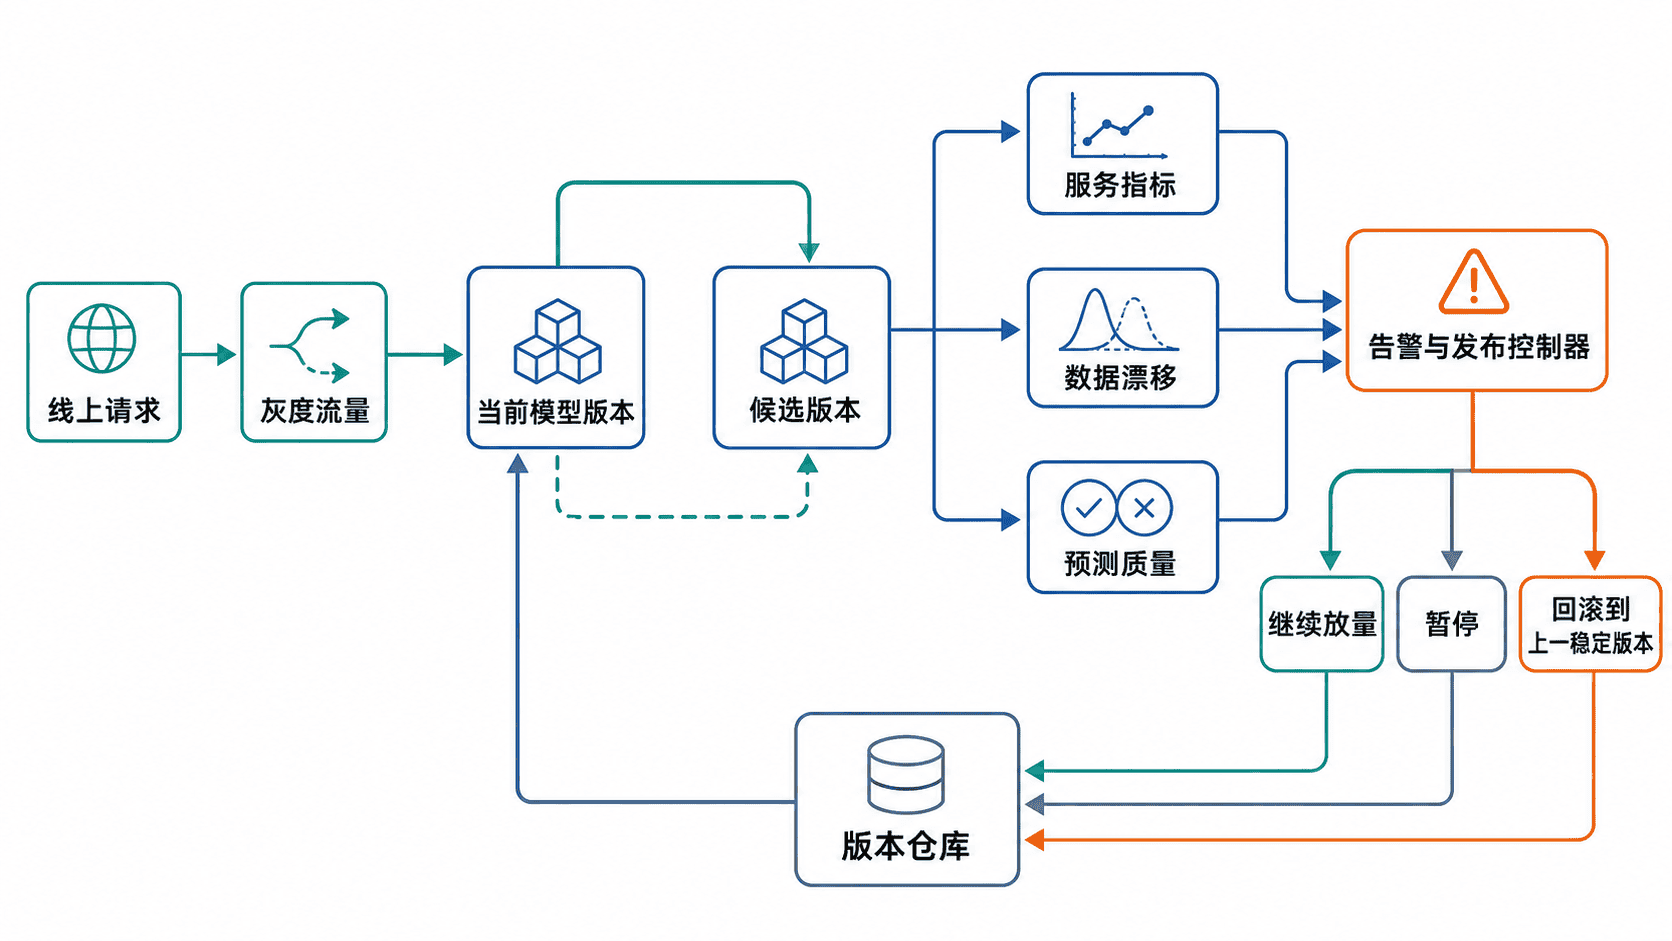
服务层关注可用性、错误率、QPS、P95/P99、超时、CPU、GPU、内存和队列长度。这些指标回答“服务是否稳定”,但不能证明模型仍然有效。
数据层检查字段缺失率、类型、范围、类别占比和分布漂移。漂移告警表示线上输入与基准数据发生变化,不等于模型一定失效,因此需要结合预测分布和业务结果判断。
质量层关注准确率、召回率、误报率、校准误差或业务转化率。真实标签经常延迟到达,应把实时代理指标与延迟质量指标分开,避免把短期置信度变化误判为最终质量下降。
每条日志、指标和预测记录都应包含 model_version、preprocess_version 和请求追踪标识。没有版本维度,即使发现异常,也难以确定影响范围和回滚目标。
版本与发布策略
可回滚单元不能只有模型文件,还应包含预处理代码、特征顺序、词表、后处理阈值、运行时依赖和配置。每个发布包必须不可变,并记录构建时间、数据版本和评估结果。
上线时先让少量流量进入候选版本,例如 1% 到 5%,再按阶段扩大。每个阶段都设置最短观察窗口和样本下限;样本不足时不应仅凭几个请求得出结论。
回滚触发条件应提前定义,并区分硬条件与软条件。错误率、崩溃和严重超时可作为硬条件立即回滚;轻微漂移或代理质量波动更适合暂停放量并等待更多证据。
最小回滚决策器
下面的脚本演示如何把错误率、尾延迟、漂移和质量下降统一为回滚判定。它只负责给出决策,不直接操作生产环境;真实系统应由发布平台执行版本切换并保留审计记录。
from dataclasses import dataclass
from typing import List, Tuple

@dataclass(frozen=True)
class MetricWindow:
    version: str
    requests: int
    errors: int
    p95_ms: float
    drift_score: float
    quality: float

def decide(current: MetricWindow, baseline: MetricWindow) -> Tuple[str, List[str]]:
    reasons: List[str] = []
    error_rate = current.errors / current.requests

    if error_rate > 0.02:
        reasons.append(f"error_rate {error_rate:.2%} > 2.00%")
    if current.p95_ms > baseline.p95_ms * 1.30:
        reasons.append(
            f"p95 {current.p95_ms:.1f}ms > {baseline.p95_ms * 1.30:.1f}ms"
        )
    if current.drift_score > 0.20:
        reasons.append(f"drift_score {current.drift_score:.2f} > 0.20")
    if baseline.quality - current.quality > 0.03:
        reasons.append(
            f"quality_drop {baseline.quality - current.quality:.2%} > 3.00%"
        )

    return ("ROLLBACK", reasons) if reasons else ("KEEP", [])

if __name__ == "__main__":
    stable = MetricWindow("v12", 10_000, 40, 100.0, 0.05, 0.93)
    canary = MetricWindow("v13", 1_000, 30, 135.0, 0.26, 0.89)

    decision, reasons = decide(canary, stable)
    print(f"decision={decision}")
    for reason in reasons:
        print(f"reason={reason}")
预期输出:
decision=ROLLBACK
reason=error_rate 3.00% > 2.00%
reason=p95 135.0ms > 130.0ms
reason=drift_score 0.26 > 0.20
reason=quality_drop 4.00% > 3.00%
阈值必须来自历史基线、容量测试和业务容忍度,不能直接照搬示例。自动回滚还应设置最小请求量、连续窗口次数和告警冷却时间,避免少量异常导致版本来回切换。
回滚执行与验证
回滚前先停止继续放量,并确认上一稳定版本及其完整依赖仍可部署。切换完成后,应清理或隔离不兼容缓存,确认特征结构、模型输入和后处理规则一致。
回滚不是以“版本切回”结束。需要重新检查健康探针、错误率、P95、预测分布和关键业务指标,并抽样核对异常请求是否恢复。若服务指标恢复但质量仍异常,应继续排查数据源或上游特征。
发布记录至少保存候选版本、稳定版本、触发时间、触发指标、操作者或自动策略、恢复时间和最终结论。这样才能在复盘时判断是模型问题、数据问题还是基础设施问题。
本课总结
- 模型监控必须同时覆盖服务、数据和预测质量,且所有信号都带版本维度。
- 回滚单元应包含模型及其完整推理依赖,并通过灰度发布控制影响范围。
- 自动回滚需要阈值、样本量、连续窗口和回滚后验证共同约束。
下一课预告
完成部署闭环后,可以进一步建设自动化再训练与持续交付流程,让数据变化、评估结果和发布策略形成可审计的模型生命周期。