
机器学习与深度学习 / 系统课时
混合精度训练
混合精度训练
混合精度训练的目标是在不明显损失模型质量的前提下,让矩阵计算尽量使用低精度,同时把易受数值范围影响的步骤保留为高精度。本课将用 PyTorch 自动混合精度完成一次可运行训练,并掌握梯度缩放、裁剪与异常检查的正确顺序。
学习目标
- 理解 FP32、FP16 在训练中的职责分工
- 使用
autocast与GradScaler编写训练步骤 - 识别溢出、下溢和精度退化的常见信号
自动混合精度的核心机制
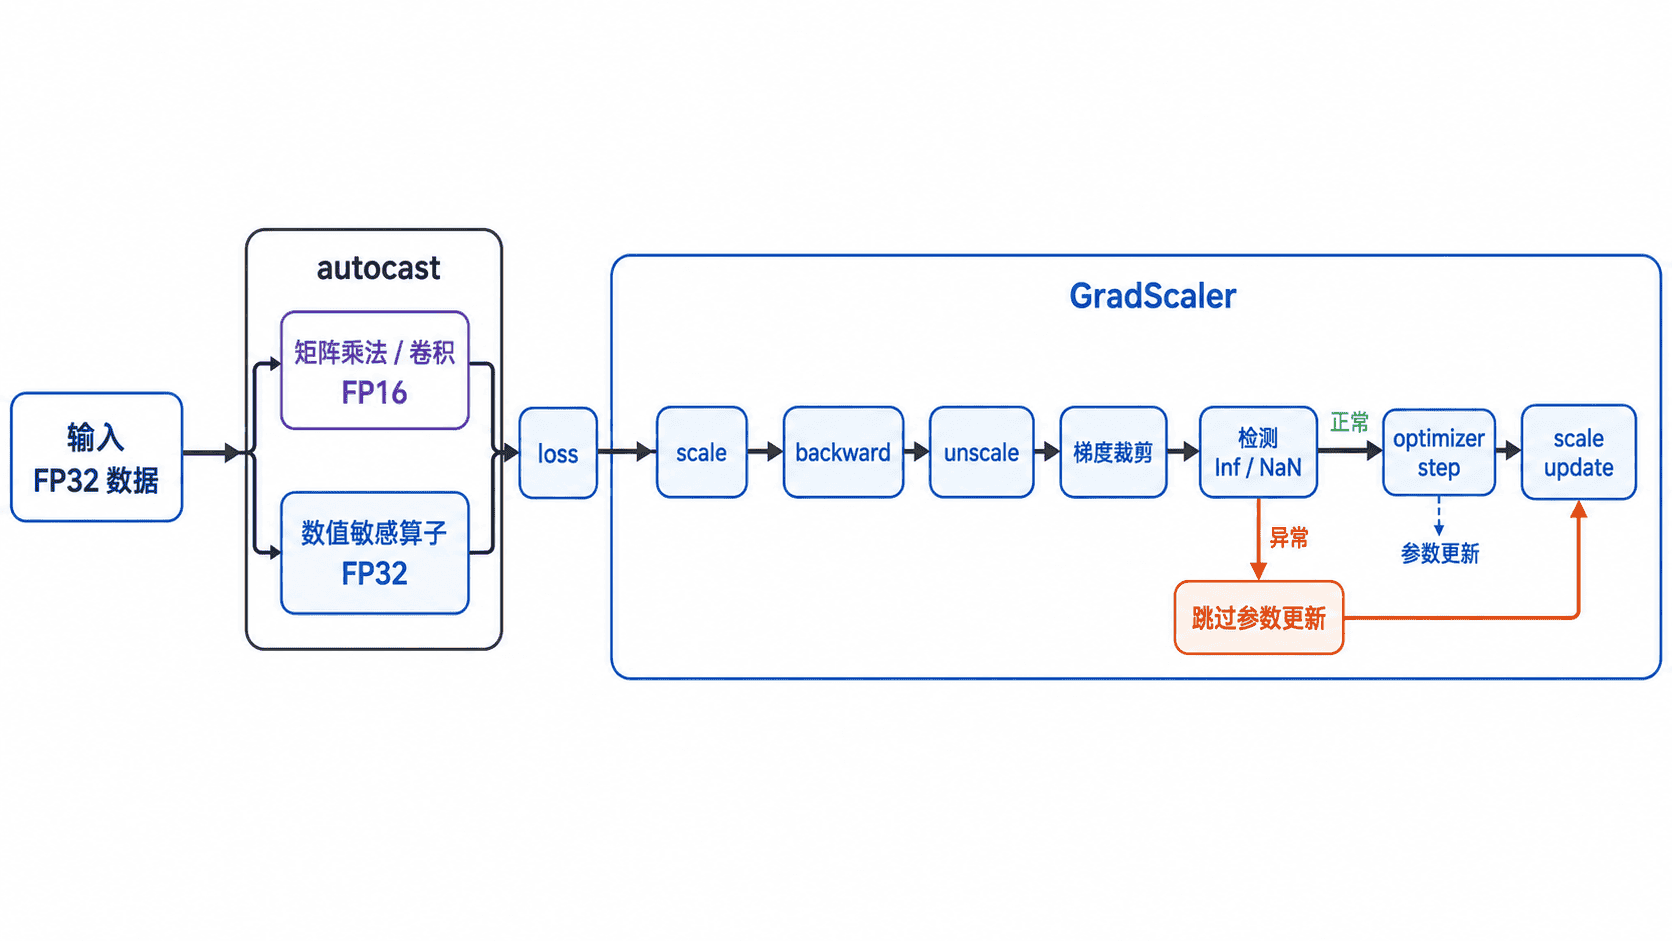
自动混合精度不会把整个模型强制转换成 FP16。进入 autocast 区域后,框架会让适合低精度的矩阵乘法、卷积等算子使用 FP16,并让部分数值敏感算子继续使用 FP32。模型参数通常仍由优化器以 FP32 形式更新。
FP16 的可表示范围较窄,反向传播中的微小梯度可能被舍入为零。GradScaler 会先放大损失,再执行反向传播;更新参数前恢复梯度尺度。如果检测到无穷大或非数值梯度,本次更新会被跳过,并自动调整缩放因子。
用 PyTorch 完成一次 AMP 训练
下面的程序在 CUDA 可用时启用 FP16 混合精度;只有 CPU 时自动退回普通 FP32,因此可以直接运行。梯度裁剪必须放在 unscale_ 之后,否则裁剪到的是被放大后的梯度。
import torch
from torch import nn

torch.manual_seed(7)

device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
use_amp = device.type == "cuda"

model = nn.Sequential(
    nn.Linear(16, 32),
    nn.ReLU(),
    nn.Linear(32, 1),
).to(device)

optimizer = torch.optim.AdamW(model.parameters(), lr=1e-3)
criterion = nn.MSELoss()
scaler = torch.amp.GradScaler("cuda", enabled=use_amp)

# 固定一批数据,便于观察连续更新
features = torch.randn(64, 16, device=device)
targets = features.sum(dim=1, keepdim=True)

for step in range(3):
    optimizer.zero_grad(set_to_none=True)

    # CUDA 上启用 FP16;CPU 环境下该上下文保持关闭
    with torch.autocast(
        device_type=device.type,
        dtype=torch.float16,
        enabled=use_amp,
    ):
        predictions = model(features)
        loss = criterion(predictions, targets)

    scaler.scale(loss).backward()
    scaler.unscale_(optimizer)
    torch.nn.utils.clip_grad_norm_(model.parameters(), max_norm=1.0)
    scaler.step(optimizer)
    scaler.update()

    print(
        f"step={step + 1}, device={device.type}, "
        f"amp={use_amp}, loss={loss.item():.4f}"
)预期输出如下。device、amp 和损失值会随运行环境不同而变化。
step=1, device=<cpu|cuda>, amp=<False|True>, loss=<FLOAT>
step=2, device=<cpu|cuda>, amp=<False|True>, loss=<FLOAT>
step=3, device=<cpu|cuda>, amp=<False|True>, loss=<FLOAT>
数值风险与验证方法
训练速度提升不能只看单步耗时,还要同时比较吞吐量、显存峰值和验证集指标。建议先用同一随机种子分别运行 FP32 与 AMP,记录每秒样本数、最大显存占用和验证损失;只有指标差异在可接受范围内,优化才算有效。
遇到损失突然变成 NaN 时,先检查输入数据和学习率,再观察缩放因子是否持续下降。不要手动把所有层转换为 FP16,也不要在 unscale_ 之前做梯度裁剪。对输出层、归一化或自定义数值敏感算子,可在局部关闭 autocast 并显式使用 FP32。
提示:BF16 的指数范围接近 FP32,通常比 FP16 更不容易发生梯度下溢;是否可用取决于硬件和算子支持。
本课总结
autocast负责按算子选择精度,GradScaler负责降低 FP16 梯度下溢风险- 正确更新顺序是缩放损失、反向传播、恢复梯度、裁剪、更新参数、调整缩放因子
- AMP 是否有效必须通过吞吐量、显存和验证指标共同判断
下一课预告
下一课将继续处理显存不足问题,使用梯度累积模拟更大的有效批量,并通过激活检查点用额外计算换取显存空间。