
机器学习与深度学习 / 系统课时
数值稳定性基础
数值稳定性基础
本课解决“数学公式正确,程序为什么仍会得到 inf、0 或 NaN”的问题。你将认识浮点数的表示边界,掌握对数变换、稳定版 Softmax 与 LogSumExp,并建立可执行的稳定性检查方法。
学习目标
- 区分溢出、下溢和精度损失的典型表现
- 推导减去最大值的稳定版 Softmax
- 使用 LogSumExp、
log1p等方法避免不必要的数值风险
浮点数为何会失真
计算机只能用有限位数表示实数,因此可表示范围和有效精度都有上限。数值超过最大范围会得到 inf,绝对值小于最小可表示范围时可能被舍入为 0,这两种现象分别称为溢出和下溢。
即使结果没有越界,也可能发生精度损失。例如两个非常接近的大数相减时,高位几乎全部抵消,剩下的小差值只保留很少有效数字。这类问题不会总是报错,却可能让梯度、概率或损失逐步偏离预期。
深度学习中最常见的高风险操作包括指数、对数、概率连乘、极小差值相减,以及长序列上的累积求和。
Softmax 的危险位置
Softmax 将 logits 转换为概率:
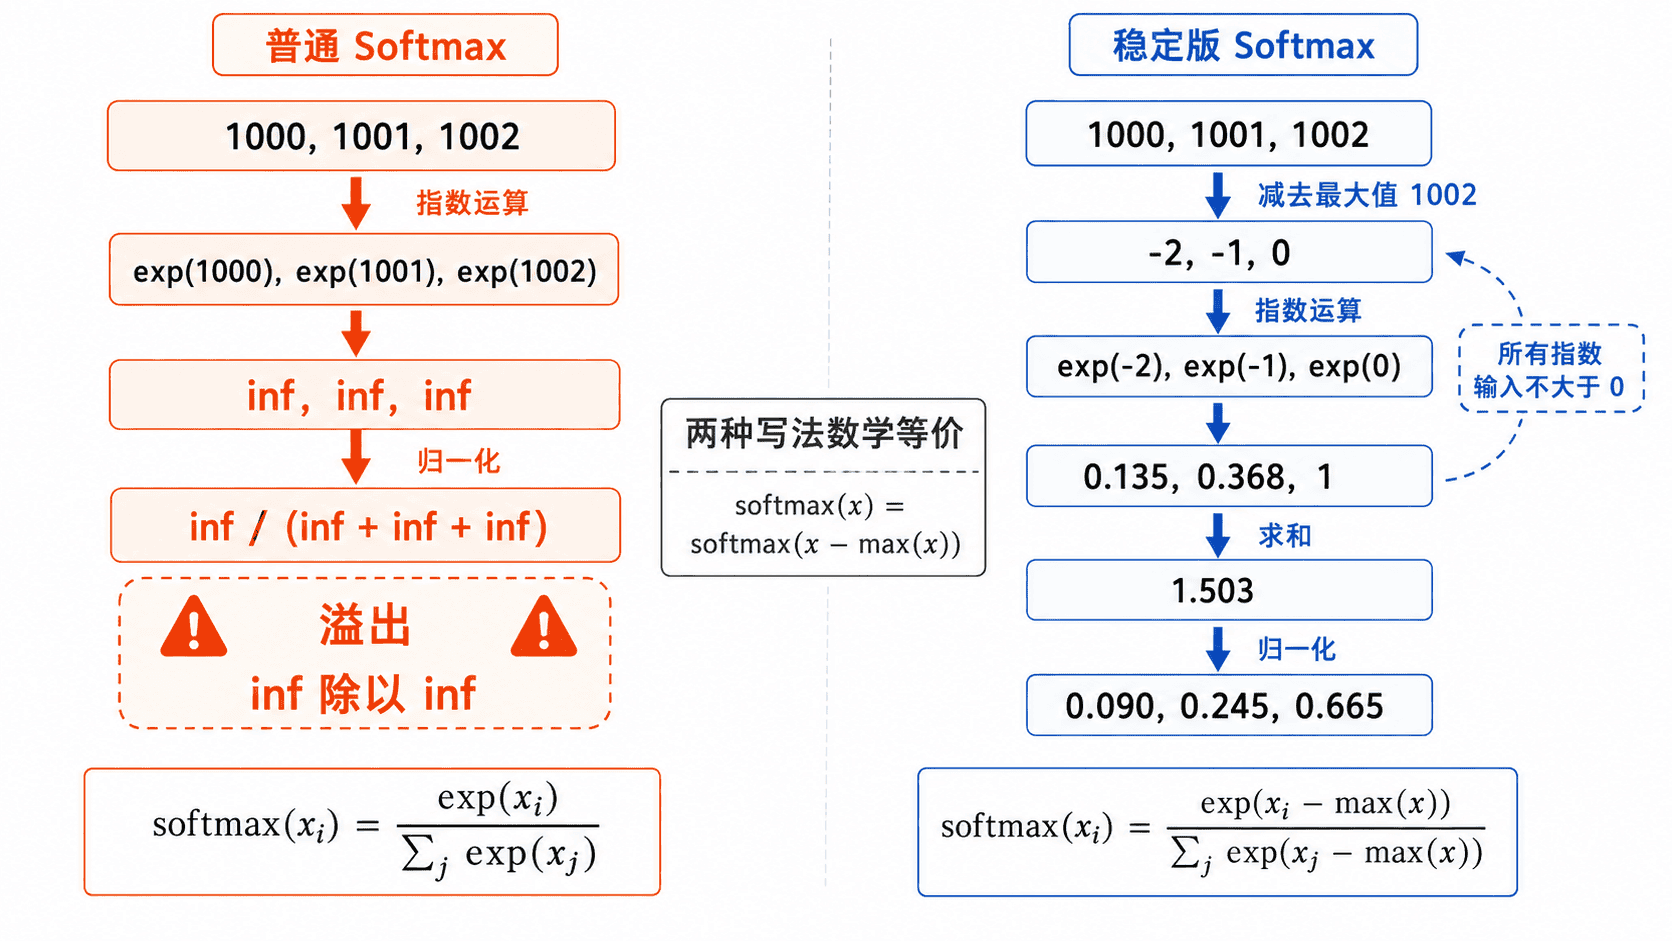
当某个 logit 很大时, 可能先溢出为 inf。分子和分母即使理论上可约分,程序仍可能执行成 inf / inf,最终得到 NaN。
稳定版 Softmax 与 LogSumExp
Softmax 对所有 logits 同时加上或减去同一个常数,结果不变。令 ,则:
减去最大值后,所有指数输入都不大于 0,因此最大指数值为 1,不会发生正向溢出。较小项即使下溢为 0,通常也只表示它们对最终概率的贡献已经小到可忽略。
相同思想可用于稳定计算对数和指数:
这就是 LogSumExp。分类损失中常用的 log_softmax 会把 Softmax 和取对数合并计算,避免先得到极小概率再执行 log。因此应优先调用框架提供的稳定实现,而不是手写 log(softmax(x))。
用代码观察溢出与稳定结果
下面的示例先尝试直接计算大 logits 的 Softmax,再使用减去最大值的方法得到稳定结果,同时演示极小指数的下溢。
import math

def stable_softmax(values):
    maximum = max(values)
    shifted = [value - maximum for value in values]
    exponentials = [math.exp(value) for value in shifted]
    total = sum(exponentials)
    return [value / total for value in exponentials]

logits = [1000.0, 1001.0, 1002.0]

# 直接指数化会在常见双精度浮点环境中溢出
try:
    raw = [math.exp(value) for value in logits]
    naive = [value / sum(raw) for value in raw]
    print("naive softmax:", naive)
except OverflowError:
    print("naive softmax: overflow")

stable = stable_softmax(logits)
maximum = max(logits)
log_sum_exp = maximum + math.log(
    sum(math.exp(value - maximum) for value in logits)
)

print("stable softmax:", [round(value, 6) for value in stable])
print("probability sum:", round(sum(stable), 6))
print("logsumexp:", round(log_sum_exp, 6))
print("exp(-1000):", math.exp(-1000.0))
预期输出
naive softmax: overflow
stable softmax: [0.090031, 0.244728, 0.665241]
probability sum: 1.0
logsumexp: 1002.407606
exp(-1000): 0.0
exp(-1000) 下溢为 0,但稳定 Softmax 仍能得到合法概率分布。关键不是消除所有舍入,而是避免中间步骤进入无穷大、非法值或不必要的极端范围。
其他常用稳定技巧
概率连乘应改写为对数求和。原本的 很容易下溢,而 保留了更多有效信息,也更适合优化。
计算 时,若 很小,应使用 log1p(x);计算 时,应使用 expm1(x)。这些函数专门减少接近 0 时的消减误差。
添加极小常数 可以避免除以 0 或 log(0),但不能无条件乱加。常数过大会改变目标函数,过小又可能没有实际作用,应优先采用稳定公式和框架原语,再把 作为明确的边界保护。
如何验证计算是否稳定
先检查中间结果是否包含 NaN 或 inf,再检查概率是否位于 且总和接近 1。对于可平移的公式,可在中等数值范围内比较普通写法与稳定写法,确认结果一致。
最后观察输入尺度。若 logits、梯度或权重持续快速增大,单纯替换公式只能缓解症状,还应检查学习率、初始化、归一化和梯度裁剪等训练设置。
本课总结
- 溢出、下溢和消减误差来自浮点数范围与精度限制
- Softmax 减去最大 logit 后与原公式等价,但能避免指数溢出
- 优先使用 LogSumExp、LogSoftmax、
log1p等稳定原语,而不是事后修补NaN
下一课预告
下一课将进入梯度与优化相关内容,学习这些稳定计算如何影响反向传播和参数更新。