
机器学习与深度学习 / 系统课时
梯度累积与检查点
梯度累积与检查点
当单个批次无法放入显存时,可以把大批量拆成多个微批次累计梯度,再统一更新参数;如果中间激活仍占用过多显存,还可以在反向传播时重新计算部分前向结果。本课将把两种方法组合成可运行训练代码,并说明它们各自节省什么资源。
学习目标
- 用梯度累积得到正确的有效批量
- 使用激活检查点降低中间激活占用
- 判断两种方法的性能代价和适用边界
两种策略分别解决什么问题
梯度累积把一个有效批量拆成多个微批量。每个微批量都执行前向与反向传播,但在达到指定次数前不调用 optimizer.step()。若微批量为 8、累积 4 次、使用 2 个设备,则有效批量为 64。
激活检查点只保存少量边界张量,反向传播需要中间激活时再执行一次对应前向计算。它主要减少深层网络的激活显存,不会减少参数、梯度或优化器状态。这里的“检查点”指 activation checkpointing,不是保存模型权重文件。
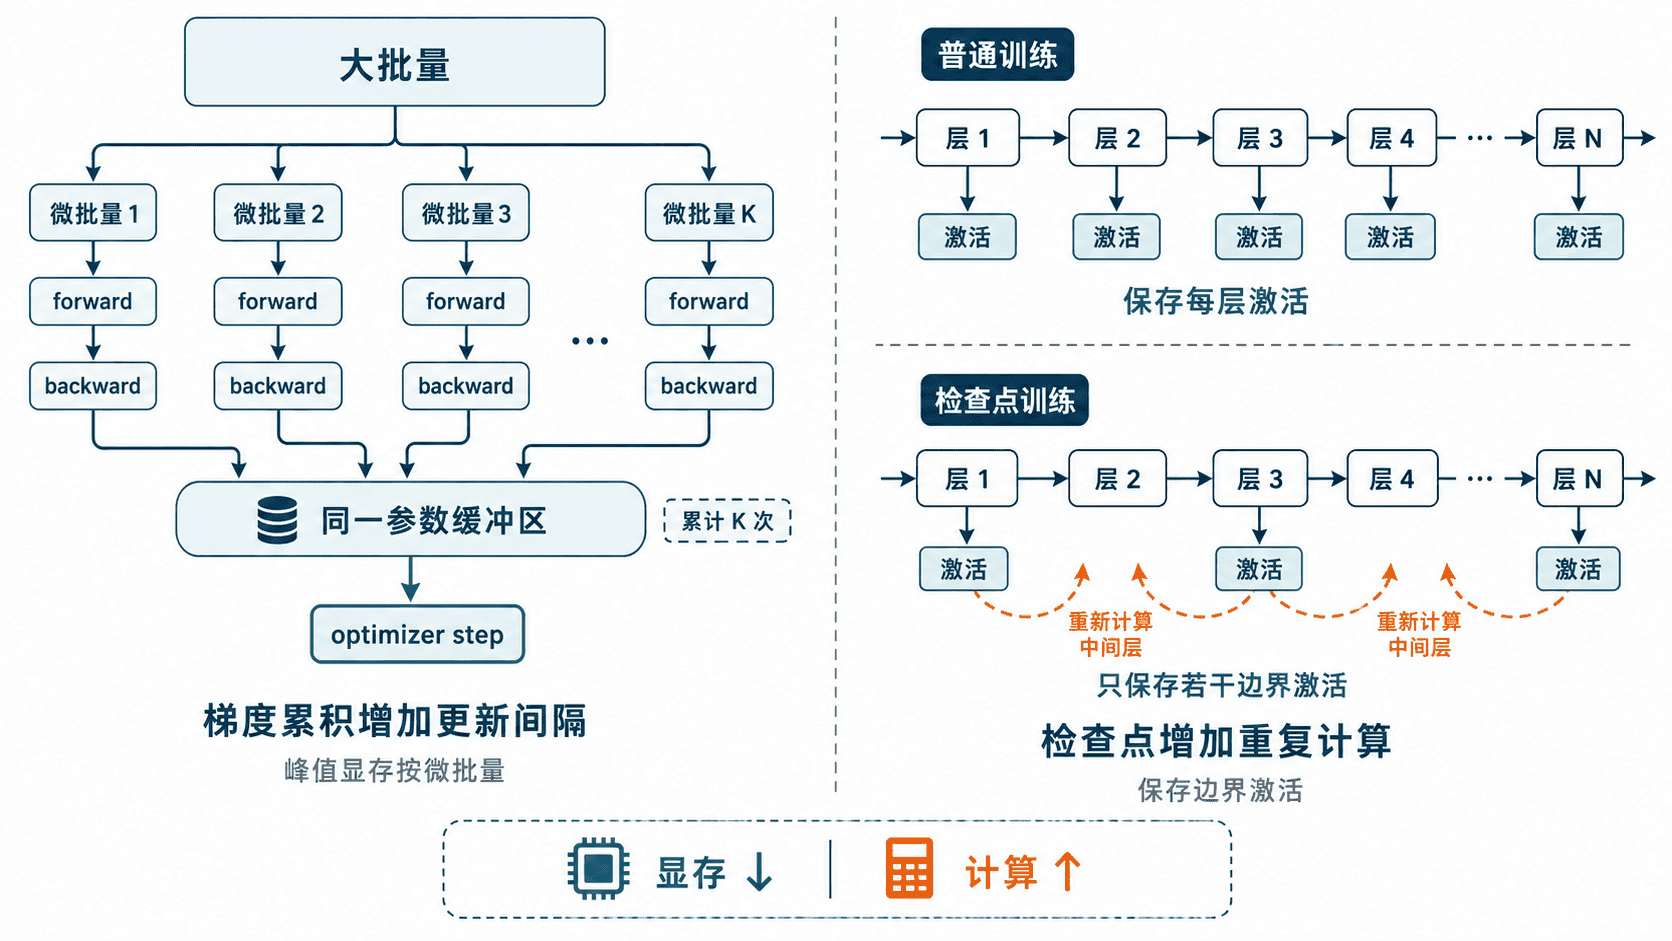
组合实现梯度累积与激活检查点
下面的示例包含 4 个微批量,每累计 2 次梯度更新一次参数,因此总共执行 2 次优化器更新。损失必须除以累积步数,否则累计后的梯度会被额外放大。
import torch
from torch import nn
from torch.utils.checkpoint import checkpoint
from torch.utils.data import DataLoader, TensorDataset

torch.manual_seed(7)

device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
micro_batch_size = 8
accumulation_steps = 2

features = torch.randn(32, 128)
labels = torch.randint(0, 4, (32,))
loader = DataLoader(
    TensorDataset(features, labels),
    batch_size=micro_batch_size,
    shuffle=False,
)

class CheckpointMLP(nn.Module):
    def __init__(self) -> None:
        super().__init__()
        self.input_layer = nn.Linear(128, 256)
        self.blocks = nn.ModuleList(
            [
                nn.Sequential(
                    nn.Linear(256, 256),
                    nn.ReLU(),
                    nn.Linear(256, 256),
                    nn.ReLU(),
                )
                for _ in range(3)
            ]
        )
        self.output_layer = nn.Linear(256, 4)

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        x = torch.relu(self.input_layer(x))

        # 反向传播时重算每个块的内部激活
        for block in self.blocks:
            x = checkpoint(block, x, use_reentrant=False)

        return self.output_layer(x)

model = CheckpointMLP().to(device)
criterion = nn.CrossEntropyLoss()
optimizer = torch.optim.AdamW(model.parameters(), lr=1e-3)

assert len(loader) % accumulation_steps == 0
optimizer.zero_grad(set_to_none=True)

optimizer_step = 0
group_loss = 0.0

for batch_index, (batch_x, batch_y) in enumerate(loader, start=1):
    batch_x = batch_x.to(device)
    batch_y = batch_y.to(device)

    logits = model(batch_x)
    raw_loss = criterion(logits, batch_y)

    # 除以累积步数,使累计梯度等价于大批量的平均损失
    (raw_loss / accumulation_steps).backward()
    group_loss += raw_loss.item()

    if batch_index % accumulation_steps == 0:
        torch.nn.utils.clip_grad_norm_(model.parameters(), max_norm=1.0)
        optimizer.step()
        optimizer.zero_grad(set_to_none=True)

        optimizer_step += 1
        mean_loss = group_loss / accumulation_steps
        print(
            f"optimizer_step={optimizer_step}, "
            f"micro_batches={batch_index}, mean_loss={mean_loss:.4f}"
        )
        group_loss = 0.0
预期输出如下。损失值会因设备和运行环境不同而略有变化。
optimizer_step=1, micro_batches=2, mean_loss=<FLOAT>
optimizer_step=2, micro_batches=4, mean_loss=<FLOAT>
参数选择与边界处理
累积步数越大,单次参数更新间隔越长,训练吞吐量不一定线性提升。学习率应根据有效批量和验证结果调整,而不是机械按倍数放大。使用分布式训练时,还要把设备数量计入有效批量,并避免每个微批量都触发不必要的梯度同步。
示例通过断言要求微批量数量能被累积步数整除。实际项目若最后一组不足,应按该组真实微批量数缩放损失,或在数据加载阶段丢弃不足批次。否则最后一次梯度会偏小。
激活检查点适合层数较深、激活占比高且允许增加计算时间的模型。包含随机操作的模块需要确认重算时的随机状态一致;同时应分别测量峰值显存和每步耗时,避免显存下降但整体训练时间不可接受。
本课总结
- 梯度累积减少单次微批量显存,但不会减少一次参数更新所需的样本总量
- 激活检查点通过反向阶段重算前向结果,主要节省中间激活显存
- 两种方法可以组合,但必须正确缩放损失并评估额外计算成本
下一课预告
下一课将从完整训练任务出发,结合性能分析结果选择批量、精度和检查点策略,并建立可重复的资源优化基线。