
机器学习与深度学习 / 系统课时
完成生产级综合项目
完成生产级综合项目
本课把数据准备、模型训练、评估、实验记录、模型导出和在线部署串成一条可验收链路。你将交付一个能重复训练、生成制品、启动推理接口并通过容器运行的最小生产级 PyTorch 项目。
学习目标
- 建立训练、评估、实验记录和模型制品之间的完整交付链路
- 使用 TorchScript 导出模型,并通过 FastAPI 提供稳定的推理接口
- 通过容器化、健康检查和验收请求发现常见生产故障
交付目标与项目结构
本项目解决一个八维特征的二分类问题。训练程序生成示例数据,只用训练集统计量完成标准化,记录每轮指标,保存最佳模型,并导出推理所需的全部元数据。服务进程只读取制品,不重新训练。
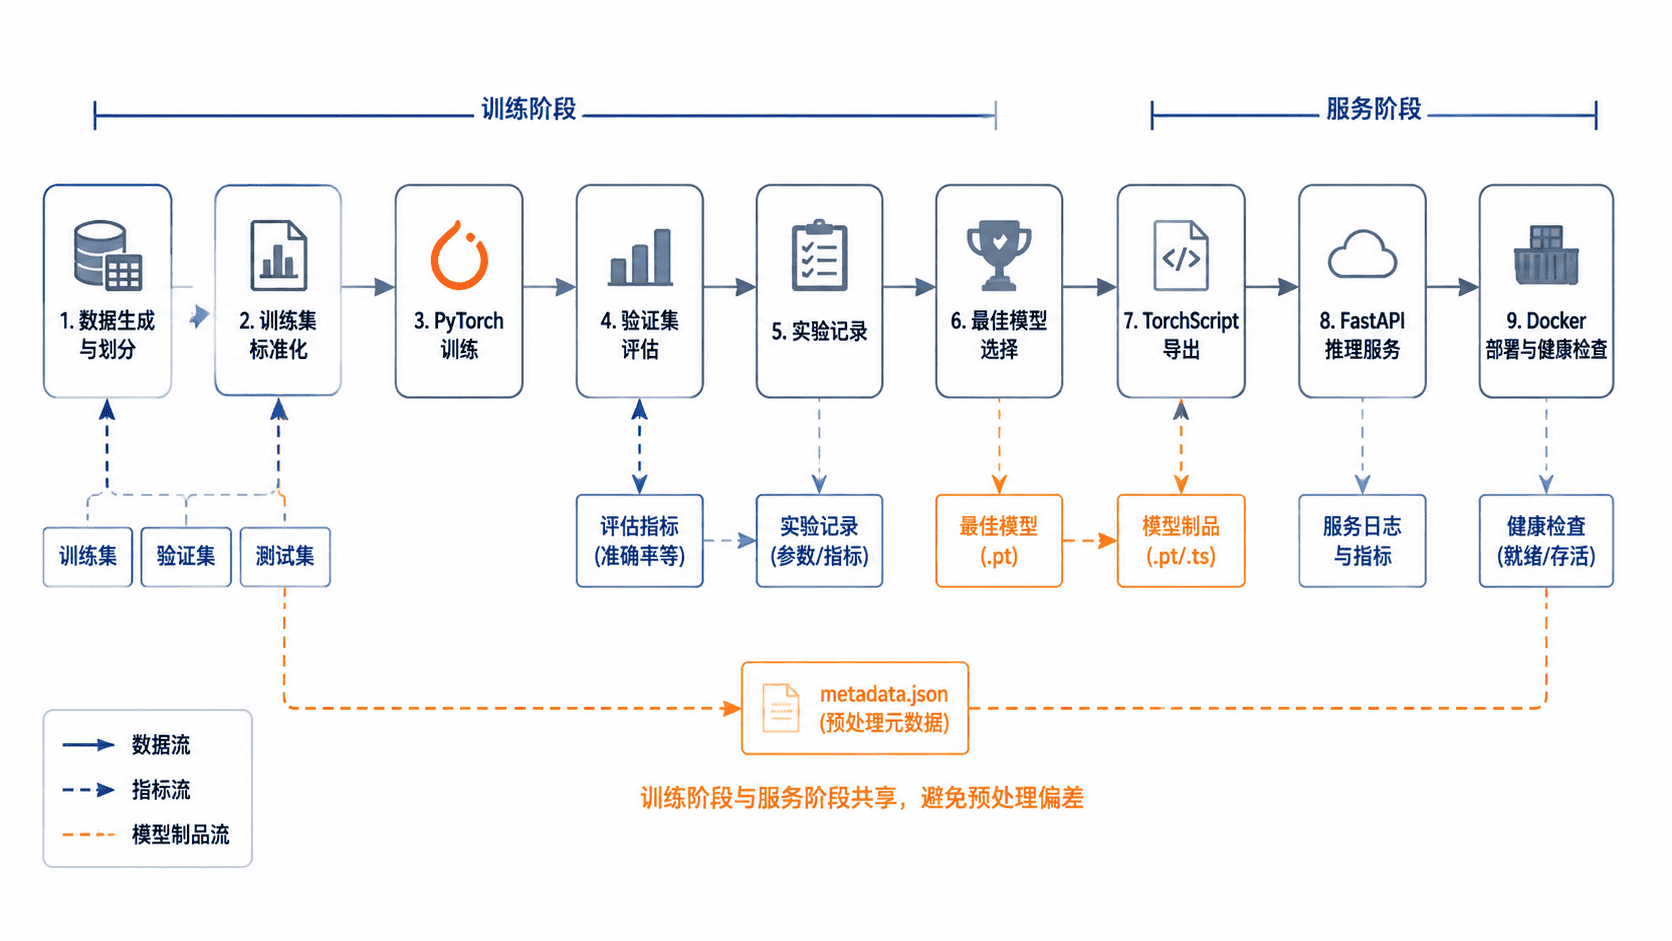
建议目录如下。artifacts 是部署输入,runs 保存每次实验的参数和逐轮指标,两者职责必须分开。
pytorch-production/
├── requirements.txt
├── train_export.py
├── app.py
├── Dockerfile
├── artifacts/
└── runs/
依赖文件使用兼容范围便于演示,真实项目应在验证通过后生成锁定文件。
torch>=2.2,<3
numpy>=1.26,<3
scikit-learn>=1.4,<2
fastapi>=0.110,<1
uvicorn[standard]>=0.27,<1
安装命令如下。
python -m pip install -r requirements.txt预期输出如下,具体版本号和下载日志会因环境而异。
Successfully installed <PACKAGE_LIST>训练、评估与实验记录
下面的完整程序固定随机种子,划分训练集和验证集,只用训练集均值与标准差处理两部分数据。每轮指标写入 JSON Lines,验证准确率提升时保存最佳参数,最后同时导出 TorchScript 模型和推理元数据。
import copy
import json
import random
from datetime import datetime, timezone
from pathlib import Path

import numpy as np
import torch
from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split
from torch import nn
from torch.utils.data import DataLoader, TensorDataset

SEED = 42
FEATURE_COUNT = 8
EPOCHS = 30
BATCH_SIZE = 64

random.seed(SEED)
np.random.seed(SEED)
torch.manual_seed(SEED)

run_id = datetime.now(timezone.utc).strftime("%Y%m%dT%H%M%SZ")
run_dir = Path("runs") / run_id
artifact_dir = Path("artifacts")
run_dir.mkdir(parents=True, exist_ok=True)
artifact_dir.mkdir(parents=True, exist_ok=True)

# 生成可重复的示例数据,并保持类别比例一致地划分数据集。
features, labels = make_classification(
    n_samples=2000,
    n_features=FEATURE_COUNT,
    n_informative=6,
    n_redundant=2,
    random_state=SEED,
)
x_train, x_val, y_train, y_val = train_test_split(
    features,
    labels,
    test_size=0.2,
    random_state=SEED,
    stratify=labels,
)

# 预处理统计量只能来自训练集,避免把验证集信息泄漏到训练过程。
mean = x_train.mean(axis=0)
std = np.where(x_train.std(axis=0) == 0, 1.0, x_train.std(axis=0))
x_train = ((x_train - mean) / std).astype(np.float32)
x_val = ((x_val - mean) / std).astype(np.float32)

train_loader = DataLoader(
    TensorDataset(torch.from_numpy(x_train), torch.from_numpy(y_train).long()),
    batch_size=BATCH_SIZE,
    shuffle=True,
)
x_val_tensor = torch.from_numpy(x_val)
y_val_tensor = torch.from_numpy(y_val).long()

model = nn.Sequential(
    nn.Linear(FEATURE_COUNT, 32),
    nn.ReLU(),
    nn.Dropout(0.1),
    nn.Linear(32, 2),
)
optimizer = torch.optim.AdamW(model.parameters(), lr=1e-3)
criterion = nn.CrossEntropyLoss()

run_config = {
    "run_id": run_id,
    "seed": SEED,
    "epochs": EPOCHS,
    "batch_size": BATCH_SIZE,
    "feature_count": FEATURE_COUNT,
}
(run_dir / "run.json").write_text(
    json.dumps(run_config, ensure_ascii=False, indent=2),
    encoding="utf-8",
)

best_accuracy = -1.0
best_state = None
metrics_path = run_dir / "metrics.jsonl"

for epoch in range(1, EPOCHS + 1):
    model.train()
    total_loss = 0.0

    for batch_x, batch_y in train_loader:
        optimizer.zero_grad()
        logits = model(batch_x)
        loss = criterion(logits, batch_y)
        loss.backward()
        optimizer.step()
        total_loss += loss.item() * batch_x.size(0)

    model.eval()
    with torch.inference_mode():
        val_logits = model(x_val_tensor)
        val_accuracy = (
            val_logits.argmax(dim=1).eq(y_val_tensor).float().mean().item()
        )

    epoch_metrics = {
        "epoch": epoch,
        "train_loss": total_loss / len(train_loader.dataset),
        "val_accuracy": val_accuracy,
    }
    with metrics_path.open("a", encoding="utf-8") as file:
        file.write(json.dumps(epoch_metrics) + "\n")

    # 最佳模型按验证集指标选择,避免部署最后一轮但性能更差的参数。
    if val_accuracy > best_accuracy:
        best_accuracy = val_accuracy
        best_state = copy.deepcopy(model.state_dict())

if best_state is None:
    raise RuntimeError("训练未产生可导出的最佳模型")

model.load_state_dict(best_state)
model.eval()
scripted_model = torch.jit.script(model)
scripted_model.save(str(artifact_dir / "model.ts"))

metadata = {
    "feature_count": FEATURE_COUNT,
    "mean": mean.tolist(),
    "std": std.tolist(),
    "labels": ["negative", "positive"],
    "best_val_accuracy": best_accuracy,
    "run_id": run_id,
}
(artifact_dir / "metadata.json").write_text(
    json.dumps(metadata, ensure_ascii=False, indent=2),
    encoding="utf-8",
)

print(f"run_id={run_id}")
print(f"best_val_accuracy={best_accuracy:.4f}")
print("artifacts=artifacts/model.ts,artifacts/metadata.json")
运行训练与导出。
python train_export.py预期输出如下。<ID> 和 <ACCURACY> 是动态值,实际结果可能因运行环境和底层算子实现略有不同。
run_id=<ID>
best_val_accuracy=<ACCURACY>
artifacts=artifacts/model.ts,artifacts/metadata.json
验收时必须确认 runs/<ID>/run.json、runs/<ID>/metrics.jsonl、artifacts/model.ts 和 artifacts/metadata.json 同时存在。只有模型文件而没有标准化参数,服务虽然能启动,也会产生训练与推理不一致。
导出与在线推理
服务启动时一次性加载模型和元数据。请求到达后先检查特征数量,再复用训练阶段的均值与标准差,最后返回类别和概率。这样可避免在线接口悄悄接受错误维度的数据。
import json
import os
from pathlib import Path

import torch
from fastapi import FastAPI, HTTPException
from pydantic import BaseModel

model_dir = Path(os.getenv("MODEL_DIR", "artifacts"))
metadata = json.loads(
    (model_dir / "metadata.json").read_text(encoding="utf-8")
)
model = torch.jit.load(str(model_dir / "model.ts"), map_location="cpu")
model.eval()

feature_count = int(metadata["feature_count"])
mean = torch.tensor(metadata["mean"], dtype=torch.float32)
std = torch.tensor(metadata["std"], dtype=torch.float32)
labels = metadata["labels"]

app = FastAPI(title="PyTorch Production Service")

class PredictRequest(BaseModel):
    features: list[float]

@app.get("/health")
def health() -> dict[str, str]:
    return {"status": "ok", "run_id": metadata["run_id"]}

@app.post("/predict")
def predict(request: PredictRequest) -> dict:
    if len(request.features) != feature_count:
        raise HTTPException(
            status_code=422,
            detail=f"features must contain {feature_count} values",
        )

    raw = torch.tensor(request.features, dtype=torch.float32)
    normalized = (raw - mean) / std

    with torch.inference_mode():
        probabilities = torch.softmax(model(normalized.unsqueeze(0)), dim=1)[0]

    index = int(probabilities.argmax().item())
    return {
        "label": labels[index],
        "probabilities": {
            labels[i]: round(float(probabilities[i].item()), 6)
            for i in range(len(labels))
        },
    }
启动服务。
uvicorn app:app --host 0.0.0.0 --port 8000预期输出如下。日志中的进程号可能不同。
INFO:     Started server process [<ID>]
INFO:     Application startup complete.
INFO:     Uvicorn running on http://0.0.0.0:8000
另开终端执行健康检查、合法推理和错误维度请求。
curl -s -i http://127.0.0.1:8000/health
curl -s -i -X POST http://127.0.0.1:8000/predict \
  -H "Content-Type: application/json" \
  -d '{"features":[0.2,-1.1,0.4,0.8,-0.3,1.2,0.1,-0.7]}'
curl -s -i -X POST http://127.0.0.1:8000/predict \
  -H "Content-Type: application/json" \
-d '{"features":[0.2]}'预期结果依次为健康检查成功、推理成功和维度校验失败。<ID>、<LABEL> 与 <FLOAT> 由本次模型制品动态决定。
HTTP/1.1 200 OK
{"status":"ok","run_id":"<ID>"}
HTTP/1.1 200 OK
{"label":"<LABEL>","probabilities":{"negative":<FLOAT>,"positive":<FLOAT>}}
HTTP/1.1 422 Unprocessable Entity
{"detail":"features must contain 8 values"}
部署、验收与故障边界
容器镜像只携带推理代码和已审核制品,不在启动时重新训练。这样部署失败可以直接归因于镜像、制品或运行环境,而不是训练过程。
FROM python:3.12-slim

WORKDIR /app
COPY requirements.txt .
RUN python -m pip install --no-cache-dir -r requirements.txt

COPY app.py .
COPY artifacts ./artifacts

EXPOSE 8000
CMD ["uvicorn", "app:app", "--host", "0.0.0.0", "--port", "8000"]
构建并运行镜像。
docker build -t pytorch-production:1.0 . && echo "image_build=ok"
docker run --rm -p 8000:8000 pytorch-production:1.0
预期输出包含主动打印的构建成功标记和 Uvicorn 启动信息。
image_build=ok
INFO:     Uvicorn running on http://0.0.0.0:8000
上线前按顺序验证:训练记录可追溯、最佳指标已写入元数据、模型与元数据来自同一个 run_id、健康检查返回 200、合法请求返回两个概率且总和约为 1、错误特征数量返回 422。
常见故障通常集中在三类。容器启动即退出,多半是 model.ts 或 metadata.json 缺失;接口持续返回 422,应检查客户端特征顺序和数量;离线准确率正常但线上结果异常,应优先比较训练与服务使用的均值、标准差、标签顺序和模型版本,而不是立即重新训练。