
机器学习与深度学习 / 系统课时
完成图像分类项目
完成图像分类项目
本课把图像分类所需的数据加载、卷积网络、训练、验证和单图推理合并为一个可运行脚本。完成后,你将拥有一条可验证的最小闭环,并知道如何替换为自己的真实图片数据。
学习目标
- 能组织图像分类项目的完整执行链路。
- 能完成模型训练、验证与单张图片推理。
- 能根据验收结果判断项目是否真正跑通。
明确项目验收链路
一个完整项目至少要闭合五个环节:数据能被批量读取,模型输出类别 logits,损失可以反向传播,验证集能计算准确率,保存或读取的单张图片能够得到类别与置信度。
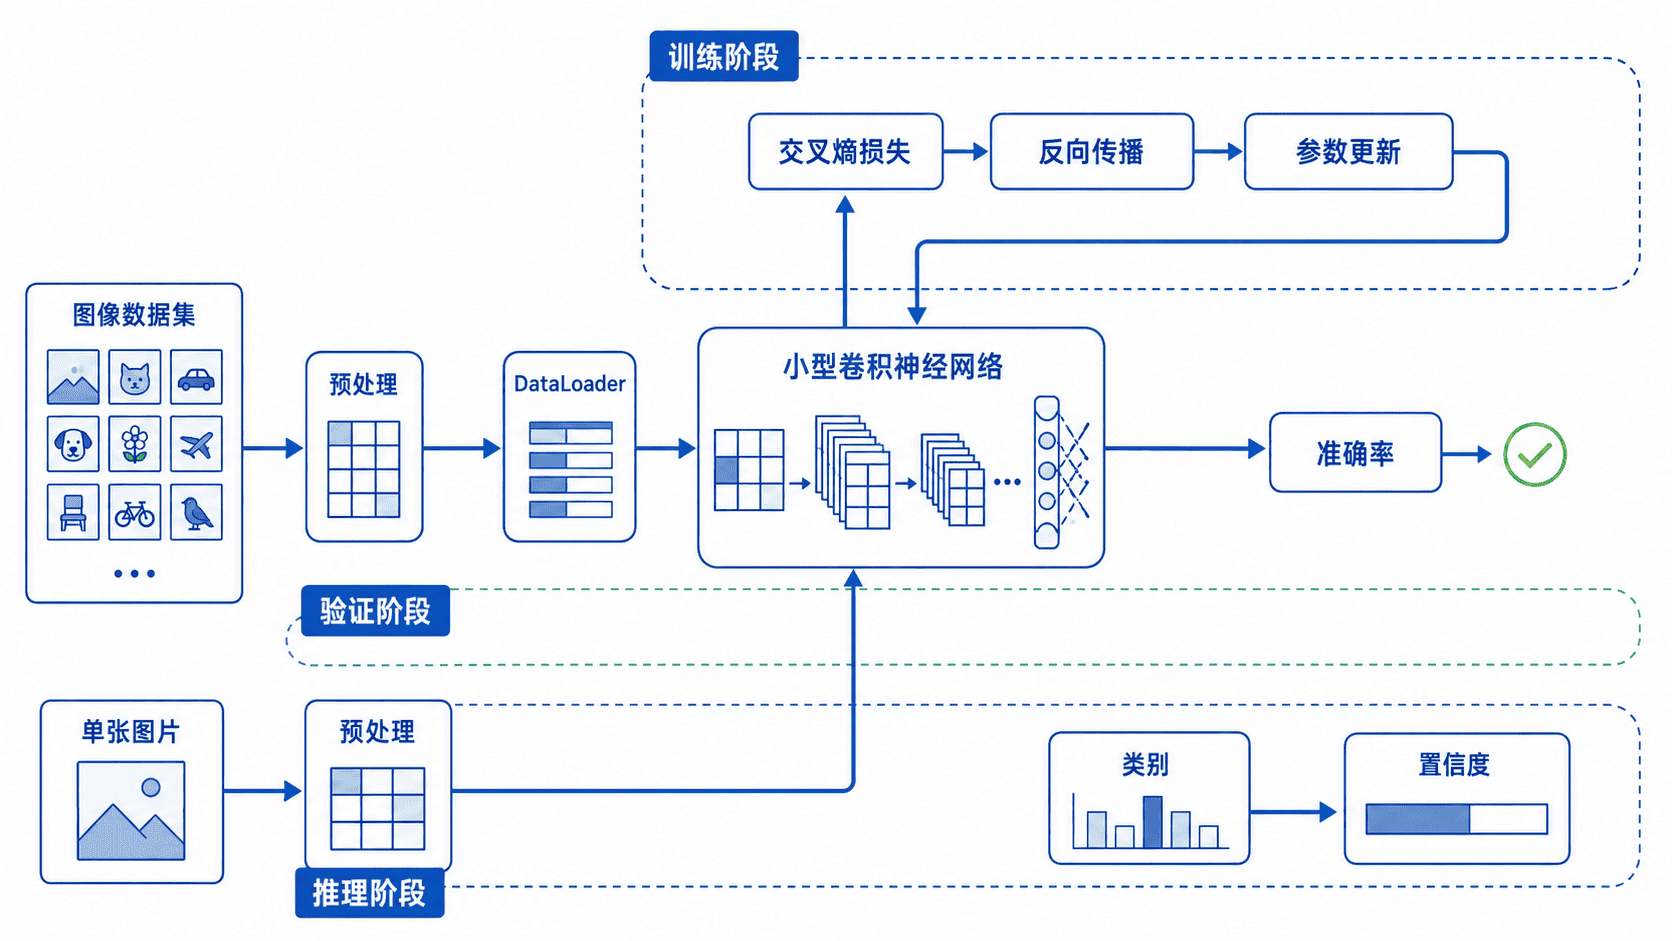
本课使用 FakeData 构造三分类图片,因此无需下载数据即可验证代码。它只能证明工程链路正确,不能代表模型具备真实识别能力;接入自己的数据后,才需要关注准确率和泛化能力。
实现端到端最小项目
将下面代码保存为 image_classification.py 后运行。脚本固定随机种子,生成训练集与验证集,训练两轮小型 CNN,再把一张验证图片保存为文件并重新读取,完成单图推理。
import torch
from PIL import Image
from torch import nn
from torch.utils.data import DataLoader, random_split
from torchvision import datasets, transforms

torch.manual_seed(7)

preprocess = transforms.Compose([
    transforms.Resize((32, 32)),
    transforms.ToTensor(),
])

dataset = datasets.FakeData(
    size=96,
    image_size=(3, 32, 32),
    num_classes=3,
    transform=preprocess,
    random_offset=7,
)
train_dataset, val_dataset = random_split(
    dataset,
    [72, 24],
    generator=torch.Generator().manual_seed(7),
)
train_loader = DataLoader(
    train_dataset,
    batch_size=16,
    shuffle=True,
)
val_loader = DataLoader(
    val_dataset,
    batch_size=16,
)

class SmallCNN(nn.Module):
    def __init__(self, num_classes: int) -> None:
        super().__init__()
        self.features = nn.Sequential(
            nn.Conv2d(3, 16, kernel_size=3, padding=1),
            nn.ReLU(),
            nn.MaxPool2d(2),
            nn.Conv2d(16, 32, kernel_size=3, padding=1),
            nn.ReLU(),
            nn.MaxPool2d(2),
            nn.AdaptiveAvgPool2d((1, 1)),
        )
        self.classifier = nn.Linear(32, num_classes)

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        x = self.features(x)
        return self.classifier(x.flatten(1))

device = torch.device('cpu')
model = SmallCNN(num_classes=3).to(device)
criterion = nn.CrossEntropyLoss()
optimizer = torch.optim.Adam(
    model.parameters(),
    lr=1e-3,
)

for epoch in range(1, 3):
    model.train()
    loss_sum = 0.0

    for images, labels in train_loader:
        images = images.to(device)
        labels = labels.to(device)

        optimizer.zero_grad()
        logits = model(images)
        loss = criterion(logits, labels)
        loss.backward()
        optimizer.step()

        loss_sum += loss.item() * images.size(0)

    # 验证阶段关闭梯度,并按样本数统计准确率。
    model.eval()
    correct = 0
    total = 0

    with torch.inference_mode():
        for images, labels in val_loader:
            logits = model(images.to(device))
            predictions = logits.argmax(dim=1).cpu()
            correct += (predictions == labels).sum().item()
            total += labels.size(0)

    print(
        f'epoch {epoch}: '
        f'train_loss={loss_sum / len(train_dataset):.4f}, '
        f'val_accuracy={correct / total:.2%}'
    )

# 将验证样本写入文件,再走一次真实的图片读取路径。
sample_tensor, _ = val_dataset[0]
transforms.ToPILImage()(sample_tensor).save('sample.png')

model.eval()
with Image.open('sample.png').convert('RGB') as image:
    input_tensor = preprocess(image).unsqueeze(0).to(device)

with torch.inference_mode():
    probabilities = model(input_tensor).softmax(dim=1)[0]

predicted_class = probabilities.argmax().item()
print(
    f'single prediction: class={predicted_class}, '
    f'confidence={probabilities[predicted_class].item():.2%}'
)
预期输出如下。不同 PyTorch 版本或硬件可能造成轻微浮点差异,实际损失、准确率和置信度以本机结果为准。
epoch 1: train_loss=<LOSS>, val_accuracy=<ACCURACY>
epoch 2: train_loss=<LOSS>, val_accuracy=<ACCURACY>
single prediction: class=<CLASS_ID>, confidence=<CONFIDENCE>
运行结束后,当前目录还会生成 sample.png。只要两轮训练均正常输出、验证准确率能够计算、单图推理返回类别编号和置信度,就说明数据、模型、训练与推理链路已经闭合。
迁移到真实数据并验收
真实数据可按“根目录/类别名/图片文件”的方式组织,每个类别对应一个子目录。随后将 FakeData 替换为 datasets.ImageFolder(root='<PATH>', transform=preprocess),并根据类别数修改 SmallCNN(num_classes=...)。
训练集和验证集必须保持相同的尺寸、归一化与颜色通道处理。推理时也必须复用同一套预处理,否则即使代码能够运行,输入分布不一致仍会显著降低预测质量。
项目验收时应依次确认:批次形状为 [N, 3, H, W],损失能够下降,验证指标按完整样本数统计,推理前调用 model.eval(),推理过程使用 torch.inference_mode(),输出类别顺序与数据集的类别索引一致。
若损失不变化,先检查标签范围和优化器是否执行;若训练准确率高而验证准确率低,优先检查过拟合与数据划分;若单图推理结果异常,重点核对颜色模式、尺寸、归一化和类别映射。