
机器学习与深度学习 / 系统课时
使用 DataLoader
使用 DataLoader
DataLoader 将数据集转换为可以逐批迭代的数据流。本课将配置批量大小、样本打乱、并行加载和尾批处理,并通过一个可运行示例验证每轮实际产生的批次数与样本数。
学习目标
- 理解
DataLoader在数据集与训练循环之间的作用 - 正确配置
batch_size、shuffle、num_workers和drop_last - 根据训练、验证和运行环境选择合适的加载参数
DataLoader 负责什么
Dataset 解决“如何按索引取得一个样本”,DataLoader 则负责“如何把多个样本组织成一批并持续提供给模型”。训练循环通常不直接访问数据集索引,而是从加载器中取得特征批次和标签批次。
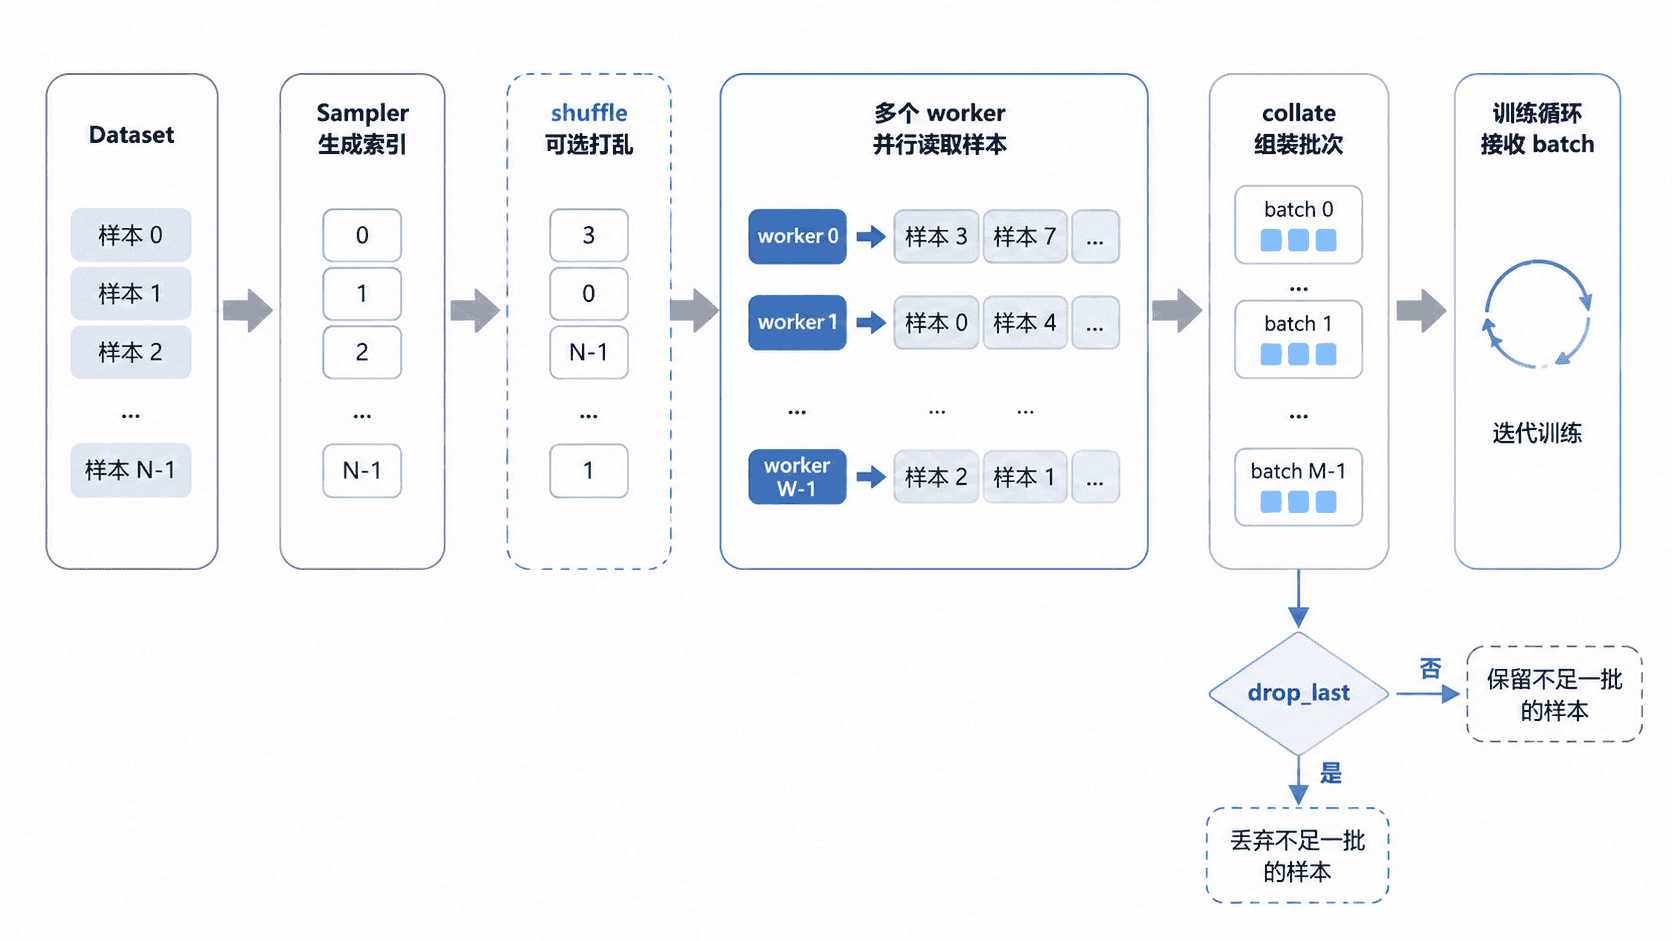
一次迭代大致经历样本索引生成、可选打乱、样本读取、批量拼接和结果返回。启用多个工作进程后,样本读取还可以与模型计算部分重叠,从而减少等待数据的时间。
四个核心参数
batch_size 表示每批包含多少个样本。较大的批量通常能提高设备利用率,但会占用更多内存;较小的批量更新参数更频繁,却可能增加每轮训练的调度开销。
shuffle=True 会在每轮迭代前重新打乱样本顺序,通常用于训练集,避免模型持续看到固定顺序。验证集和测试集一般使用 shuffle=False,便于复现实验和对应预测结果。
num_workers 表示负责读取数据的子进程数量。设为 0 时由主进程加载,最容易调试;设为 2、4 等正整数时可以并行读取,但最佳值需要结合 CPU、磁盘速度和样本预处理成本测试。
drop_last=True 会丢弃最后一个不足 batch_size 的批次。它适合要求固定批量形状的训练过程,但会让每轮少使用一部分样本。验证和测试通常应设为 False,避免遗漏评估数据。
创建并验证批量加载器
下面构造 23 个样本,并以每批 5 个样本进行训练式加载。为了让示例适用于常见开发环境,先将工作进程数设为 0;需要测试并行性能时,可以将 worker_count 改为 2 或 4。
import torch
from torch.utils.data import DataLoader, TensorDataset

features = torch.arange(23, dtype=torch.float32).unsqueeze(1)
labels = (features.squeeze(1).long() % 3)
dataset = TensorDataset(features, labels)

worker_count = 0  # 调试阶段使用主进程,性能测试时再逐步增加
loader = DataLoader(
    dataset,
    batch_size=5,
    shuffle=True,
    num_workers=worker_count,
    drop_last=True,
    generator=torch.Generator().manual_seed(42),
)

batch_sizes = []
loaded_samples = 0

for batch_features, batch_labels in loader:
    batch_sizes.append(batch_features.size(0))
    loaded_samples += batch_labels.size(0)

print("批次数:", len(loader))
print("每批大小:", batch_sizes)
print("实际加载样本数:", loaded_samples)
print("数据集样本数:", len(dataset))
预期输出如下。样本顺序经过打乱,但这里只检查不会随打乱结果变化的批量信息。
批次数: 4
每批大小: [5, 5, 5, 5]
实际加载样本数: 20
数据集样本数: 23
23 个样本最多组成 4 个完整的 5 样本批次,剩余 3 个样本因 drop_last=True 被丢弃。若将其改为 False,加载器会产生 5 个批次,最后一批大小为 3。
参数选择与常见边界
训练集通常采用 shuffle=True,验证集和测试集采用 shuffle=False。只有训练过程确实依赖固定批量形状时才启用 drop_last=True,否则应保留尾批。
增加 num_workers 不一定持续提速。数据已在内存中、样本处理很轻或机器 CPU 核心较少时,进程创建和通信开销可能抵消收益。应从 0 开始,再通过完整训练耗时逐步测试。
在 Windows 脚本中使用多进程加载时,应把创建加载器和启动训练的代码放进 if __name__ == "__main__": 入口,避免子进程重复执行主模块。Notebook 中若出现工作进程退出错误,也可以先将 num_workers 调回 0 定位问题。