
机器学习与深度学习 / 系统课时
多 GPU 分布式训练
多 GPU 分布式训练
本课将用 DistributedDataParallel 建立单机多 GPU 训练流程。你会看清进程、GPU、模型副本和数据分片之间的对应关系,并运行一个可由 torchrun 启动的最小训练脚本。
学习目标
- 区分数据并行与分布式数据并行的组织方式
- 使用一进程一 GPU 的方式初始化 DDP
- 用
DistributedSampler切分数据并正确同步梯度
从数据并行到 DDP
数据并行的核心是复制模型、切分批次、并行计算,再聚合梯度。DataParallel 在一个主进程中管理多张 GPU,主卡还承担切分和聚合工作,容易形成额外开销。
DistributedDataParallel,简称 DDP,通常为每张 GPU 启动一个独立进程。每个进程持有完整模型副本,只读取属于自己的数据分片;反向传播时,各进程通过集合通信对梯度执行同步归约,因此更新后的参数保持一致。
| 对比项 | DataParallel | DistributedDataParallel |
|---|---|---|
| 进程组织 | 单进程控制多 GPU | 通常一进程对应一 GPU |
| 梯度同步 | 主卡聚合 | 进程间集合通信 |
| 扩展范围 | 主要用于单机 | 支持单机和多机 |
| 推荐场景 | 快速尝试 | 正式多 GPU 训练 |
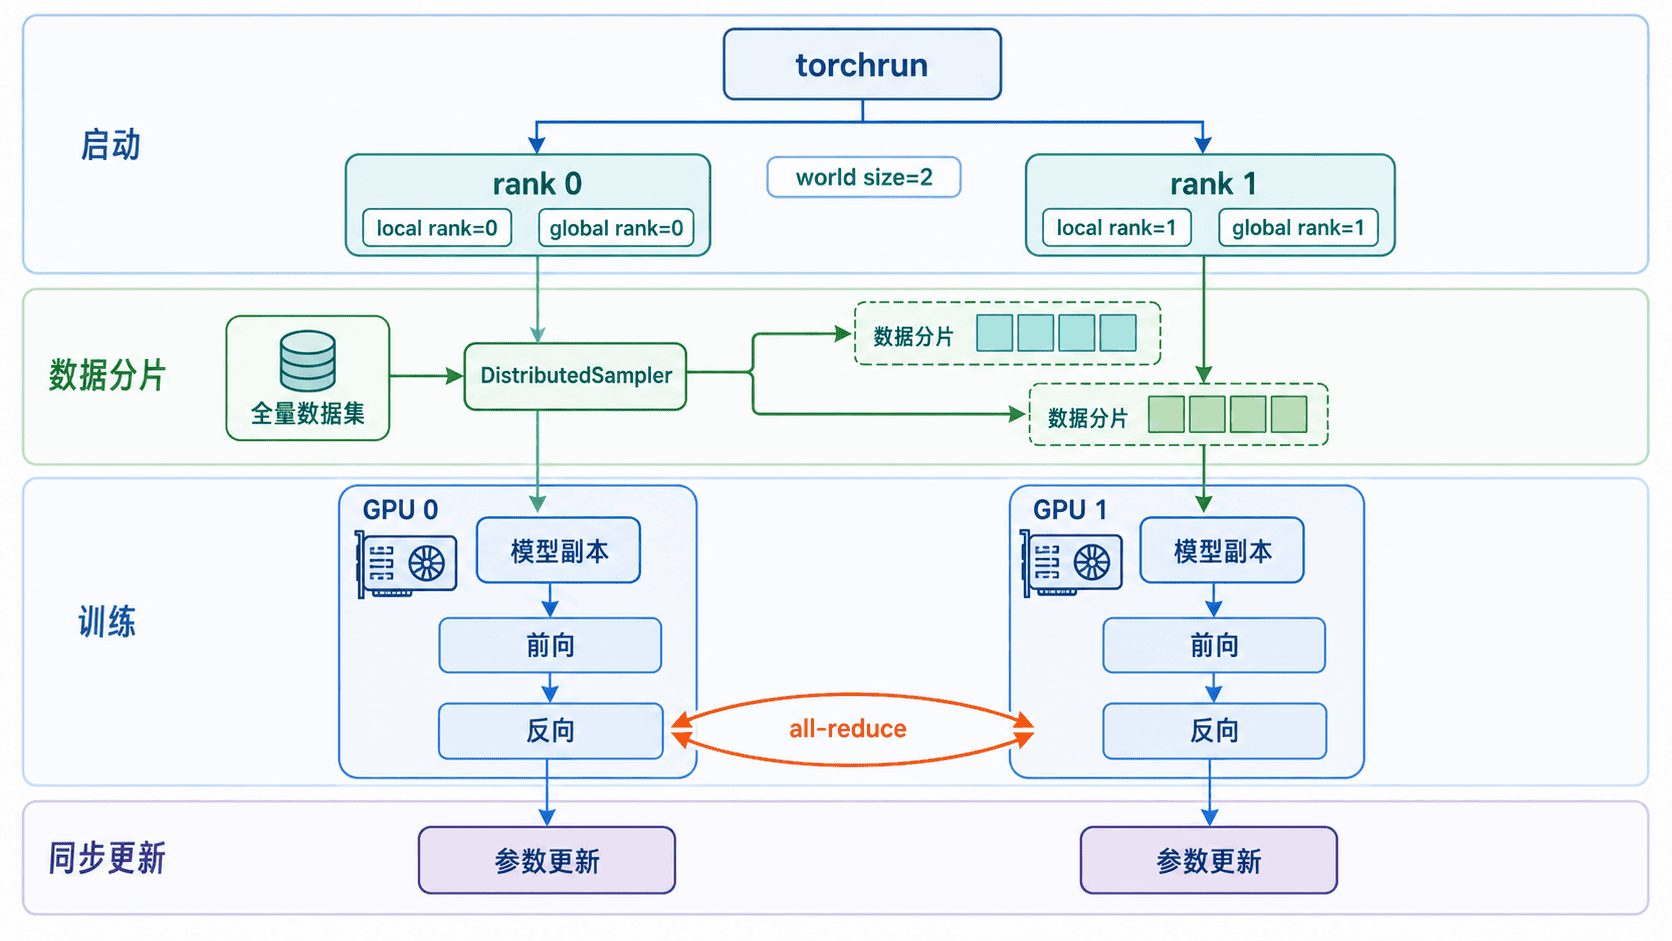
一进程一 GPU 的训练脚本
以下脚本要求机器至少有两张可用的 NVIDIA GPU,并使用 NCCL 后端。torchrun 会为每个子进程注入 LOCAL_RANK 等环境变量,脚本据此完成设备绑定和进程组初始化。
import os

import torch
import torch.distributed as dist
from torch import nn
from torch.nn.parallel import DistributedDataParallel as DDP
from torch.utils.data import DataLoader, DistributedSampler, TensorDataset

def setup() -> tuple[int, int, int]:
    local_rank = int(os.environ["LOCAL_RANK"])
    torch.cuda.set_device(local_rank)
    dist.init_process_group(backend="nccl")
    return local_rank, dist.get_rank(), dist.get_world_size()

def main() -> None:
    local_rank, rank, world_size = setup()
    device = torch.device(f"cuda:{local_rank}")
    torch.manual_seed(42)

    features = torch.randn(1024, 32)
    labels = features.sum(dim=1, keepdim=True)
    dataset = TensorDataset(features, labels)

    # 每个进程只读取自己的样本分片,避免重复训练同一批数据。
    sampler = DistributedSampler(
        dataset,
        num_replicas=world_size,
        rank=rank,
        shuffle=True,
    )
    loader = DataLoader(
        dataset,
        batch_size=32,
        sampler=sampler,
        pin_memory=True,
    )

    model = nn.Sequential(
        nn.Linear(32, 64),
        nn.ReLU(),
        nn.Linear(64, 1),
    ).to(device)
    model = DDP(model, device_ids=[local_rank])

    optimizer = torch.optim.SGD(model.parameters(), lr=0.01)
    loss_fn = nn.MSELoss()

    for epoch in range(2):
        # 让各进程在每轮使用一致但不同于上一轮的打乱顺序。
        sampler.set_epoch(epoch)
        total_loss = torch.zeros(1, device=device)

        for batch_x, batch_y in loader:
            batch_x = batch_x.to(device, non_blocking=True)
            batch_y = batch_y.to(device, non_blocking=True)

            optimizer.zero_grad(set_to_none=True)
            prediction = model(batch_x)
            loss = loss_fn(prediction, batch_y)
            loss.backward()  # DDP 在反向传播期间同步各进程梯度。
            optimizer.step()
            total_loss += loss.detach()

        dist.all_reduce(total_loss, op=dist.ReduceOp.SUM)
        if rank == 0:
            average_loss = total_loss.item() / (len(loader) * world_size)
            print(f"epoch={epoch} average_loss={average_loss:.6f}")

    dist.destroy_process_group()

if __name__ == "__main__":
    main()
将脚本保存为 ddp_train.py,然后启动两个训练进程。
torchrun --standalone --nproc_per_node=2 ddp_train.py预期只有 rank 0 输出汇总结果。<LOSS_0> 和 <LOSS_1> 是浮点损失值,会随硬件和数值计算细节略有差异。
epoch=0 average_loss=<LOSS_0>
epoch=1 average_loss=<LOSS_1>
数据如何切分与同步
假设全局批次希望包含 64 个样本,并启动两个进程,那么每个进程的本地批次可设为 32。DDP 不会自动替你切分数据集,因此需要 DistributedSampler 保证不同 rank 取得不同索引。
每个进程独立完成前向计算和本地损失计算。调用 loss.backward() 时,DDP 会在梯度就绪后发起同步归约;归约完成后,各模型副本拥有等价梯度,随后执行相同的 optimizer.step()。
sampler.set_epoch(epoch) 不能省略。若启用了随机打乱却不更新 epoch,多个训练轮次可能重复相同的采样顺序,降低随机性。
运行与排错检查
启动前先确认 nvidia-smi 能看到目标 GPU,且 --nproc_per_node 不大于可用 GPU 数量。出现进程卡住时,应优先检查各 rank 是否执行了相同次数的前向、反向和集合通信;某个进程提前退出,会让其他进程一直等待。
保存日志和检查点时通常只让 rank 0 写入共享文件,避免多个进程覆盖同一路径。训练完成或异常处理结束前,应销毁进程组;正式项目还应使用 try...finally 保证清理逻辑得到执行。