
机器学习与深度学习 / 系统课时
词表与嵌入层
词表与嵌入层
神经网络不能直接处理词语等离散符号。本课将完成从词元到编号的稳定映射,处理未登录词与补齐符号,并用 nn.Embedding 把整数编号转换为可训练的连续向量。
学习目标
- 建立包含补齐词元和未知词元的词表
- 将词元序列编码为固定规则的整数张量
- 理解嵌入层的输入输出形状及关键边界
词表负责稳定编号
词表本质上是从词元到整数 ID 的映射。通常应预留 <pad> 和 <unk>:<pad> 用于批量补齐,<unk> 用于表示词表中不存在的词元。二者职责不同,不能共用同一个编号。
词表应只根据训练集建立,并在验证、测试和部署阶段保持不变。若推理时重新排序或扩充词表,同一个 ID 就可能指向不同词元,已训练的嵌入参数也会随之失效。
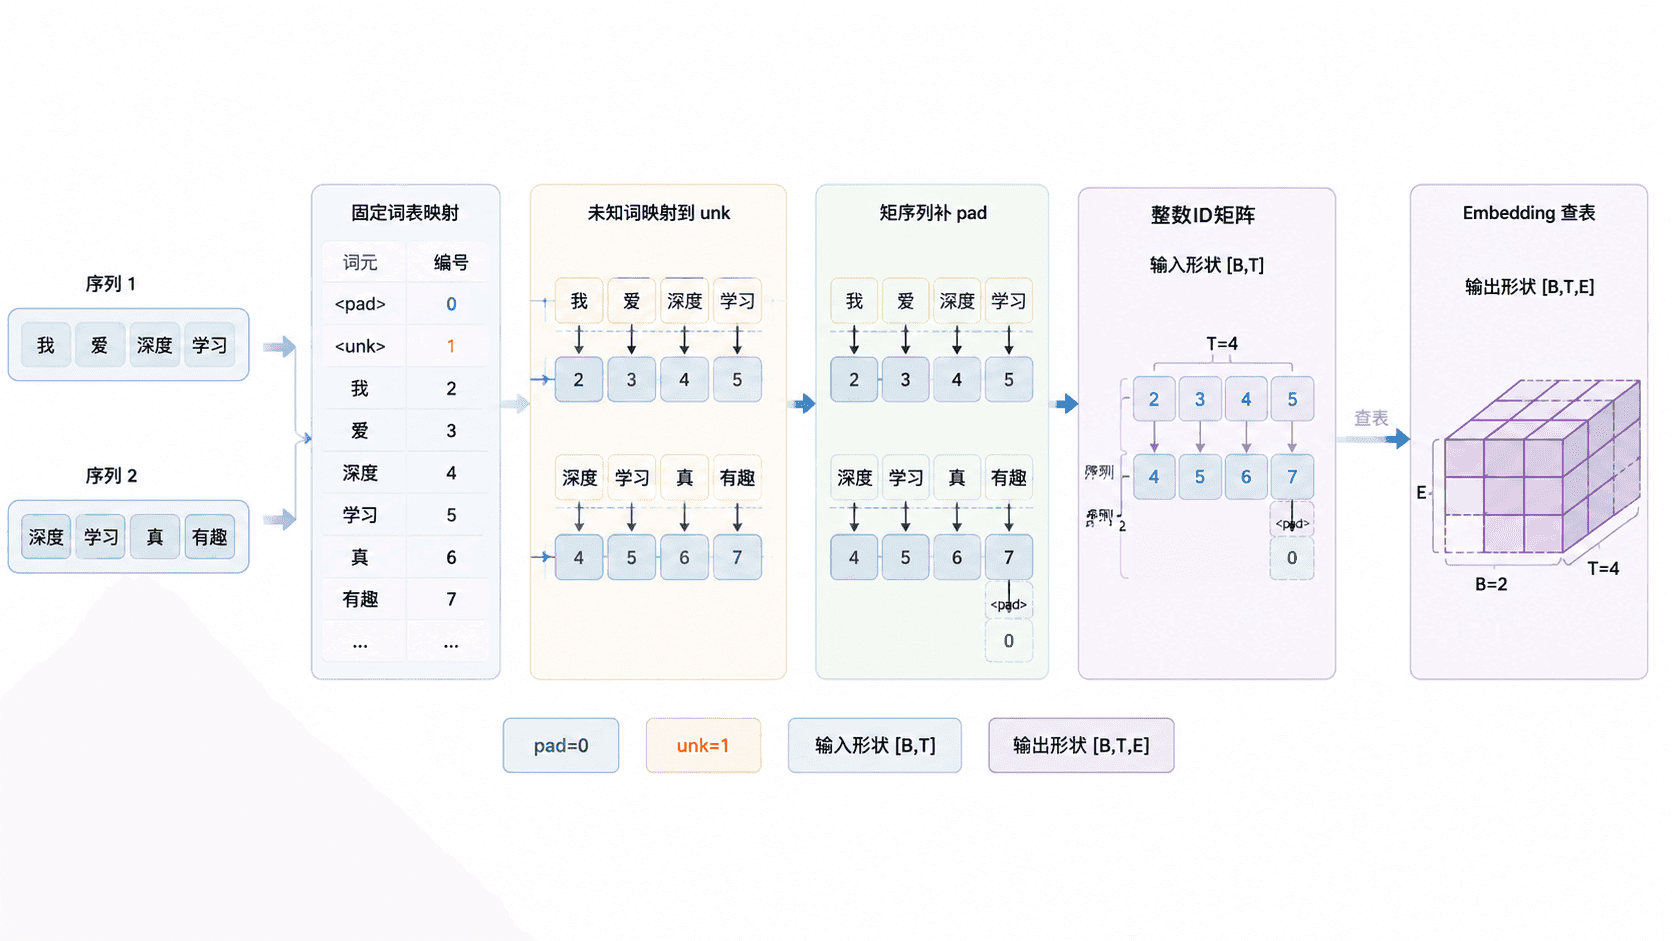
完成编码与向量查表
nn.Embedding 可以理解为一张可训练的向量表。输入中的每个整数 ID 用来选择一行参数,因此输入必须是整型张量,并且所有 ID 都要满足 0 <= id < num_embeddings。
下面的完整示例先编码两个句子,再补齐到相同长度,最后得到三维嵌入张量。未知词会映射到 <unk>,补齐位置会映射到 <pad>。
import torch
from torch import nn

vocab = {
    "<pad>": 0,
    "<unk>": 1,
    "深度": 2,
    "学习": 3,
    "很": 4,
    "有趣": 5,
    "也": 6,
    "要": 7,
    "处理": 8,
}

sentences = [
    ["深度", "学习", "很", "有趣"],
    ["未登录词", "也", "处理"],
]
max_length = 4

def encode(tokens: list[str]) -> list[int]:
    ids = [vocab.get(token, vocab["<unk>"]) for token in tokens]
    return ids + [vocab["<pad>"]] * (max_length - len(ids))

input_ids = torch.tensor(
    [encode(tokens) for tokens in sentences],
    dtype=torch.long,
)

torch.manual_seed(7)
embedding = nn.Embedding(
    num_embeddings=len(vocab),
    embedding_dim=3,
    padding_idx=vocab["<pad>"],
)
vectors = embedding(input_ids)

print("input_ids =")
print(input_ids)
print("vectors shape =", tuple(vectors.shape))
print("padding vector =", embedding.weight[0].detach())
预期输出:
input_ids =
tensor([[2, 3, 4, 5],
        [1, 6, 8, 0]])
vectors shape = (2, 4, 3)
padding vector = tensor([0., 0., 0.])
理解输出形状
输入形状是 [B, T],嵌入层会为每个位置追加一个向量维度,因此输出形状为 [B, T, E]。示例中批次大小为 2、序列长度为 4、嵌入维度为 3,所以结果是 (2, 4, 3)。
嵌入层执行的是按 ID 查表,而不是普通矩阵乘法。相同 ID 在同一次前向计算中会得到同一行向量;训练反向传播时,被使用到的词向量会根据损失更新。设置 padding_idx 后,对应行默认保持为零且不会参与常规梯度更新。
设计词表时的关键边界
词表大小必须与嵌入层的 num_embeddings 对齐。最安全的条件是词元 ID 从 0 连续编号到 len(vocab) - 1;若 ID 不连续,则应按最大 ID 加 1 设置表大小,否则可能出现索引越界。
大型语料通常还会设置最低词频或最大词表容量,把低频词统一映射为 <unk>。保存模型时,应同时保存词表及特殊词元编号,不能只保存嵌入层参数。加载阶段还要验证词表大小、编号顺序和嵌入维度是否与检查点一致。
常见错误
- 将字符串或浮点张量直接传入嵌入层,正确输入应为
torch.long - 忘记处理未知词,推理时直接访问不存在的词表键
- 把
<pad>与<unk>设为同一 ID,使模型无法区分缺失词和补齐位置 - 训练后重建词表,导致编号与已学习向量错位