
机器学习与深度学习 / 系统课时
编译优化模型
编译优化模型
本课将把一个普通 PyTorch 模型交给 torch.compile 优化,并通过输出一致性验证编译前后的结果。你还会理解首次运行为什么较慢,以及数据相关分支、频繁变形等动态逻辑何时会削弱编译收益。
学习目标
- 使用
torch.compile编译并运行模型 - 区分首次编译开销与稳定执行耗时
- 识别容易产生图中断的动态逻辑
编译优化解决什么问题
PyTorch 默认采用 eager 模式:Python 每执行一行,就立即调度相应算子。这种方式灵活、便于调试,但大量细碎算子会带来 Python 调度、内核启动和中间张量读写开销。
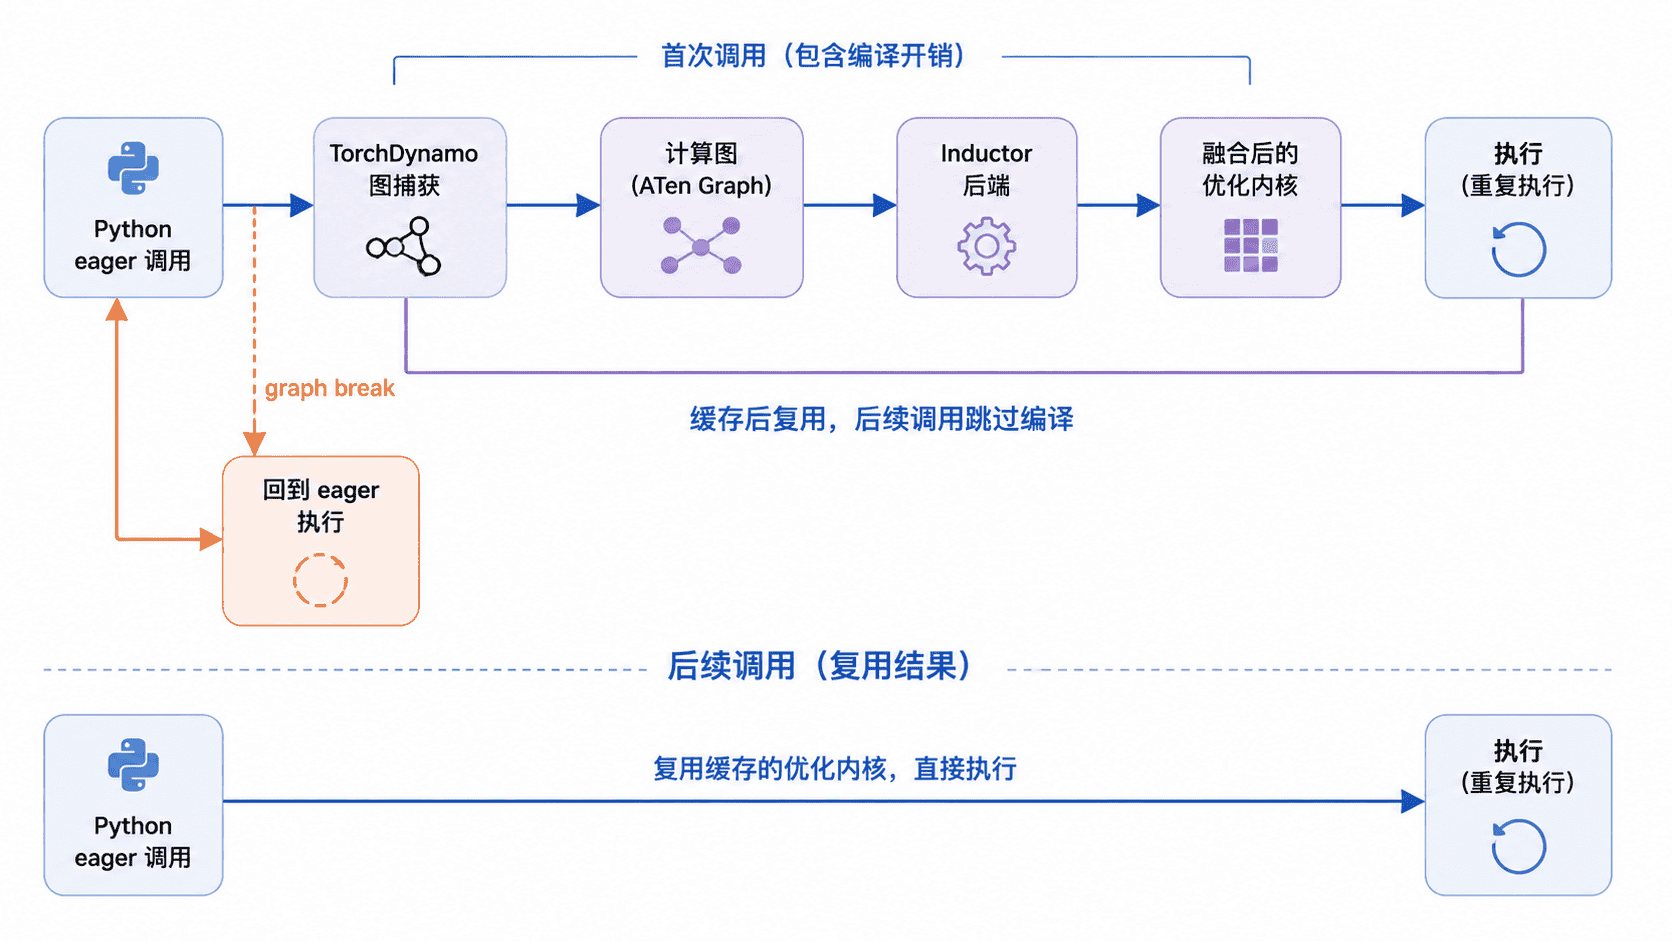
torch.compile 会在运行时捕获可编译的计算图,再交给后端生成更高效的执行代码。优化可能包括算子融合、减少中间结果和降低调度次数。它不会改变模型参数,也不保证所有模型都一定加速。
编译并验证模型
下面的脚本同时执行原始模型和编译模型。示例只比较输出是否一致,不直接断言加速比例,因为实际收益取决于硬件、输入形状、模型规模和算子类型。
import torch
from torch import nn

class TinyMLP(nn.Module):
    def __init__(self) -> None:
        super().__init__()
        self.layers = nn.Sequential(
            nn.Linear(128, 256),
            nn.ReLU(),
            nn.Linear(256, 10),
        )

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        return self.layers(x)

def main() -> None:
    torch.manual_seed(42)
    device = torch.device("cuda" if torch.cuda.is_available() else "cpu")

    model = TinyMLP().to(device).eval()
    compiled_model = torch.compile(model)
    inputs = torch.randn(64, 128, device=device)

    # 第一次调用会触发图捕获和编译,不能直接作为稳定性能数据。
    with torch.inference_mode():
        eager_output = model(inputs)
        compiled_output = compiled_model(inputs)

    same = torch.allclose(
        eager_output,
        compiled_output,
        rtol=1e-4,
        atol=1e-5,
    )
    print(f"device={device.type}")
    print(f"output_shape={tuple(compiled_output.shape)}")
    print(f"outputs_close={same}")

if __name__ == "__main__":
main()预期输出如下,<DEVICE> 会根据运行环境显示为 cpu 或 cuda。
device=<DEVICE>
output_shape=(64, 10)
outputs_close=True
验证性能时,应先用相同输入预热若干次,再统计多次稳定执行的平均值。使用 CUDA 计时时,还要在计时边界调用 torch.cuda.synchronize(),否则异步执行会让结果失真。
动态逻辑为什么会破坏计算图
编译器最容易处理形状稳定、算子路径稳定的张量计算。若 forward 中调用 .item() 把张量转成 Python 标量,再根据结果执行不同分支,编译器可能无法把整段逻辑保留在同一张图中,从而产生 graph break。
下面是片段示例。前一种写法依赖运行时数据选择 Python 分支;后一种写法把选择保留为张量运算,更利于编译器捕获。
def data_dependent_branch(x: torch.Tensor) -> torch.Tensor:
    if x.sum().item() > 0:
        return x * 2
    return x - 2

def tensor_branch(x: torch.Tensor) -> torch.Tensor:
    condition = x.sum() > 0
    return torch.where(condition, x * 2, x - 2)
对于输入 torch.tensor([1.0, 2.0]),两种函数的预期结果相同。
tensor([2., 4.])频繁变化的输入形状、运行中修改模块结构、依赖 Python 副作用的代码,也可能导致重新编译或图中断。发现编译耗时反复出现时,应先固定输入规格,再缩小动态逻辑范围。
什么时候不适合编译
模型很小、只运行一两次时,编译成本可能高于节省的执行时间。训练流程仍在频繁调试时,也应先保留 eager 模式,以便获得更直接的堆栈和逐步检查能力。
较合适的对象通常是会重复执行很多次、主要由张量算子组成、输入形状相对稳定的训练步骤或推理模型。采用编译前应建立 eager 基线,同时比较正确性、稳定吞吐和显存占用,而不是只观察一次运行。