
机器学习与深度学习 / 系统课时
分类结果误差分析
分类结果误差分析
单看准确率无法说明模型错在什么地方。本课将把验证集预测整理为混淆矩阵、类别级指标和高置信错误清单,并据此判断问题来自类别混淆、数据质量还是样本分布。
学习目标
- 能根据真实标签与预测标签构建混淆矩阵。
- 能解释每个类别的精确率、召回率和 F1 值。
- 能从高置信错误样本中提炼可执行的改进方向。
建立误差分析闭环
误差分析不是“看几张错图”,而是从总体结果逐层缩小范围。先用混淆矩阵找出最常见的类别混淆,再查看类别指标判断问题偏向误报还是漏报,最后回到具体样本检查标签、主体、背景和图像质量。
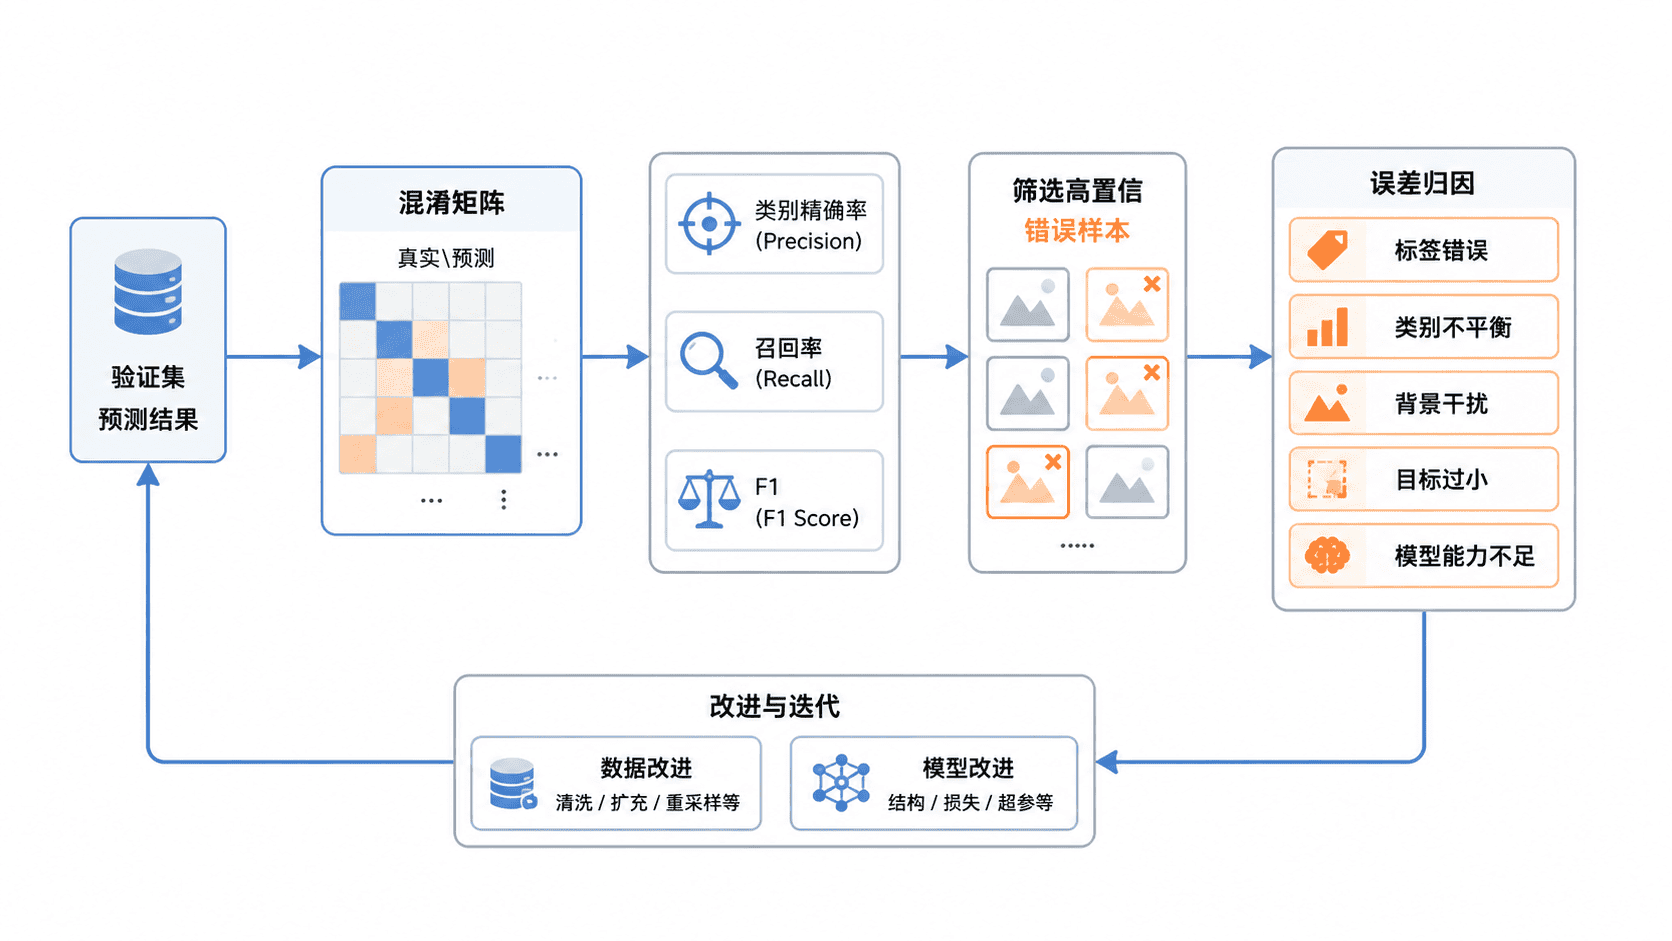
混淆矩阵通常约定“行表示真实类别,列表示预测类别”。主对角线越大越好,非对角线中的大值则代表稳定的错误模式。例如“兔子经常被预测成狗”,比“偶尔随机错一张”更值得优先处理。
运行误差分析脚本
下面的示例模拟验证集输出。真实项目中,只需把 targets、preds、confidences 和 paths 替换为验证循环收集的结果,即可复用同一套分析逻辑。
python
import torch

class_names = ['cat', 'dog', 'rabbit']
targets = torch.tensor([0, 0, 0, 0, 1, 1, 1, 1, 2, 2, 2, 2])
preds = torch.tensor([0, 0, 1, 0, 1, 1, 0, 1, 2, 1, 2, 2])
confidences = torch.tensor([
    0.92, 0.88, 0.81, 0.95,
    0.90, 0.86, 0.78, 0.93,
    0.89, 0.76, 0.91, 0.87,
])
paths = [f'img_{index:02d}.jpg' for index in range(len(targets))]

num_classes = len(class_names)

# 一次性统计“真实类别 × 预测类别”的组合数量。
confusion_matrix = torch.bincount(
    targets * num_classes + preds,
    minlength=num_classes ** 2,
).reshape(num_classes, num_classes)

accuracy = (
    confusion_matrix.diag().sum().item()
    / confusion_matrix.sum().item()
)

print('confusion matrix:')
print(confusion_matrix)
print(f'accuracy: {accuracy:.2%}')

# 分别计算每个类别的精确率、召回率和 F1。
for index, name in enumerate(class_names):
    true_positive = confusion_matrix[index, index].item()
    predicted_count = confusion_matrix[:, index].sum().item()
    actual_count = confusion_matrix[index, :].sum().item()

    precision = true_positive / predicted_count if predicted_count else 0.0
    recall = true_positive / actual_count if actual_count else 0.0
    f1 = (
        2 * precision * recall / (precision + recall)
        if precision + recall
        else 0.0
    )
    print(
        f'{name:<6} precision={precision:.2f} '
        f'recall={recall:.2f} f1={f1:.2f}'
    )

# 高置信度错分通常更能暴露稳定偏差。
errors = []
for index, (target, pred, confidence) in enumerate(
    zip(targets.tolist(), preds.tolist(), confidences.tolist())
):
    if target != pred:
        errors.append((
            confidence,
            paths[index],
            class_names[target],
            class_names[pred],
        ))

for confidence, path, target_name, pred_name in sorted(
    errors,
    reverse=True,
):
    print(
        f'{path}: {target_name} -> {pred_name}, '
        f'confidence={confidence:.2f}'
    )
预期输出:
text
confusion matrix:
tensor([[3, 1, 0],
        [1, 3, 0],
        [0, 1, 3]])
accuracy: 75.00%
cat    precision=0.75 recall=0.75 f1=0.75
dog    precision=0.60 recall=0.75 f1=0.67
rabbit precision=1.00 recall=0.75 f1=0.86
img_02.jpg: cat -> dog, confidence=0.81
img_06.jpg: dog -> cat, confidence=0.78
img_09.jpg: rabbit -> dog, confidence=0.76
这里的整体准确率是 75%,但类别表现并不均衡。dog 的精确率只有 0.60,说明被预测为狗的样本中误报较多;rabbit 的召回率为 0.75,说明仍有四分之一的兔子没有被识别出来。
从结果转化为改进动作
先处理“高频且高置信”的错误,因为这类问题通常不是随机波动。检查错图时,应记录真实类别、预测类别、置信度、文件路径和可能原因,避免只凭印象判断。
若大量错误集中在一对类别,应增加能体现二者差异的样本,或提高输入分辨率。若某类召回率很低,应检查类别数量、标签遗漏和采样策略。若高置信错误来自模糊图、遮挡或背景,应补充相应增强,并确认训练集与真实场景是否一致。
不要在看到一次误差分析后立刻同时修改数据、模型和超参数。每轮只改变一到两个因素,再用同一验证集重复统计,才能确认改动是否真正降低了主要错误。
按自己的节奏,确认真正理解。