
机器学习与深度学习 / 系统课时
矩阵与批量运算
矩阵与批量运算
本课解决“张量怎样完成神经网络中的线性变换”这一核心问题。你将从向量点积开始,掌握二维矩阵乘法与三维批量矩阵乘法,并能通过形状检查快速定位维度不匹配。
学习目标
- 区分点积、矩阵乘法和批量矩阵乘法
- 根据输入形状判断乘法是否可执行及输出形状
- 使用
torch.dot、@、torch.matmul和torch.bmm
先看清形状规则
两个一维向量做点积时,元素数量必须相同,结果是一个标量。二维矩阵相乘时,左矩阵的最后一维必须等于右矩阵的倒数第二维,例如 [m, k] @ [k, n] 得到 [m, n]。
三维批量矩阵通常写成 [batch, m, k] 与 [batch, k, n],每个批次独立相乘,输出为 [batch, m, n]。torch.bmm 要求两个输入都是三维且批次数一致;torch.matmul 更通用,并支持高维广播。
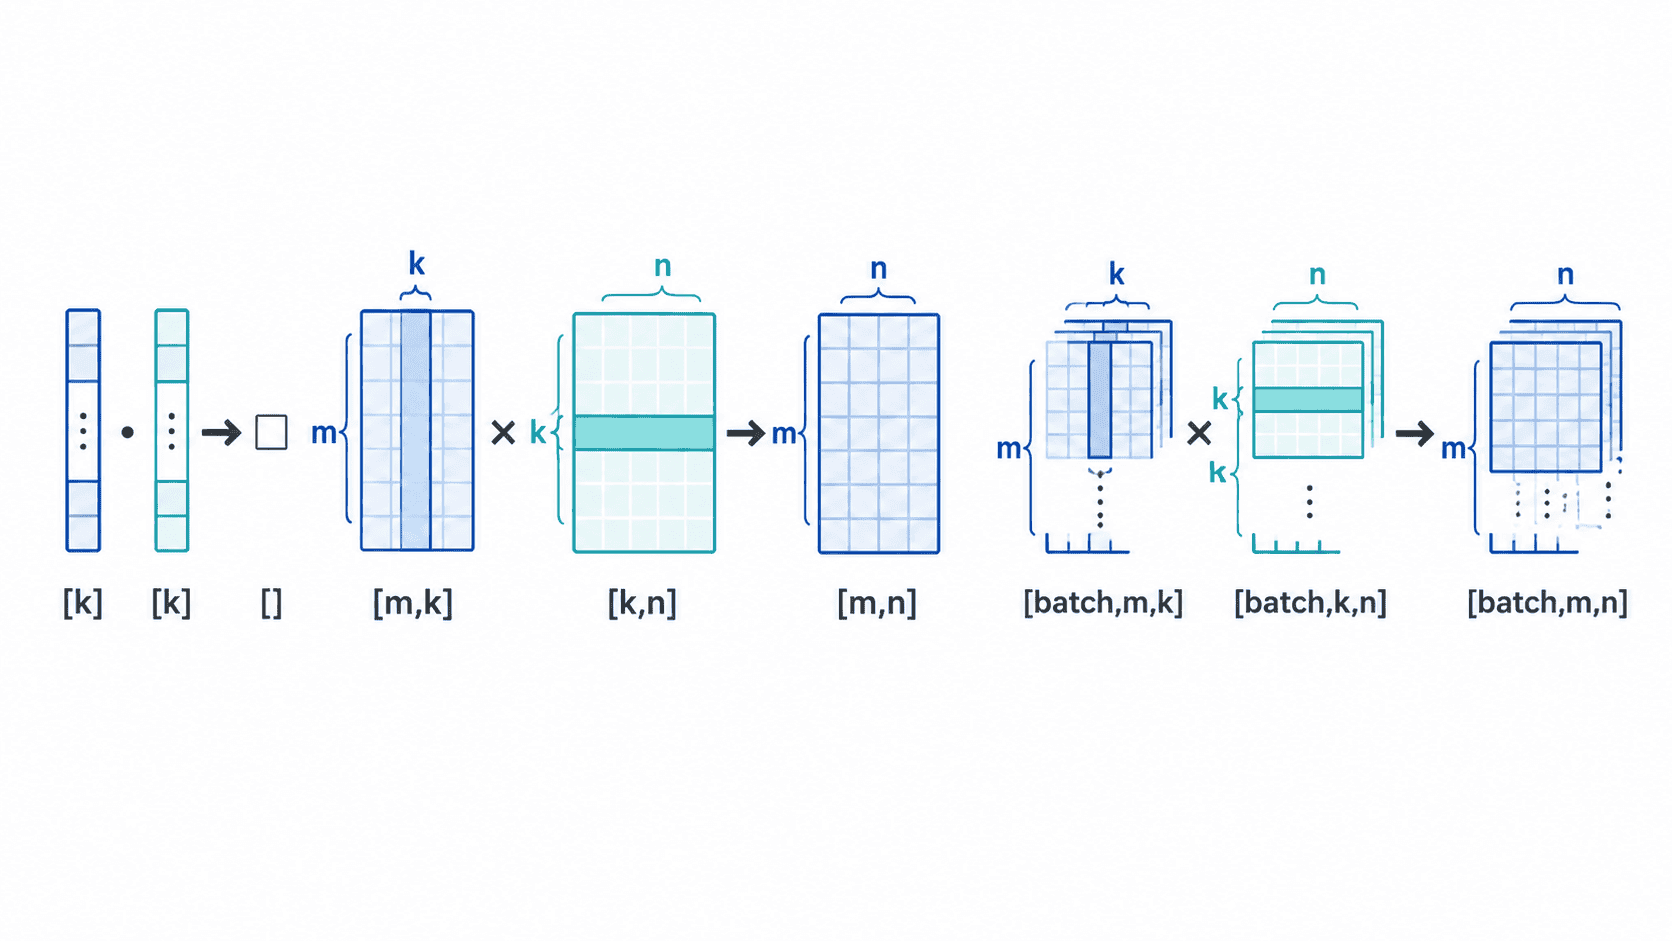
完成点积、矩阵乘法与批量乘法
下面的示例依次演示三种运算,并打印结果形状。矩阵乘法使用 @,它与这里的 torch.matmul 语义一致;批量矩阵乘法使用约束更明确的 torch.bmm。
import torch

u = torch.tensor([1.0, 2.0, 3.0])
v = torch.tensor([4.0, 5.0, 6.0])
print("dot:", torch.dot(u, v))

x = torch.tensor([[1.0, 2.0, 3.0], [4.0, 5.0, 6.0]])
weight = torch.tensor([[1.0, 0.0], [0.0, 1.0], [1.0, 1.0]])
matrix_out = x @ weight
print("matrix_shape:", tuple(matrix_out.shape))
print("matrix_out:", matrix_out)

batch_x = torch.tensor(
    [[[1.0, 2.0], [3.0, 4.0]], [[5.0, 6.0], [7.0, 8.0]]]
)
batch_weight = torch.tensor(
    [[[1.0, 0.0], [0.0, 1.0]], [[0.0, 1.0], [1.0, 0.0]]]
)

# 每个批次使用各自的 2×2 权重矩阵
batch_out = torch.bmm(batch_x, batch_weight)
print("batch_shape:", tuple(batch_out.shape))
print("batch_out:", batch_out)
预期输出:
dot: tensor(32.)
matrix_shape: (2, 2)
matrix_out: tensor([[ 4.,  5.],
        [10., 11.]])
batch_shape: (2, 2, 2)
batch_out: tensor([[[1., 2.],
         [3., 4.]],

        [[6., 5.],
         [8., 7.]]])
对应到神经网络线性层
神经网络中的全连接计算本质上是“输入矩阵乘权重矩阵,再加偏置”。若输入形状为 [batch, in_features],权重形状为 [in_features, out_features],输出形状就是 [batch, out_features]。
PyTorch 的 torch.nn.Linear 对权重采用内部存储布局,并自动处理偏置与梯度,因此业务代码通常直接使用线性层。手写矩阵乘法的价值在于理解形状变化、检查自定义网络模块以及调试维度错误。
广播、连续性与边界
当多个样本共享同一权重矩阵时,可以直接使用 torch.matmul:高维输入的最后两个维度参与矩阵乘法,前面的维度按广播规则处理。若每个批次都有独立权重且输入严格为三维,torch.bmm 的意图更清晰。
矩阵乘法不会自动修正维度顺序。出现“shapes cannot be multiplied”一类错误时,应依次打印左右张量的 shape,检查左侧最后一维是否等于右侧倒数第二维,再判断是否错误使用了 transpose、reshape 或 squeeze。
reshape 只改变视图组织方式,不能替代数学上的转置。交换矩阵维度应使用 transpose 或 mT,否则即使元素总数相同,也可能得到语义错误的计算。