
机器学习与深度学习 / 系统课时
序列数据表示
序列数据表示
序列样本的长度往往不同,模型却需要按批次接收规则张量。本课将把文本编号序列和多变量时间序列整理成 batch × time × feature 形式,并用长度与掩码区分真实数据和补齐位置。
学习目标
- 理解序列张量中批次、时间步和特征维度的含义
- 使用补齐方法构造可直接送入模型的批量输入
- 正确生成长度张量和布尔掩码,避免补齐值干扰计算
先确定序列张量的形状
单条文本经过编号后通常是一维张量,形状为 [T],其中 T 是词元数量。单条时间序列若每个时间点包含温度、湿度等多个特征,形状通常为 [T, F],其中 F 是每个时间步的特征数。
组成批次后,常用布局是 [B, T, F]。文本编号没有显式特征维时,可先表示为 [B, T],经过嵌入层后再变成 [B, T, E]。这里的 E 是嵌入维度。
用补齐构造批量输入
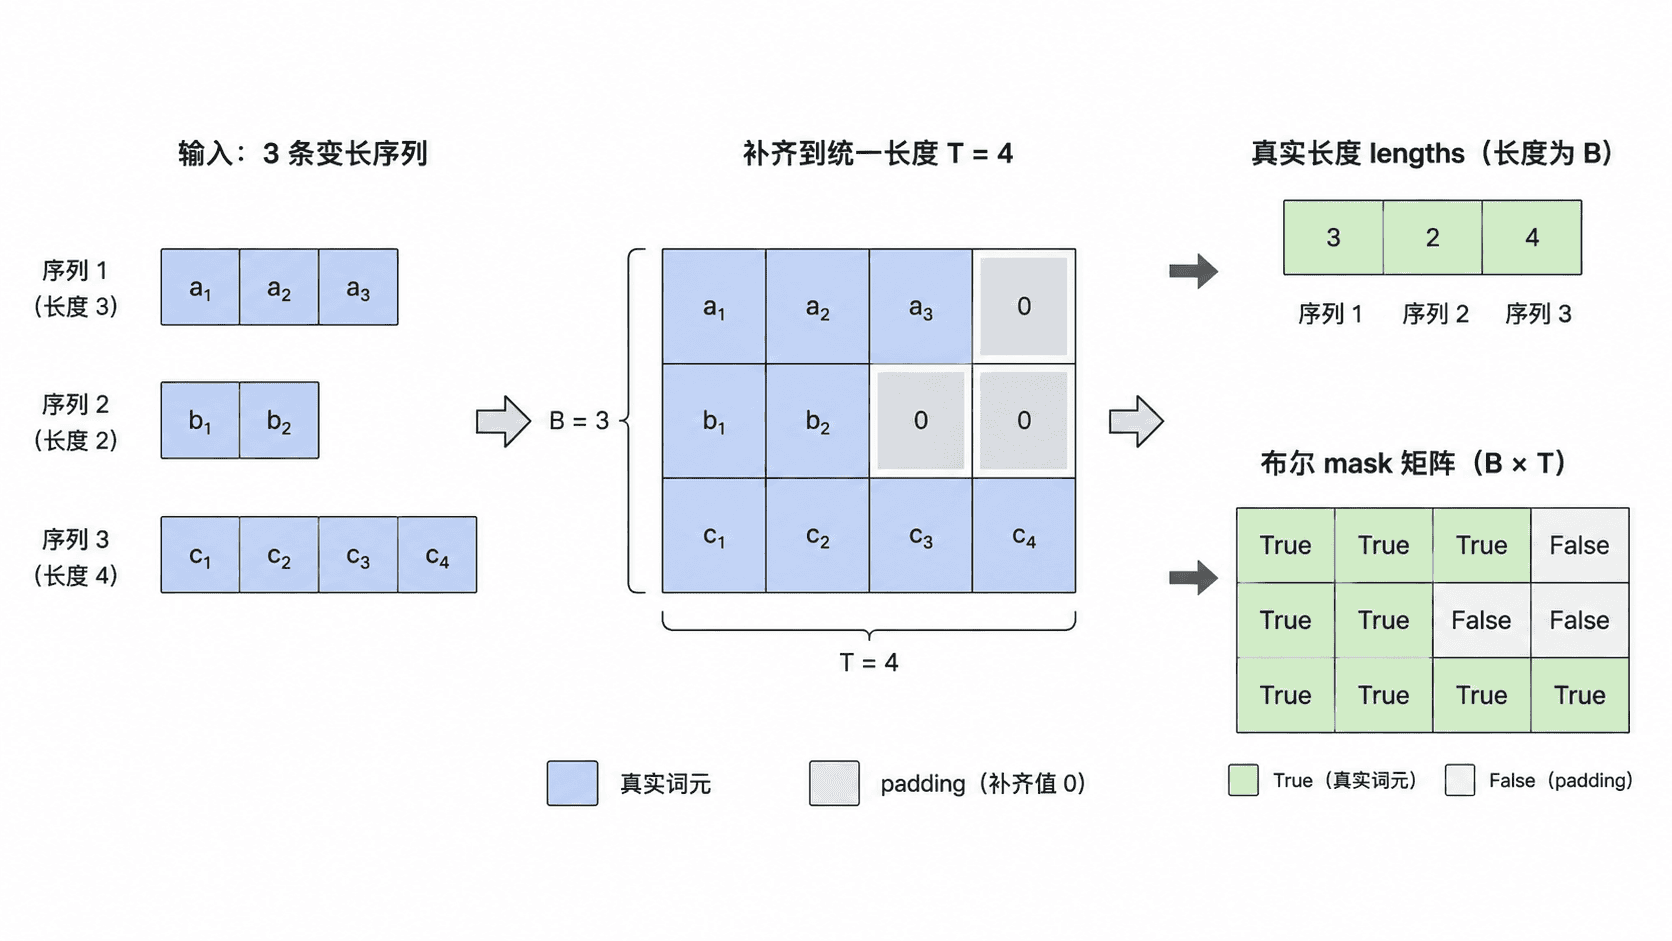
同一批次中的样本必须拥有相同的时间维长度。最常见的处理是把较短序列补到本批次最长长度,并额外保留每条序列的真实长度。补齐值本身不代表有效数据,因此后续还要配合掩码使用。
下面的示例使用 pad_sequence 完成右侧补齐,并通过广播比较生成布尔掩码。True 表示真实位置,False 表示补齐位置。
import torch
from torch.nn.utils.rnn import pad_sequence

sequences = [
    torch.tensor([5, 8, 2], dtype=torch.long),
    torch.tensor([7, 4], dtype=torch.long),
    torch.tensor([9, 1, 3, 6], dtype=torch.long),
]

# batch_first=True 使输出布局为 [B, T]
padded = pad_sequence(
    sequences,
    batch_first=True,
    padding_value=0,
)
lengths = torch.tensor([seq.size(0) for seq in sequences])

# 每一列的时间步编号与真实长度比较,得到有效位置掩码
steps = torch.arange(padded.size(1)).unsqueeze(0)
mask = steps < lengths.unsqueeze(1)

print("padded =")
print(padded)
print("lengths =", lengths)
print("mask =")
print(mask)
预期输出:
padded =
tensor([[5, 8, 2, 0],
        [7, 4, 0, 0],
        [9, 1, 3, 6]])
lengths = tensor([3, 2, 4])
mask =
tensor([[ True,  True,  True, False],
        [ True,  True, False, False],
        [ True,  True,  True,  True]])
长度与掩码各自解决什么问题
长度张量适合交给支持变长输入的循环网络工具,例如 pack_padded_sequence。它告诉模型每条序列在哪个时间步结束,使循环计算可以跳过补齐区域。
掩码更适合注意力、池化和损失计算。注意力中可屏蔽补齐键值;平均池化时可只累加真实位置;逐时间步计算损失时,也可排除无效位置。不要仅依赖补齐值为零,因为真实数据本身也可能包含零。
时间序列批处理的边界
多变量时间序列应先保证所有样本的特征数 F 一致,再沿时间维补齐。若原始样本形状是 [T, F],pad_sequence(..., batch_first=True) 的结果就是 [B, T, F],无需手工逐列拼接。
构造批次时还要统一数据类型和设备。模型输入、长度和掩码通常分别使用浮点型、整型和布尔型;参与同一次 GPU 运算的张量必须位于同一设备。长度张量传给某些打包 API 时可能要求保留在 CPU,应以实际接口约束为准。
常见错误
- 把
[T, B, F]和[B, T, F]混用,导致模型读取错误维度 - 只补齐序列却不保存真实长度或掩码,使补齐位置参与注意力与损失
- 在全数据集上固定到极端最大长度,造成大量无效计算;实际训练可按批次动态补齐或按长度分桶