
机器学习与深度学习 / 系统课时
学习率调度
学习率调度
固定学习率很难同时兼顾训练前期的快速探索和后期的精细收敛。本课将用 PyTorch 对比分段衰减、余弦退火和基于验证指标的调度方式,并明确它们在训练循环中的调用位置。
学习目标
- 理解学习率随训练进程变化的原因
- 会配置
StepLR、CosineAnnealingLR和ReduceLROnPlateau - 能把调度器放到正确的训练与验证位置
学习率为什么要变化
训练初期通常需要较大的学习率,让参数快速离开较差的初始区域;接近收敛时,过大的步长又可能使损失在最优点附近来回震荡。因此,调度器的任务不是替代优化器,而是在训练过程中修改优化器各参数组的 lr。
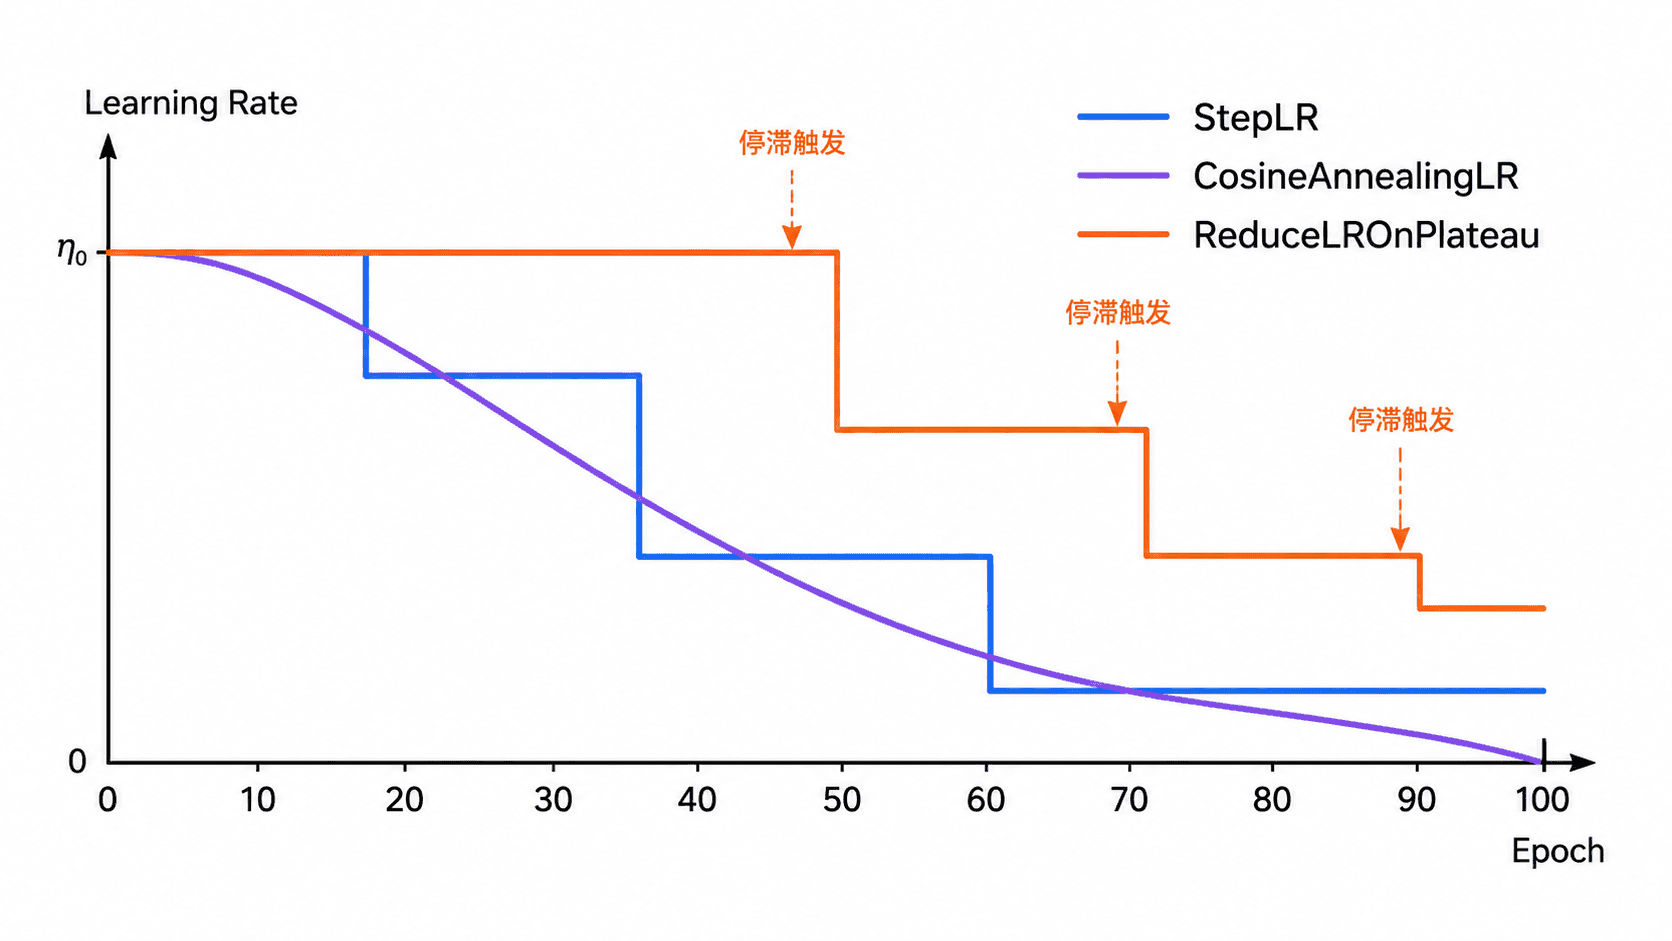
图中三条曲线代表三种不同决策依据:固定轮次、连续训练进度和验证集表现。选择策略时,先判断你是否知道合适的衰减时点,再决定由计划还是指标触发。
三种常用策略
| 策略 | 调整依据 | 关键参数 | 适用情况 |
|---|---|---|---|
StepLR |
每隔固定轮次衰减 | step_size、gamma |
已知大致训练周期,规则简单稳定 |
CosineAnnealingLR |
按余弦曲线平滑下降 | T_max、eta_min |
希望学习率连续变化,训练轮数相对明确 |
ReduceLROnPlateau |
验证指标长期不改善 | factor、patience |
难以预估何时进入平台期 |
StepLR 是周期性的分段衰减;需要在指定里程碑下降时可改用 MultiStepLR。ReduceLROnPlateau 不读取轮次趋势,而是读取验证损失或准确率,因此必须把监控指标传给 step()。
可运行示例
下面使用同一个初始学习率运行六轮,只观察调度结果。示例先调用 optimizer.step(),再调用调度器,避免把第一段学习率提前跳过。
python
import torch
from torch.optim import SGD
from torch.optim.lr_scheduler import (
    CosineAnnealingLR,
    ReduceLROnPlateau,
    StepLR,
)

def run_epoch_scheduler(name, scheduler_factory):
    parameter = torch.nn.Parameter(torch.tensor([1.0]))
    optimizer = SGD([parameter], lr=0.1)
    scheduler = scheduler_factory(optimizer)
    learning_rates = []

    for _ in range(6):
        learning_rates.append(round(optimizer.param_groups[0]["lr"], 4))

        # 模拟一次完整的参数更新,再推进按轮次工作的调度器
        optimizer.zero_grad()
        parameter.grad = torch.zeros_like(parameter)
        optimizer.step()
        scheduler.step()

    print(f"{name}: {learning_rates}")

def run_plateau():
    parameter = torch.nn.Parameter(torch.tensor([1.0]))
    optimizer = SGD([parameter], lr=0.1)
    scheduler = ReduceLROnPlateau(
        optimizer,
        mode="min",
        factor=0.5,
        patience=1,
    )
    validation_losses = [1.00, 0.90, 0.91, 0.92, 0.85, 0.86]
    learning_rates = []

    for validation_loss in validation_losses:
        learning_rates.append(round(optimizer.param_groups[0]["lr"], 4))

        optimizer.zero_grad()
        parameter.grad = torch.zeros_like(parameter)
        optimizer.step()

        # Plateau 调度器必须在验证完成后接收监控指标
        scheduler.step(validation_loss)

    print(f"ReduceLROnPlateau: {learning_rates}")

run_epoch_scheduler(
    "StepLR",
    lambda optimizer: StepLR(optimizer, step_size=2, gamma=0.5),
)
run_epoch_scheduler(
    "CosineAnnealingLR",
    lambda optimizer: CosineAnnealingLR(
        optimizer,
        T_max=6,
        eta_min=0.01,
    ),
)
run_plateau()
预期输出:
text
StepLR: [0.1, 0.1, 0.05, 0.05, 0.025, 0.025]
CosineAnnealingLR: [0.1, 0.094, 0.0775, 0.055, 0.0325, 0.016]
ReduceLROnPlateau: [0.1, 0.1, 0.1, 0.1, 0.05, 0.05]
输出说明:分段策略每两轮减半;余弦策略连续下降并逐渐接近 eta_min;指标策略在验证损失连续未改善超过容忍轮数后才降低学习率。
放入训练循环的位置
按轮次工作的调度器应在该轮所有批次完成后调用一次。ReduceLROnPlateau 则要先完成验证,再执行 scheduler.step(val_loss);若监控准确率,应把 mode 设为 "max"。
恢复训练时,除模型和优化器状态外,还要保存与加载 scheduler.state_dict()。否则学习率会从错误的阶段重新开始,续训曲线与原计划不一致。
按自己的节奏,确认真正理解。