
机器学习与深度学习 / 系统课时
冻结与解冻参数
冻结与解冻参数
替换输出层后,还要决定哪些参数参与训练。本课将通过 requires_grad 冻结主干、解冻高层特征块,并使用参数组给预训练层和新任务头配置不同学习率。
学习目标
- 理解冻结参数对梯度计算和更新的影响
- 选择性解冻指定网络层
- 使用优化器参数组设置分层学习率
冻结控制的本质
参数的 requires_grad=False 表示反向传播时不为它计算梯度,因此优化器不会更新该参数。冻结适合数据量较小或新旧任务相近的场景,可以减少训练成本,并降低预训练特征被快速破坏的风险。
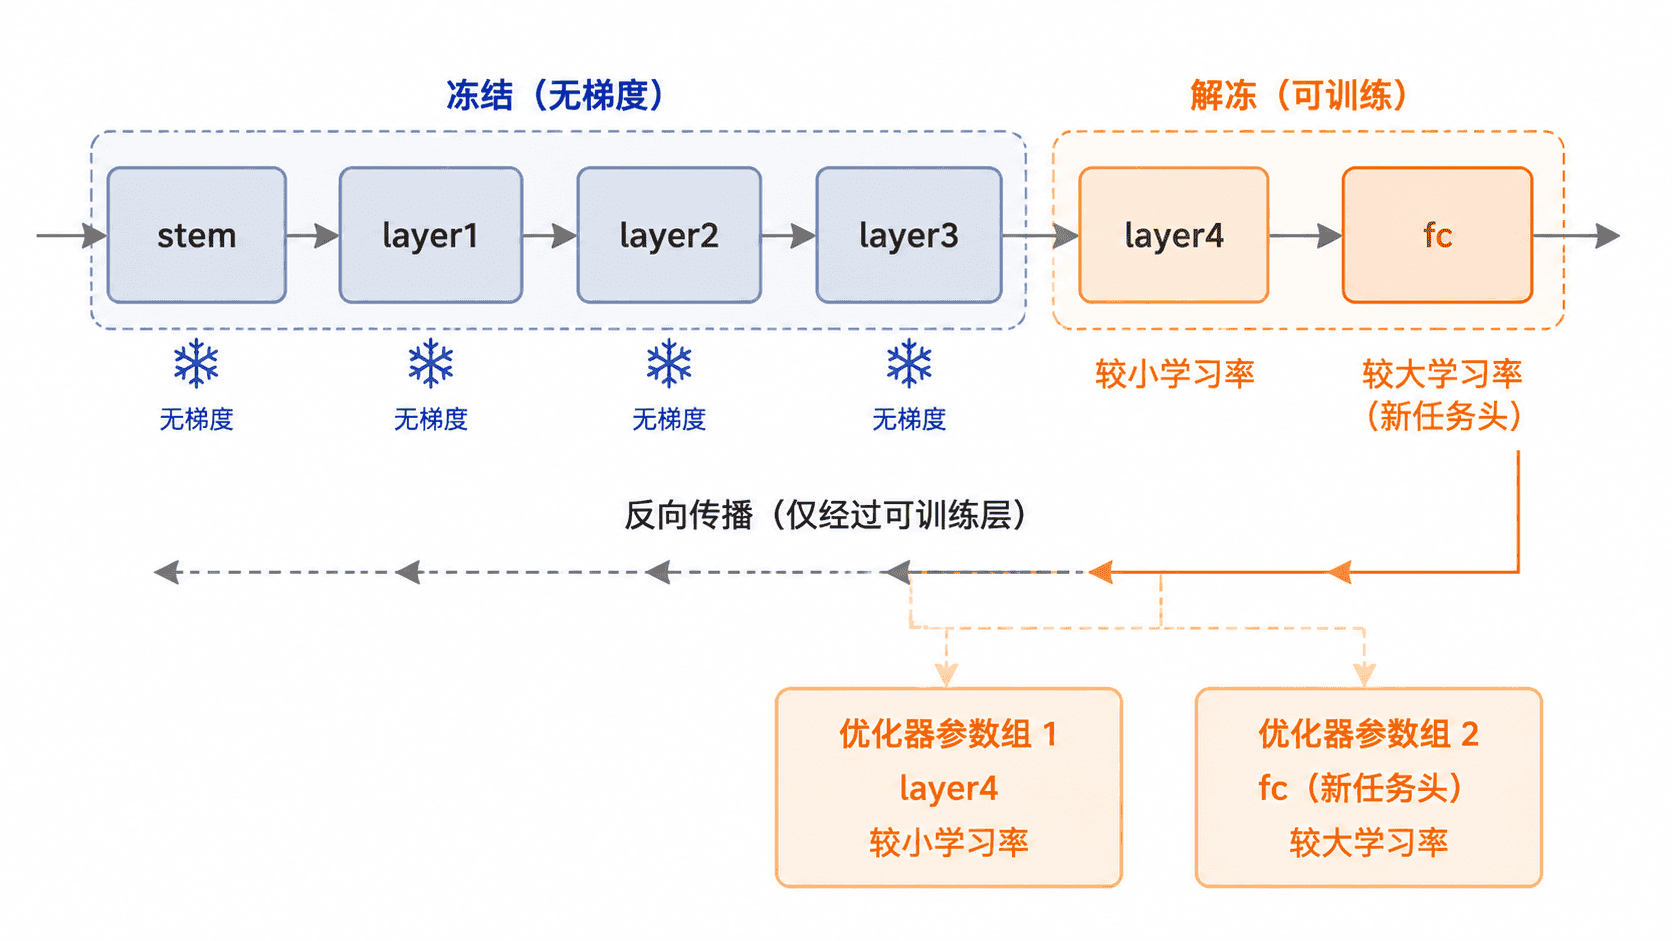
冻结不是删除网络层。前向计算仍会经过全部层,只是部分参数不保存梯度、不执行权重更新。实际训练时,通常先冻结大部分主干,只训练新任务头;模型稳定后,再解冻靠近输出端的高层特征块进行微调。
配置可训练层与参数组
下面冻结 ResNet18 的全部原始参数,然后替换分类头、解冻 layer4,并为 layer4 与 fc 设置不同学习率。示例还执行一次反向传播,直接检查各层是否产生梯度。
import torch
from torch import nn
from torch.optim import AdamW
from torchvision.models import ResNet18_Weights, resnet18

def main() -> None:
    model = resnet18(weights=ResNet18_Weights.DEFAULT)

    # 先冻结全部预训练参数,避免遗漏早期层。
    for parameter in model.parameters():
        parameter.requires_grad = False

    # 新创建的任务头默认可训练。
    model.fc = nn.Linear(model.fc.in_features, 3)

    # 只解冻靠近输出端的高层特征块。
    for parameter in model.layer4.parameters():
        parameter.requires_grad = True

    # 预训练层使用较小学习率,新任务头使用较大学习率。
    optimizer = AdamW(
        [
            {"params": model.layer4.parameters(), "lr": 1e-4},
            {"params": model.fc.parameters(), "lr": 1e-3},
        ],
        weight_decay=1e-4,
    )

    model.train()
    inputs = torch.randn(2, 3, 224, 224)
    targets = torch.tensor([0, 2])
    loss = nn.CrossEntropyLoss()(model(inputs), targets)

    optimizer.zero_grad()
    loss.backward()

    print(f"conv1 可训练: {model.conv1.weight.requires_grad}")
    print(f"layer4 可训练: {model.layer4[0].conv1.weight.requires_grad}")
    print(f"fc 可训练: {model.fc.weight.requires_grad}")
    print(f"参数组学习率: {[group['lr'] for group in optimizer.param_groups]}")
    print(f"conv1 是否无梯度: {model.conv1.weight.grad is None}")
    print(f"layer4 是否有梯度: {model.layer4[0].conv1.weight.grad is not None}")
    print(f"fc 是否有梯度: {model.fc.weight.grad is not None}")

if __name__ == "__main__":
    main()
预期输出
conv1 可训练: False
layer4 可训练: True
fc 可训练: True
参数组学习率: [0.0001, 0.001]
conv1 是否无梯度: True
layer4 是否有梯度: True
fc 是否有梯度: True结果说明早期卷积层保持冻结,layer4 和新分类头参与反向传播。参数组中的学习率相差 10 倍,让新任务头更快适配标签,同时让预训练特征以较小步幅调整。
何时逐步解冻
先只训练任务头,验证损失能够下降后,再按 layer4、layer3 的顺序逐步向前解冻,通常比一次性解冻全部层更稳定。新数据越多、与预训练数据差异越大,就越有理由解冻更多层。
每次改变可训练参数后,应重新检查优化器。若参数在优化器创建之后才被解冻,它不会自动进入已有参数组;最稳妥的做法是重新创建优化器,或显式调用 add_param_group 加入新参数。
容易忽略的边界
requires_grad=False 只冻结可学习参数,不会自动停止 BatchNorm 的运行均值和方差更新。模型处于 train() 模式时,冻结区域中的 BatchNorm 统计量仍可能变化;数据量很小时,可以把冻结区域的 BatchNorm 模块切换到 eval(),避免统计量漂移。
还要避免把同一参数重复放入多个参数组,否则优化器会报错。创建参数组前,可以按模块边界组织参数,并检查所有可训练参数是否恰好出现一次。