
机器学习与深度学习 / 系统课时
处理变长样本
处理变长样本
同一批样本的序列长度不一致时,DataLoader 无法直接堆叠张量。本课将实现自定义 collate_fn,在组批阶段完成截断、填充、长度记录和掩码生成,得到可直接送入序列模型的规则批次。
学习目标
- 理解变长样本不能直接组成批次的原因
- 使用
collate_fn完成截断、填充和标签整理 - 正确生成序列长度与有效位置掩码
为什么默认批处理会失败
DataLoader 的默认组批逻辑会尝试把多个样本沿新增的批次维度堆叠。这个操作要求每个张量形状完全一致,因此长度分别为 3、5、8 的一维序列不能直接组成形状为 [3, ?] 的张量。
处理位置应放在组批阶段,而不是提前把整个数据集永久填充到统一长度。这样可以按当前批次的最长样本动态填充,减少无效计算,也能集中维护截断规则和填充值。
设计批处理规则
一个完整的变长序列批次通常包含四部分:填充后的序列、截断后的真实长度、有效位置掩码和标签。先按最大允许长度截断,再按本批最长序列填充,最后根据长度生成掩码。
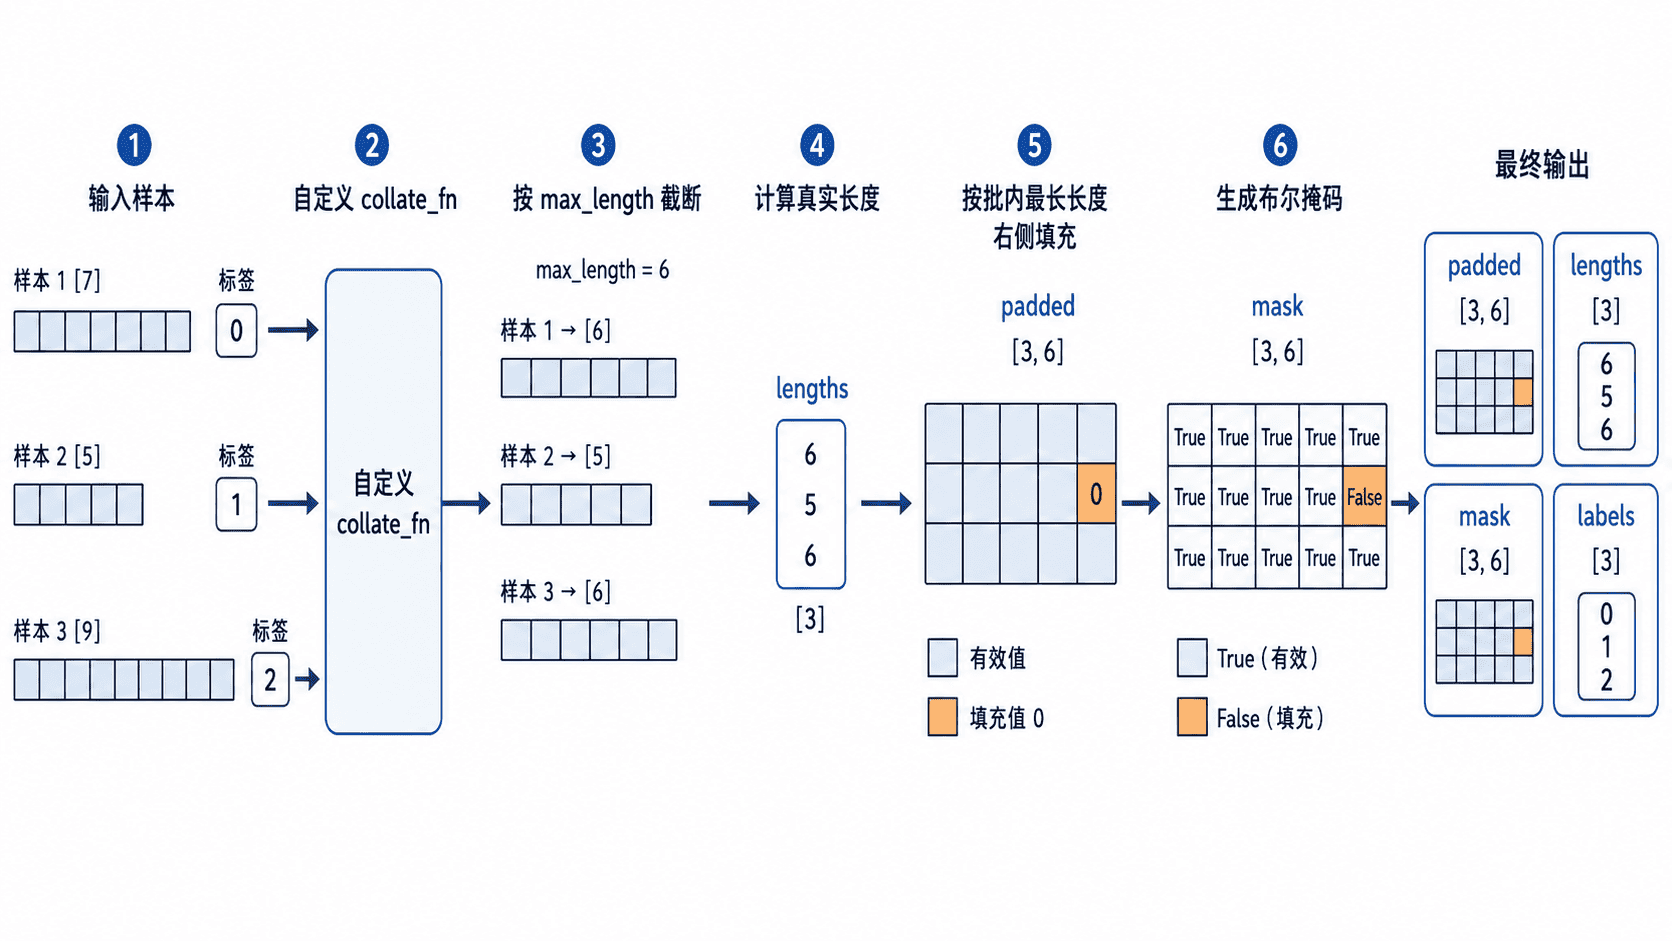
截断必须先于长度统计,否则记录的长度可能大于批次张量的实际宽度。掩码应根据长度生成,而不是简单判断元素是否等于填充值,因为某些数据中 0 本身也可能是有效值。
实现自定义 collate_fn
下面的完整示例把每个序列限制在 5 个元素以内,使用 0 右侧填充,并返回模型常用的四项批量数据。
import torch
from torch.nn.utils.rnn import pad_sequence
from torch.utils.data import DataLoader, Dataset

class SequenceDataset(Dataset):
    def __init__(self):
        self.samples = [
            (torch.tensor([1, 2, 3]), 0),
            (torch.tensor([4, 5]), 1),
            (torch.tensor([6, 7, 8, 9, 10, 11]), 0),
        ]

    def __len__(self):
        return len(self.samples)

    def __getitem__(self, index):
        return self.samples[index]

def collate_batch(batch, max_length=5, padding_value=0):
    sequences, labels = zip(*batch)

    # 先截断,再记录当前批次中每条序列的真实长度。
    truncated = [sequence[:max_length] for sequence in sequences]
    lengths = torch.tensor([len(sequence) for sequence in truncated])

    padded = pad_sequence(
        truncated,
        batch_first=True,
        padding_value=padding_value,
    )

    # 根据长度生成掩码,避免把数值 0 误判为填充位置。
    positions = torch.arange(padded.size(1)).unsqueeze(0)
    mask = positions < lengths.unsqueeze(1)

    return {
        "inputs": padded,
        "lengths": lengths,
        "mask": mask,
        "labels": torch.tensor(labels),
    }

def main():
    loader = DataLoader(
        SequenceDataset(),
        batch_size=3,
        shuffle=False,
        collate_fn=collate_batch,
    )

    batch = next(iter(loader))
    for name, value in batch.items():
        print(f"{name}:")
        print(value)

if __name__ == "__main__":
    main()
预期输出
inputs:
tensor([[ 1,  2,  3,  0,  0],
        [ 4,  5,  0,  0,  0],
        [ 6,  7,  8,  9, 10]])
lengths:
tensor([3, 2, 5])
mask:
tensor([[ True,  True,  True, False, False],
        [ True,  True, False, False, False],
        [ True,  True,  True,  True,  True]])
labels:
tensor([0, 1, 0])
在模型中使用批次信息
Transformer 类模型通常直接接收填充后的序列和掩码,使注意力层忽略填充位置。RNN 类模型可结合 lengths 使用打包序列,也可以在输出端按掩码排除无效时间步。
若任务需要从序列尾部截断、保留特殊起止标记或采用左侧填充,应把规则集中写在 collate_fn 中。数据集只负责返回单个原始样本,组批函数负责批次级形状整理,职责会更清晰。
边界检查
空序列会产生长度为 0 的样本,部分模型无法处理,应在数据清洗阶段拒绝或补入约定的特殊标记。标签、序列和附加特征必须使用相同的样本顺序,不能在组批时分别排序后失去对应关系。
当批内长度差异极大时,可先按长度分桶再组批,以减少填充比例。是否采用分桶取决于数据规模和性能需求,不应为了少量样本增加不必要的采样复杂度。