
机器学习与深度学习 / 系统课时
梯度累积
梯度累积
梯度累积通过连续处理多个小批次、延后参数更新,把显存压力限制在单个小批次范围内,同时模拟更大的有效批量。本课将实现完整训练循环,并处理损失缩放、清空梯度和优化器更新时机。
学习目标
- 理解微批量、累积步数与有效批量的关系
- 编写不会提前清空梯度的累积训练循环
- 识别梯度累积与真实大批量训练的差异
有效批量如何计算
设单次送入模型的微批量大小为 ,连续累积 次后再更新参数,则单设备有效批量为:
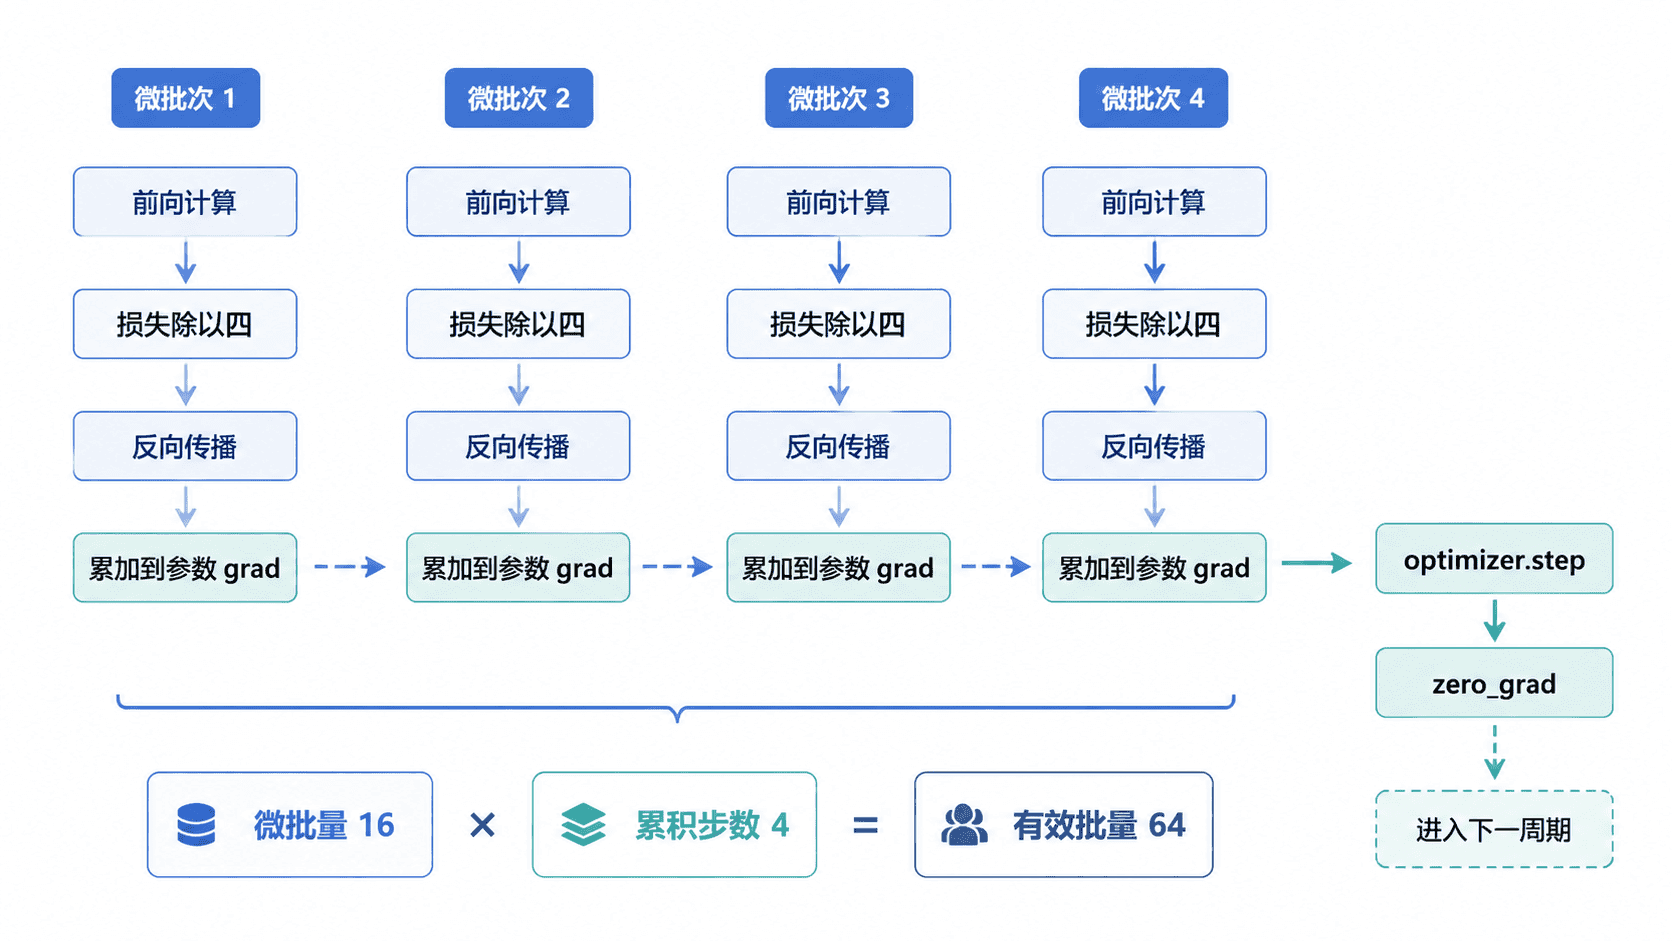
例如微批量为 16、累积 4 次,每次参数更新相当于聚合 64 个样本的梯度。显存中仍只需保存当前 16 个样本的激活值,但一次更新需要完成 4 次前向与反向传播。
完整训练示例
PyTorch 的 backward() 默认会把新梯度累加到参数的 .grad 中。关键是只在一个累积周期开始前清空梯度,并将每个微批次的损失除以累积步数,避免最终梯度被额外放大。
import torch
from torch import nn
from torch.utils.data import DataLoader, TensorDataset

torch.manual_seed(42)

micro_batch_size = 16
accumulation_steps = 4

features = torch.randn(256, 32)
labels = (features.sum(dim=1) > 0).long()
loader = DataLoader(
    TensorDataset(features, labels),
    batch_size=micro_batch_size,
    shuffle=False,
)

model = nn.Sequential(
    nn.Linear(32, 64),
    nn.ReLU(),
    nn.Linear(64, 2),
)
criterion = nn.CrossEntropyLoss()
optimizer = torch.optim.AdamW(model.parameters(), lr=1e-3)

optimizer.zero_grad(set_to_none=True)
optimizer_updates = 0

for step, (inputs, targets) in enumerate(loader, start=1):
    logits = model(inputs)
    loss = criterion(logits, targets) / accumulation_steps

    # backward 会把当前微批次的梯度累加到已有 grad
    loss.backward()

    if step % accumulation_steps == 0:
        optimizer.step()
        optimizer.zero_grad(set_to_none=True)
        optimizer_updates += 1

print(
    f"micro_batches={len(loader)}, "
    f"optimizer_updates={optimizer_updates}, "
    f"effective_batch_size={micro_batch_size * accumulation_steps}"
)
预期输出
micro_batches=16, optimizer_updates=4, effective_batch_size=64示例数据量能被累积步数整除,因此每个周期都有 4 个微批次。真实训练若最后不足一个完整周期,需要在循环结束时补做一次参数更新,并按实际参与累积的批次数调整损失缩放。
更新时机与常见错误
最常见的错误是在每个微批次开始时调用 zero_grad(),这样前面批次的梯度会被清除,累积不会发生。另一个错误是忘记将损失除以 accumulation_steps,它会让梯度幅度约扩大 倍,相当于意外改变学习率。
学习率调度器通常应与 optimizer.step() 同步,而不是每个微批次都调用一次。进行梯度裁剪时,也应在累积周期结束、参数更新之前执行,这样裁剪针对的是完整累积梯度。
与真实大批量的差异
梯度累积能近似聚合多个微批次的梯度,但不保证与一次性大批量完全等价。Batch Normalization 仍按每个微批量计算统计量,随机数据增强和随机层也会在多次前向中分别采样。
训练速度也不会按有效批量线性提升。它主要解决显存容量问题,代价是每次参数更新要执行多次前向和反向传播。若显存允许,直接增大批量通常能获得更高的硬件并行度。
验收检查
运行训练后,优化器更新次数应约等于微批次数除以累积步数。还应观察损失是否稳定下降,并确认每个累积周期中只有一次 optimizer.step() 和一次 zero_grad()。
修改微批量或累积步数时,应重新评估学习率、训练步数和 Batch Normalization 行为,不能只保持有效批量数值相同就假设训练结果完全一致。