
机器学习与深度学习 / 系统课时
数据预处理与转换
数据预处理与转换
本课构建一条可复用的数据预处理流程,把原始字段转换为模型可用张量,并正确处理归一化、类别编码和训练增强。最终将做到:统计量只从训练集计算,验证集复用同一规则,增强只作用于训练样本。
学习目标
- 完成数值类型转换、归一化和类别编码
- 区分训练阶段与验证阶段的转换行为
- 避免统计量泄漏和输出结构不一致
统一处理顺序与阶段差异
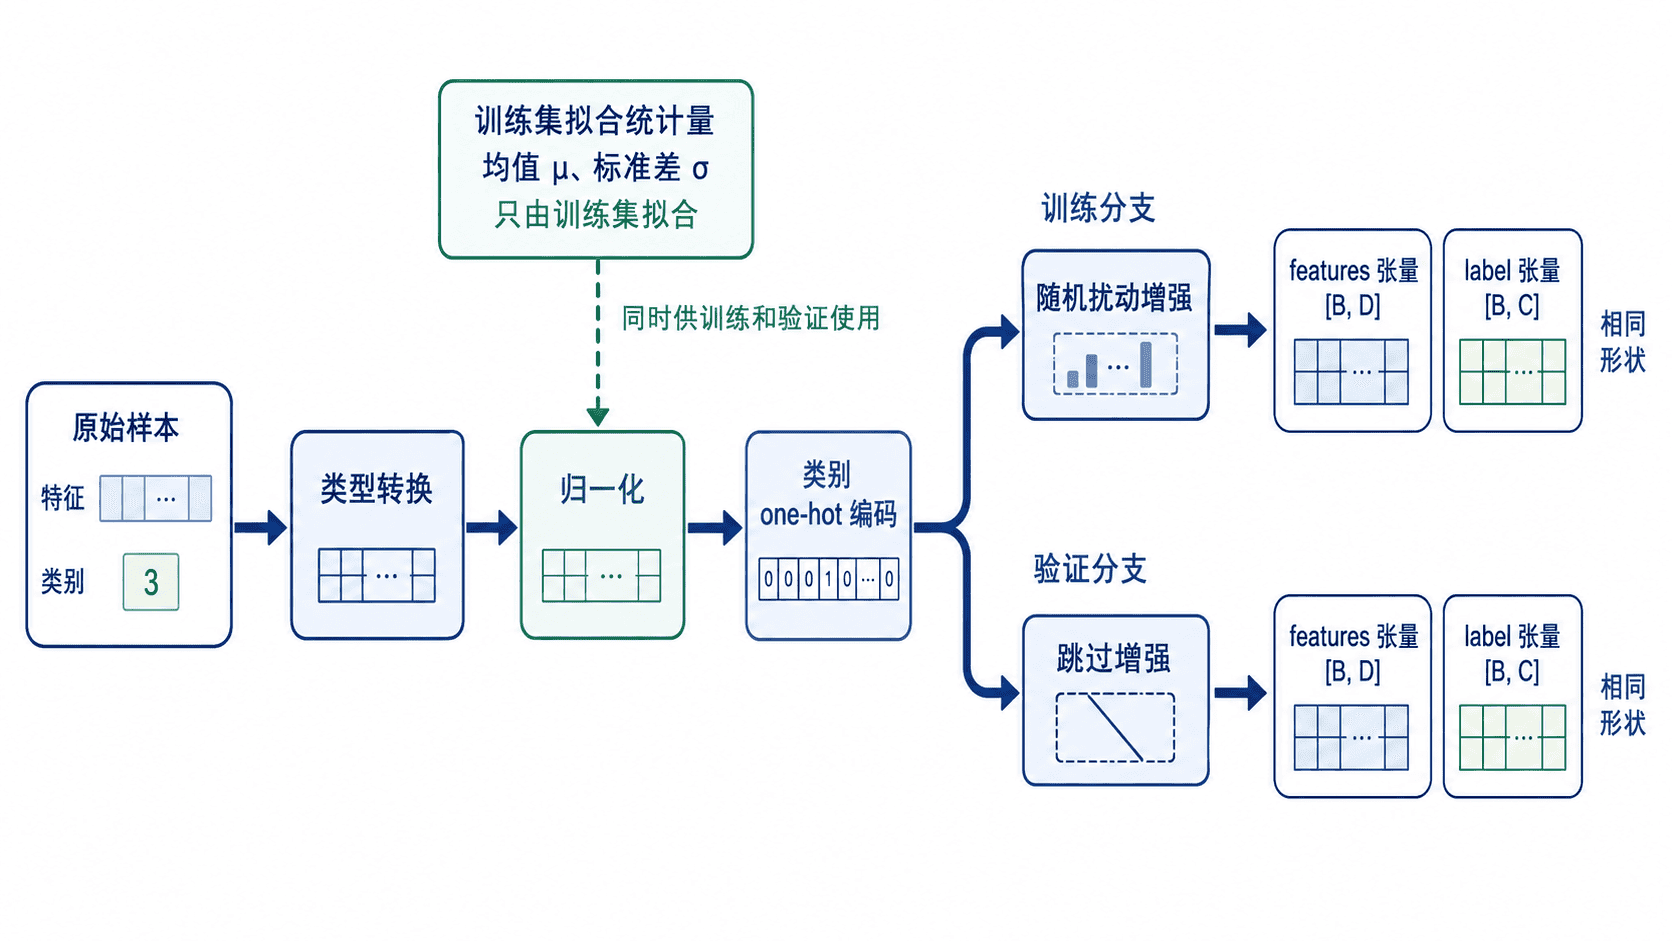
稳定的数据管道通常按“类型转换 → 数值归一化 → 类别编码 → 可选增强 → 组装张量”执行。顺序固定后,同一字段不会在不同数据集里出现不同含义,模型输入形状也更容易检查。
| 处理步骤 | 训练集 | 验证集 |
|---|---|---|
| 类型转换 | 执行 | 执行 |
| 归一化统计量 | 负责计算 | 只复用 |
| 类别映射 | 负责建立 | 只复用 |
| 随机增强 | 可以启用 | 必须关闭 |
| 输出形状 | 固定 | 与训练集一致 |
验证集不能重新计算均值、标准差或类别编号,否则评估过程会看到验证数据分布,形成数据泄漏;它也不能使用随机增强,否则同一模型重复评估可能得到不稳定结果。
实现可复用转换器
下面以交易数据为例。训练集先拟合金额均值、标准差和渠道映射,再创建训练与验证两个转换器。两者共享统计规则,只有训练转换器加入轻微随机扰动。
python
from typing import Any, Mapping, Sequence

import torch
import torch.nn.functional as F
from torch.utils.data import Dataset

class TransactionTransform:
    def __init__(
        self,
        mean: torch.Tensor,
        std: torch.Tensor,
        channel_to_id: dict[str, int],
        training: bool,
        generator: torch.Generator | None = None,
    ) -> None:
        self.mean = mean
        self.std = std.clamp_min(1e-6)
        self.channel_to_id = channel_to_id
        self.training = training
        self.generator = generator

    def __call__(
        self, record: Mapping[str, Any]
    ) -> tuple[torch.Tensor, torch.Tensor]:
        amount = torch.tensor(float(record["amount"]), dtype=torch.float32)
        amount = (amount - self.mean) / self.std

        # 只在训练阶段添加小扰动,验证阶段保持确定性。
        if self.training:
            noise = torch.randn((), generator=self.generator) * 0.05
            amount = amount + noise

        hour = torch.tensor(float(record["hour"]) / 23.0, dtype=torch.float32)
        channel_id = torch.tensor(
            self.channel_to_id[record["channel"]], dtype=torch.long
        )
        channel = F.one_hot(
            channel_id, num_classes=len(self.channel_to_id)
        ).to(torch.float32)

        features = torch.cat((amount.reshape(1), hour.reshape(1), channel))
        label = torch.tensor(int(record["is_fraud"]), dtype=torch.long)
        return features, label

class TransactionDataset(Dataset):
    def __init__(
        self,
        records: Sequence[Mapping[str, Any]],
        transform: TransactionTransform,
    ) -> None:
        self.records = list(records)
        self.transform = transform

    def __len__(self) -> int:
        return len(self.records)

    def __getitem__(self, index: int) -> tuple[torch.Tensor, torch.Tensor]:
        return self.transform(self.records[index])

def fit_preprocessing(
    records: Sequence[Mapping[str, Any]],
) -> tuple[torch.Tensor, torch.Tensor, dict[str, int]]:
    # 统计量和类别映射只能从训练记录拟合。
    amounts = torch.tensor(
        [float(record["amount"]) for record in records], dtype=torch.float32
    )
    mean = amounts.mean()
    std = amounts.std(unbiased=False)
    channels = sorted({str(record["channel"]) for record in records})
    channel_to_id = {name: index for index, name in enumerate(channels)}
    return mean, std, channel_to_id

def main() -> None:
    train_records = [
        {"amount": 100, "hour": 0, "channel": "app", "is_fraud": 0},
        {"amount": 300, "hour": 23, "channel": "web", "is_fraud": 1},
    ]
    validation_records = [
        {"amount": 200, "hour": 12, "channel": "app", "is_fraud": 0}
    ]

    mean, std, channel_to_id = fit_preprocessing(train_records)
    generator = torch.Generator().manual_seed(7)

    # 两个阶段共享统计量与映射,仅训练阶段开启增强。

    train_transform = TransactionTransform(
        mean, std, channel_to_id, training=True, generator=generator
    )
    validation_transform = TransactionTransform(
        mean, std, channel_to_id, training=False
    )

    train_dataset = TransactionDataset(train_records, train_transform)
    validation_dataset = TransactionDataset(
        validation_records, validation_transform
    )

    # 使用同一条记录比较增强前后,避免把样本差异误认为增强效果。
    augmented_features, _ = train_dataset[0]
    plain_features, _ = validation_transform(train_records[0])
    validation_features, _ = validation_dataset[0]

    print("训练均值/标准差:", mean.item(), std.item())
    print("训练特征形状:", tuple(augmented_features.shape))
    print("验证特征类型:", validation_features.dtype)
    print("验证金额标准化值:", validation_features[0].item())
    print("训练增强已生效:", not torch.allclose(
        augmented_features, plain_features
    ))

if __name__ == "__main__":
    main()
预期输出:
text
训练均值/标准差: 200.0 100.0
训练特征形状: (4,)
验证特征类型: torch.float32
验证金额标准化值: 0.0
训练增强已生效: True
处理边界并验证一致性
标准差可能为零,因此示例使用 clamp_min(1e-6) 避免除零。验证集中还可能出现训练阶段没见过的类别;生产代码应预留 unknown 编号,而不是临时扩展映射,否则输入维度和类别含义会改变。
增强函数必须保持标签语义不变。例如给数值添加很小噪声通常不会改变欺诈标签,但随机删除关键字段可能使样本失真。每种增强都应先定义允许范围,再通过固定随机种子验证可重复性。
验收时重点检查三件事:训练与验证输出形状相同;验证转换连续执行两次结果一致;归一化统计量和类别映射只由训练数据生成。模型上线时也应保存同一份统计量与映射,不能在推理阶段重新拟合。
预处理规则属于模型的一部分。只保存模型参数而不保存均值、标准差和类别映射,通常无法稳定复现训练时的输入含义。
按自己的节奏,确认真正理解。