
机器学习与深度学习 / 系统课时
导出模型
导出模型
训练完成后,模型只有被保存成部署端能够读取的产物,才能真正进入推理环境。本课将区分权重文件、PyTorch 导出图和 ONNX 三种交付方式,并用同一组输入交叉验证导出前后的数值结果。
学习目标
- 根据部署环境选择
state_dict、ExportedProgram或 ONNX - 完成模型导出、磁盘重载和跨运行时结果校验
- 识别输入形状、算子支持和预处理不一致等常见风险
先选择导出目标
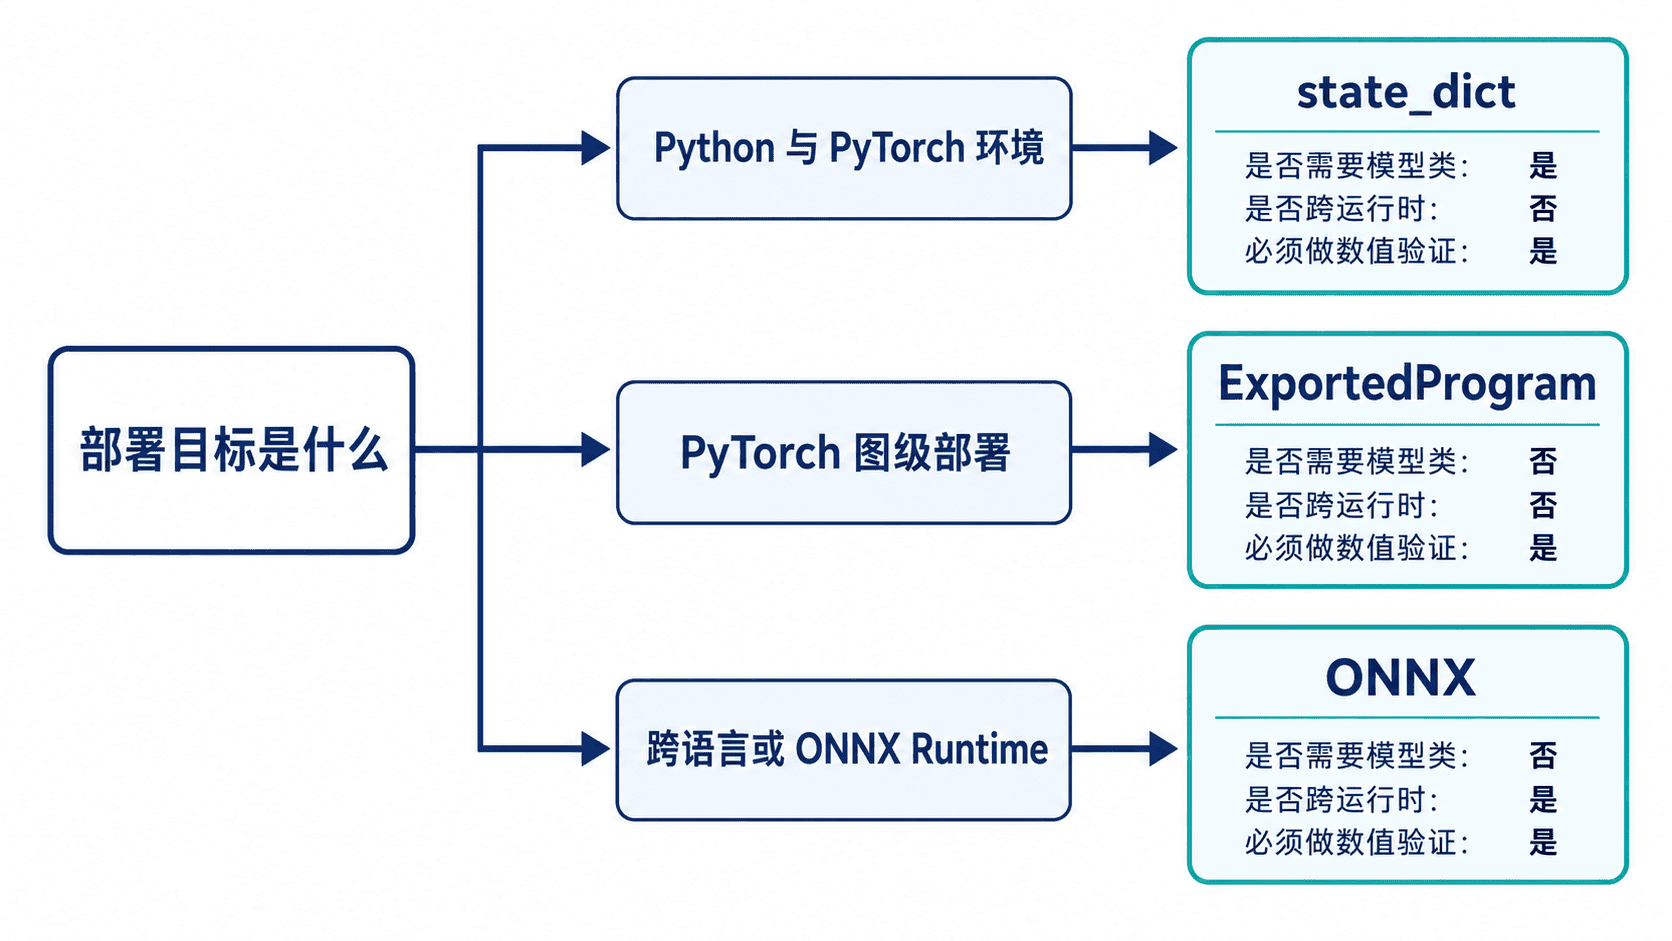
导出格式不是越通用越好,而是要与后续运行环境匹配。只要部署端仍使用 Python 和 PyTorch,保存权重通常最简单;需要提前得到可分析的计算图时可使用 torch.export;需要交给 ONNX Runtime 等其他运行时,则导出 ONNX。
| 产物 | 适合场景 | 主要限制 |
|---|---|---|
state_dict 权重 |
Python、PyTorch 服务,或继续训练 | 必须保留一致的模型类与参数结构 |
ExportedProgram |
PyTorch 生态内的图级优化和提前部署 | 只能捕获可导出的张量计算与约束 |
| ONNX | 跨语言、跨框架或专用推理运行时 | 目标运行时必须支持模型使用的算子 |
完整导出与交叉验证
下面的脚本使用一个小型分类器生成三种产物。运行环境需要已经安装 torch、numpy、onnx、onnxscript 和 onnxruntime。示例先从磁盘重新加载产物,再与原模型输出比较,避免只检查“文件是否存在”。
from pathlib import Path

import numpy as np
import onnxruntime as ort
import torch
from torch import nn

class TinyClassifier(nn.Module):
    def __init__(self) -> None:
        super().__init__()
        self.network = nn.Sequential(
            nn.Linear(4, 8),
            nn.ReLU(),
            nn.Linear(8, 3),
        )

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        return self.network(x)

torch.manual_seed(7)
model = TinyClassifier().eval()
example = torch.tensor([[1.0, 0.5, -0.5, 2.0]], dtype=torch.float32)

# 参考结果必须在 eval 模式下计算,避免随机层影响比较。
with torch.inference_mode():
    reference = model(example).numpy()

state_path = Path("classifier-state.pth")
export_path = Path("classifier.pt2")
onnx_path = Path("classifier.onnx")

torch.save(model.state_dict(), state_path)

reloaded_model = TinyClassifier()
reloaded_model.load_state_dict(
    torch.load(state_path, map_location="cpu", weights_only=True)
)
reloaded_model.eval()
with torch.inference_mode():
    state_output = reloaded_model(example).numpy()

exported = torch.export.export(model, (example,))
torch.export.save(exported, export_path)
export_output = torch.export.load(export_path).module()(example).detach().numpy()

onnx_program = torch.onnx.export(
    model,
    (example,),
    input_names=["features"],
    output_names=["logits"],
    dynamo=True,
)
onnx_program.save(onnx_path)

session = ort.InferenceSession(
    str(onnx_path),
    providers=["CPUExecutionProvider"],
)
onnx_output = session.run(
    None,
    {"features": example.numpy()},
)[0]

# 浮点计算允许极小误差,但不能只比较类别编号。
for name, output in {
    "state_dict": state_output,
    "torch_export": export_output,
    "onnx": onnx_output,
}.items():
    np.testing.assert_allclose(output, reference, rtol=1e-5, atol=1e-6)
    print(f"{name}: OK")

print([str(state_path), str(export_path), str(onnx_path)])
预期输出:
state_dict: OK
torch_export: OK
onnx: OK
['classifier-state.pth', 'classifier.pt2', 'classifier.onnx']
验证导出是否可用
第一步是验证文件能够从全新对象或目标运行时重新加载,而不是继续使用内存中的原模型。第二步是用代表性输入比较完整输出张量,并设置合理的相对误差与绝对误差。第三步是在实际部署设备上再运行一次,因为算子实现、数据类型和硬件后端都可能不同。
示例只覆盖形状为 (1, 4) 的输入。生产模型若允许可变批次、可变序列长度或可变图像尺寸,应在导出时声明相应约束,并至少测试最小值、常用值和最大值。只用一个理想样本通过,不代表全部合法输入都能运行。
常见失败与处理
出现结构不匹配时,先检查模型类、层名称和参数尺寸是否与保存权重时一致。state_dict 只保存参数,不会自动携带 Python 类定义和完整预处理流程。
ONNX 导出失败时,应先定位具体不支持的算子,再决定替换实现、拆分模型或升级目标运行时,而不是盲目修改导出参数。导出成功但结果偏差较大时,优先核对 eval()、输入归一化、通道顺序、数据类型和后处理逻辑。
设备迁移也要显式处理。为了得到可移植的基础产物,通常先在 CPU 上完成重载与一致性验证,再根据部署环境选择 CPU、CUDA 或其他执行后端。