
机器学习与深度学习 / 系统课时
池化与下采样
池化与下采样
本课解决卷积网络中特征图尺寸过大、计算量持续增长的问题。你将比较最大池化、平均池化与步幅卷积,掌握它们的尺寸计算、信息取舍和 PyTorch 写法,并能根据任务选择合适的下采样方式。
学习目标
- 使用
nn.MaxPool2d和nn.AvgPool2d缩小特征图 - 使用步幅卷积完成可学习的下采样
- 根据输出尺寸、信息保留和参数量选择方案
为什么需要下采样
卷积层通常保持或缓慢改变空间尺寸。如果特征图一直维持较大的高度和宽度,后续层的计算量与显存占用会迅速增加。下采样通过减小 ,让网络以更低成本处理更高层语义。
设输入尺寸为 ,卷积核或池化窗口为 ,步幅为 ,填充为 ,膨胀率为 ,输出尺寸为:
宽度方向使用同样的计算方式。最常见的 kernel_size=2, stride=2 会让高度和宽度各缩小一半,元素数量约降为原来的四分之一。
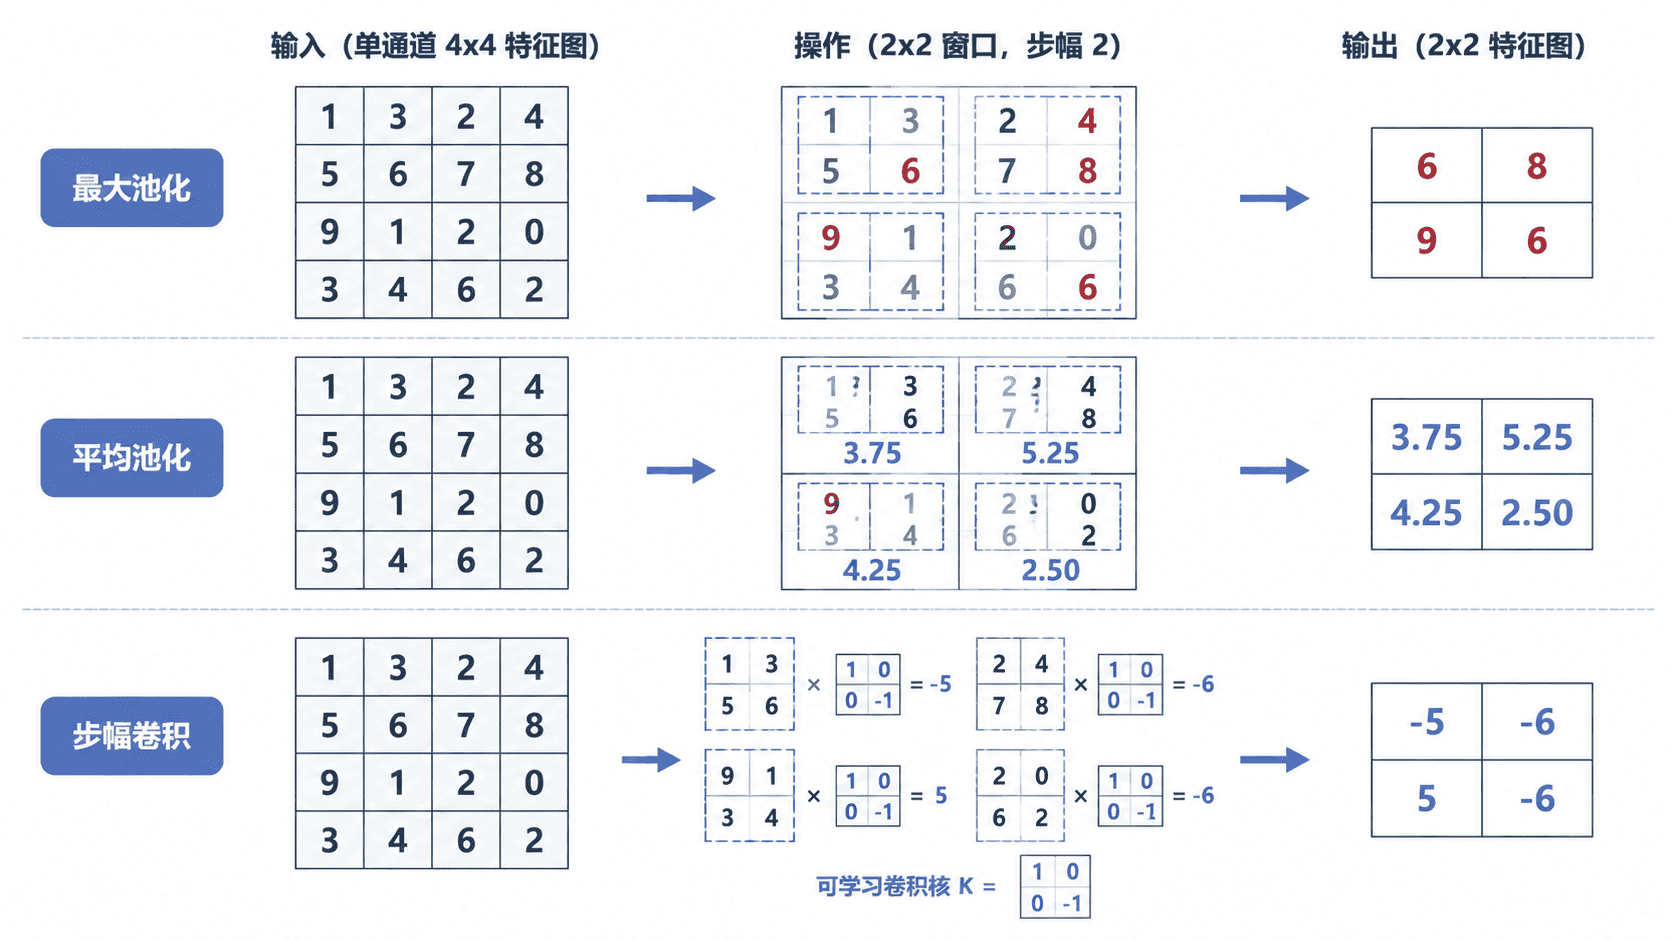
三种方式的核心差异
最大池化保留窗口内最强响应,适合强调边缘、纹理或显著激活;平均池化保留局部整体水平,结果更平滑;步幅卷积使用可训练卷积核,在缩小尺寸的同时学习应该保留什么信息。
| 方式 | 是否有参数 | 主要特点 | 常见用途 |
|---|---|---|---|
| 最大池化 | 否 | 保留局部强响应 | 基础 CNN 的空间压缩 |
| 平均池化 | 否 | 平滑并汇总局部信息 | 全局统计、轻量特征汇聚 |
| 步幅卷积 | 是 | 下采样规则可学习 | 现代卷积网络中的特征变换 |
池化不会改变通道数,步幅卷积则可以同时改变通道数。例如输入为 [N, 32, 64, 64] 时,nn.Conv2d(32, 64, 3, stride=2, padding=1) 会得到 [N, 64, 32, 32]。
PyTorch 主示例
下面对同一个 特征图执行三种下采样。步幅卷积的卷积核固定为全 1,便于直接观察每个窗口的求和结果。
import torch
from torch import nn

x = torch.arange(1, 17, dtype=torch.float32).reshape(1, 1, 4, 4)

max_pool = nn.MaxPool2d(kernel_size=2, stride=2)
avg_pool = nn.AvgPool2d(kernel_size=2, stride=2)

stride_conv = nn.Conv2d(
    in_channels=1,
    out_channels=1,
    kernel_size=2,
    stride=2,
    bias=False,
)
with torch.no_grad():
    stride_conv.weight.fill_(1.0)  # 固定权重,便于验证窗口计算

print("input shape:", x.shape)
print("max pool:\n", max_pool(x))
print("avg pool:\n", avg_pool(x))
print("stride conv:\n", stride_conv(x))
预期输出:
input shape: torch.Size([1, 1, 4, 4])
max pool:
 tensor([[[[ 6.,  8.],
          [14., 16.]]]])
avg pool:
 tensor([[[[ 3.5000,  5.5000],
          [11.5000, 13.5000]]]])
stride conv:
 tensor([[[[14., 22.],
          [46., 54.]]]], grad_fn=<ConvolutionBackward0>)
MaxPool2d 选取每个 区域的最大值,AvgPool2d 计算均值,步幅卷积则对窗口执行带权求和。实际训练时,卷积核权重由反向传播自动学习。
选择与边界
需要简单、稳定且无额外参数时,优先使用最大池化。希望平滑汇总特征时可使用平均池化。需要让模型自行决定保留哪些模式,或希望同步调整通道数时,使用步幅卷积更灵活。
下采样不宜过早或过密。连续多次减半会快速丢失小目标与精细位置。分类任务通常可以逐步压缩空间尺寸;检测、分割等密集预测任务则需要保留更多分辨率,或通过跳跃连接恢复细节。
提示:
ceil_mode=True会使用向上取整处理边界窗口,但可能让输出尺寸与常规公式不同。除非明确需要保留最后一个不完整窗口,否则保持默认值更容易控制网络结构。