
机器学习与深度学习 / 系统课时
数据管道的组成
数据管道的组成
训练代码不应直接把原始文件塞进模型。本课把一条完整数据管道拆成原始数据、样本转换、数据集、采样器和批量加载器,帮助你判断每个组件负责什么,并搭建一个可运行的最小批量读取流程。
学习目标
- 说明数据管道五个核心环节的职责和连接顺序
- 区分
Dataset、Sampler与DataLoader的边界 - 使用最小示例生成可直接送入模型的批次张量
从原始数据到训练批次
原始数据可以是图片文件、文本、表格或内存中的张量。它们通常不能直接进入模型,需要先定位单个样本,再执行解码、裁剪、归一化或张量转换,最后按训练策略组成批次。
一条常见链路是:原始数据由 Dataset 管理,样本转换在读取单个样本时执行,Sampler 决定本轮访问哪些索引及其顺序,DataLoader 根据索引取样并合并为批次。
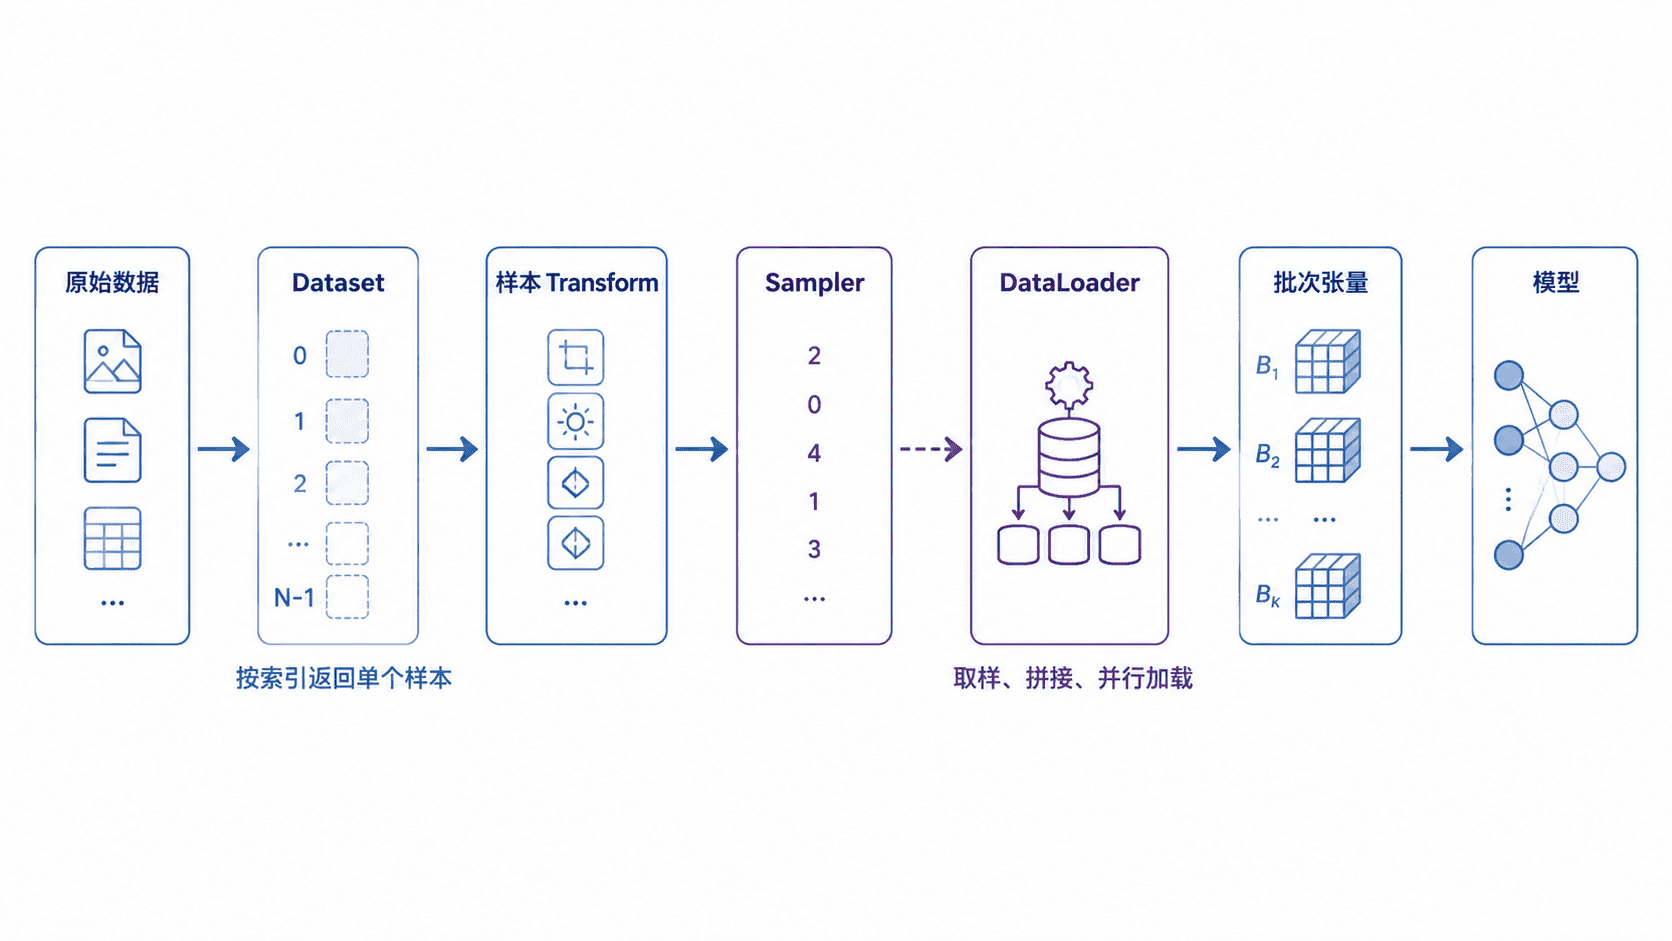
Dataset 定义单个样本
Dataset 解决的是“给定索引,如何得到一个样本”。映射式数据集通常实现 __len__() 和 __getitem__():前者返回样本总数,后者根据索引返回特征、标签或其他字段。
样本转换适合放在 __getitem__() 的读取路径中。这样每次取样时都能统一处理数据,也便于在训练集和验证集之间使用不同转换规则。
import torch
from torch.utils.data import DataLoader, Dataset, SequentialSampler

class NumberDataset(Dataset):
    def __init__(self) -> None:
        self.features = torch.arange(12, dtype=torch.float32).reshape(6, 2)

    def __len__(self) -> int:
        return len(self.features)

    def __getitem__(self, index: int) -> torch.Tensor:
        # 在返回样本前完成缩放,模拟常见的预处理步骤
        return self.features[index] / 10

dataset = NumberDataset()
sampler = SequentialSampler(dataset)
loader = DataLoader(dataset, batch_size=2, sampler=sampler)

for batch_index, batch in enumerate(loader):
    print(f"batch {batch_index}: shape={tuple(batch.shape)}, values={batch.tolist()}")
预期输出:
batch 0: shape=(2, 2), values=[[0.0, 0.10000000149011612], [0.20000000298023224, 0.30000001192092896]]
batch 1: shape=(2, 2), values=[[0.4000000059604645, 0.5], [0.6000000238418579, 0.699999988079071]]
batch 2: shape=(2, 2), values=[[0.800000011920929, 0.8999999761581421], [1.0, 1.100000023841858]]
浮点数的末尾可能因运行环境略有差异,但批次数量、形状和样本顺序应保持一致。
Sampler 与 DataLoader 如何协作
Sampler 只负责产生索引,不负责读取文件或执行转换。顺序采样器按 0, 1, 2... 返回索引;随机采样器会打乱顺序;更复杂的采样器还能实现类别均衡或分布式切分。
DataLoader 是调度者。它接收数据集和采样策略,按索引获取样本,再通过默认或自定义的 collate_fn 将多个样本拼成批次。配置 num_workers 后,它还可以使用多个工作进程并行准备数据。
| 组件 | 核心职责 | 不负责的内容 |
|---|---|---|
| 原始数据 | 保存真实样本内容 | 决定训练顺序 |
| Transform | 转换单个样本 | 组织批次 |
| Dataset | 根据索引返回样本 | 决定索引顺序 |
| Sampler | 生成访问索引 | 解码和转换样本 |
| DataLoader | 调度取样并组成批次 | 定义模型计算 |
关键边界与常见误区
设置 batch_size=32 不会改变数据集长度,只表示每次迭代最多返回 32 个样本。最后一个批次可能不足 32 个;只有设置 drop_last=True 才会丢弃这个不完整批次。
shuffle=True 是创建随机采样器的便捷方式。显式传入 sampler 时不要再同时设置 shuffle=True,否则配置含义冲突,DataLoader 会拒绝创建。
数据管道的性能瓶颈也不一定在模型。若 GPU 经常等待,应该检查文件读取、样本转换、批次拼接和工作进程数量,而不是只调整模型结构。