
机器学习与深度学习 / 系统课时
模型训练的完整流程
模型训练的完整流程
本课用一个可运行的线性回归示例,把数据准备、前向传播、损失计算、反向传播、参数更新与评估串成闭环。完成后,你能独立写出最小训练循环,并知道每一步为何不能省略。
学习目标
- 说清一次训练迭代中六个关键阶段的先后关系
- 编写包含训练模式、梯度清零、反向传播和参数更新的完整循环
- 正确切换评估模式,并在不记录梯度的情况下验证模型
训练闭环总览
模型训练不是单次函数调用,而是不断重复“取数据、算预测、算误差、求梯度、改参数”的过程。每轮参数更新都会改变下一次前向传播的结果,直到损失足够小或达到预设轮数。
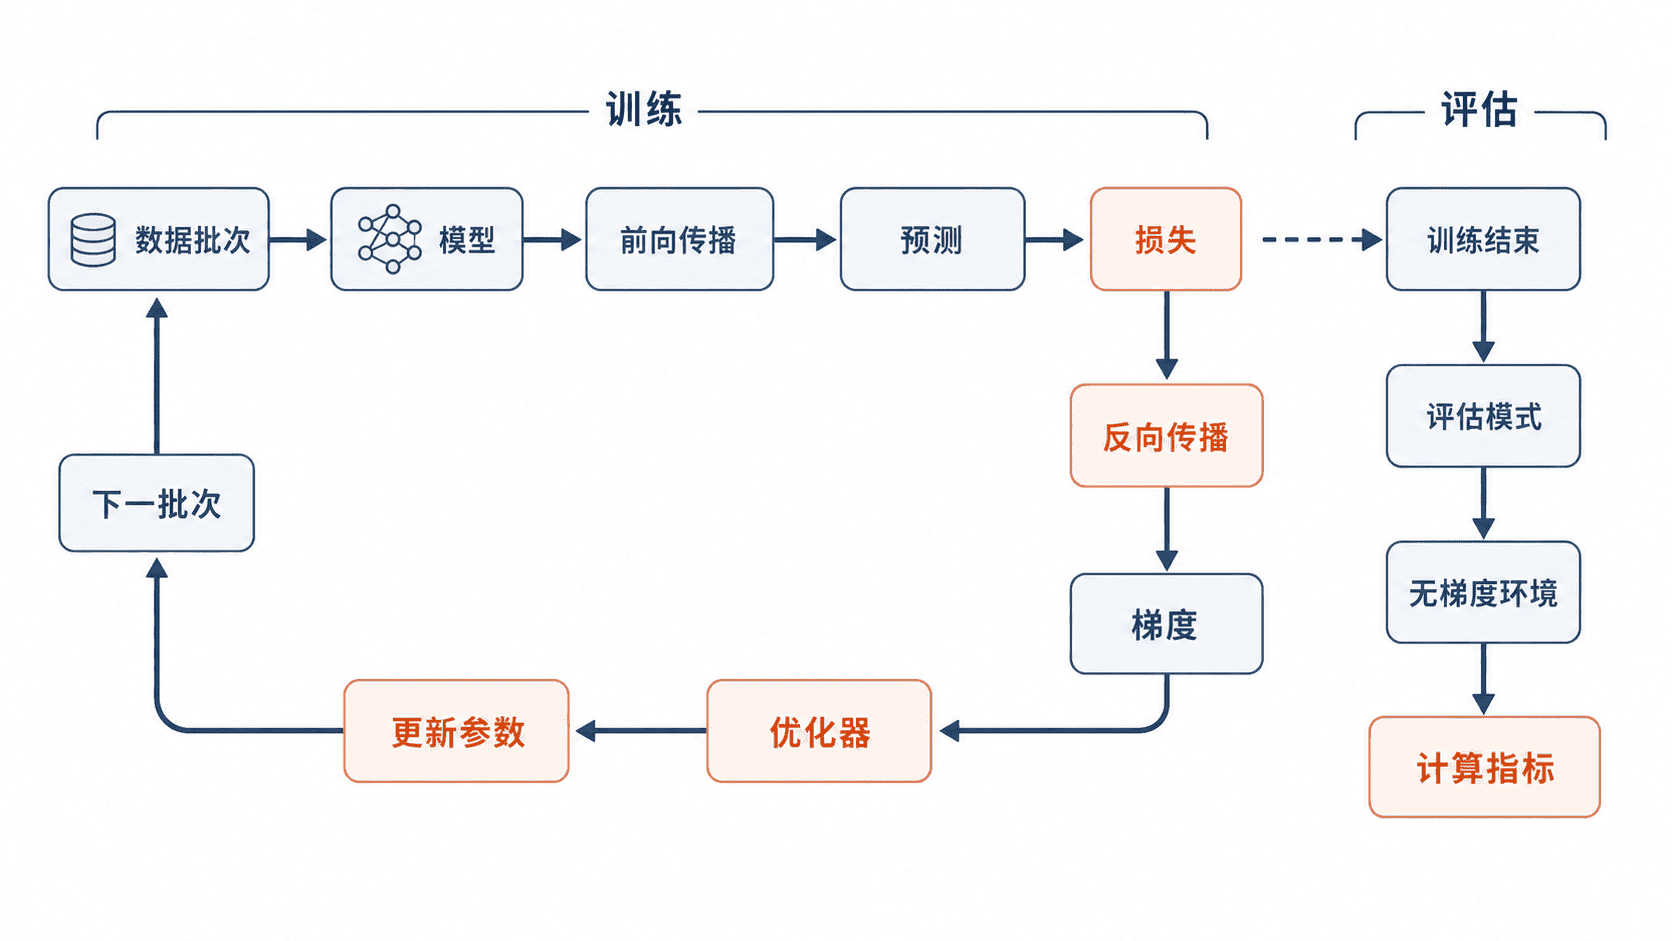
完整流程包含六个阶段:
- 数据准备:把样本组织成张量或批次,保证输入形状和数据类型符合模型要求。
- 前向传播:调用模型,根据当前参数计算预测值。
- 损失计算:用损失函数衡量预测值与真实值之间的差距。
- 梯度清零:清除上一轮保存在参数上的梯度,避免无意累加。
- 反向传播与更新:先通过
loss.backward()计算梯度,再由optimizer.step()修改参数。 - 模型评估:关闭训练专用行为和梯度记录,使用独立数据计算损失或业务指标。
用最小示例跑通训练
下面使用一元线性关系 构造数据。模型只有一个线性层,因此训练完成后,权重应接近 3,偏置应接近 2。
import torch
from torch import nn
from torch.utils.data import DataLoader, TensorDataset

torch.manual_seed(42)

# 构造无噪声数据,便于验证训练闭环是否正确。
x = torch.linspace(-1, 1, 200).unsqueeze(1)
y = 3 * x + 2
loader = DataLoader(
    TensorDataset(x, y),
    batch_size=32,
    shuffle=True,
)

model = nn.Linear(1, 1)
loss_fn = nn.MSELoss()
optimizer = torch.optim.SGD(model.parameters(), lr=0.1)

model.train()
for _ in range(100):
    for batch_x, batch_y in loader:
        predictions = model(batch_x)
        loss = loss_fn(predictions, batch_y)

        # PyTorch 默认累加梯度,因此每次反向传播前必须清零。
        optimizer.zero_grad()
        loss.backward()
        optimizer.step()

# 评估阶段不再构建反向传播所需的计算图。
model.eval()
with torch.no_grad():
    eval_loss = loss_fn(model(x), y).item()

assert eval_loss < 1e-6
assert abs(model.weight.item() - 3.0) < 0.05
assert abs(model.bias.item() - 2.0) < 0.05
print("训练与评估均通过")
预期输出:
训练与评估均通过断言同时验证了损失、权重和偏置。实际项目通常不会直接用训练集评估,而会准备独立验证集,以判断模型是否能处理未参与参数更新的数据。
六个步骤为何不能调换
前向传播必须先于损失计算,因为损失函数需要预测值。反向传播必须在损失得到后执行,因为计算图要从标量损失向前追踪各参数的贡献。
optimizer.zero_grad() 通常放在反向传播之前。PyTorch 会把新梯度加到参数现有的 .grad 中;若忘记清零,更新方向会混入前几批数据的梯度,训练结果可能偏离预期。
optimizer.step() 只能在 loss.backward() 之后调用。前者读取参数上的梯度并更新数值,后者负责真正计算梯度;优化器本身不会推导梯度。
训练与评估的边界
model.train() 和 model.eval() 用于切换模块行为。例如 Dropout 在训练时随机丢弃部分特征,在评估时必须关闭;BatchNorm 在两个模式下使用的统计方式也不同。
torch.no_grad() 控制是否记录自动微分信息,它不会自动把模型切换到评估模式。因此可靠的评估代码通常同时使用 model.eval() 和 with torch.no_grad():。
训练完成后还应保存模型参数、记录损失曲线,并在独立验证集上计算准确率、均方误差等指标。只有训练损失下降,并不能证明模型具有良好的泛化能力。