
机器学习与深度学习 / 系统课时
编写多轮训练循环
编写多轮训练循环
多轮训练循环需要反复遍历数据集,同时正确汇总每轮损失和指标。最终结果不只是“模型跑起来”,还要让每一行日志都具有一致口径,能够判断训练是否收敛并定位异常波动。
学习目标
- 区分训练轮次循环与批次循环的职责
- 按实际样本数汇总平均损失和平均绝对误差
- 输出格式稳定、便于比较的每轮训练日志
两层循环如何协作
外层循环控制训练轮次 epoch,内层循环消费 DataLoader 产生的每个批次。每个批次完成一次参数更新;当内层循环结束,才说明模型完整看过一遍训练集,可以计算本轮统计值并输出日志。
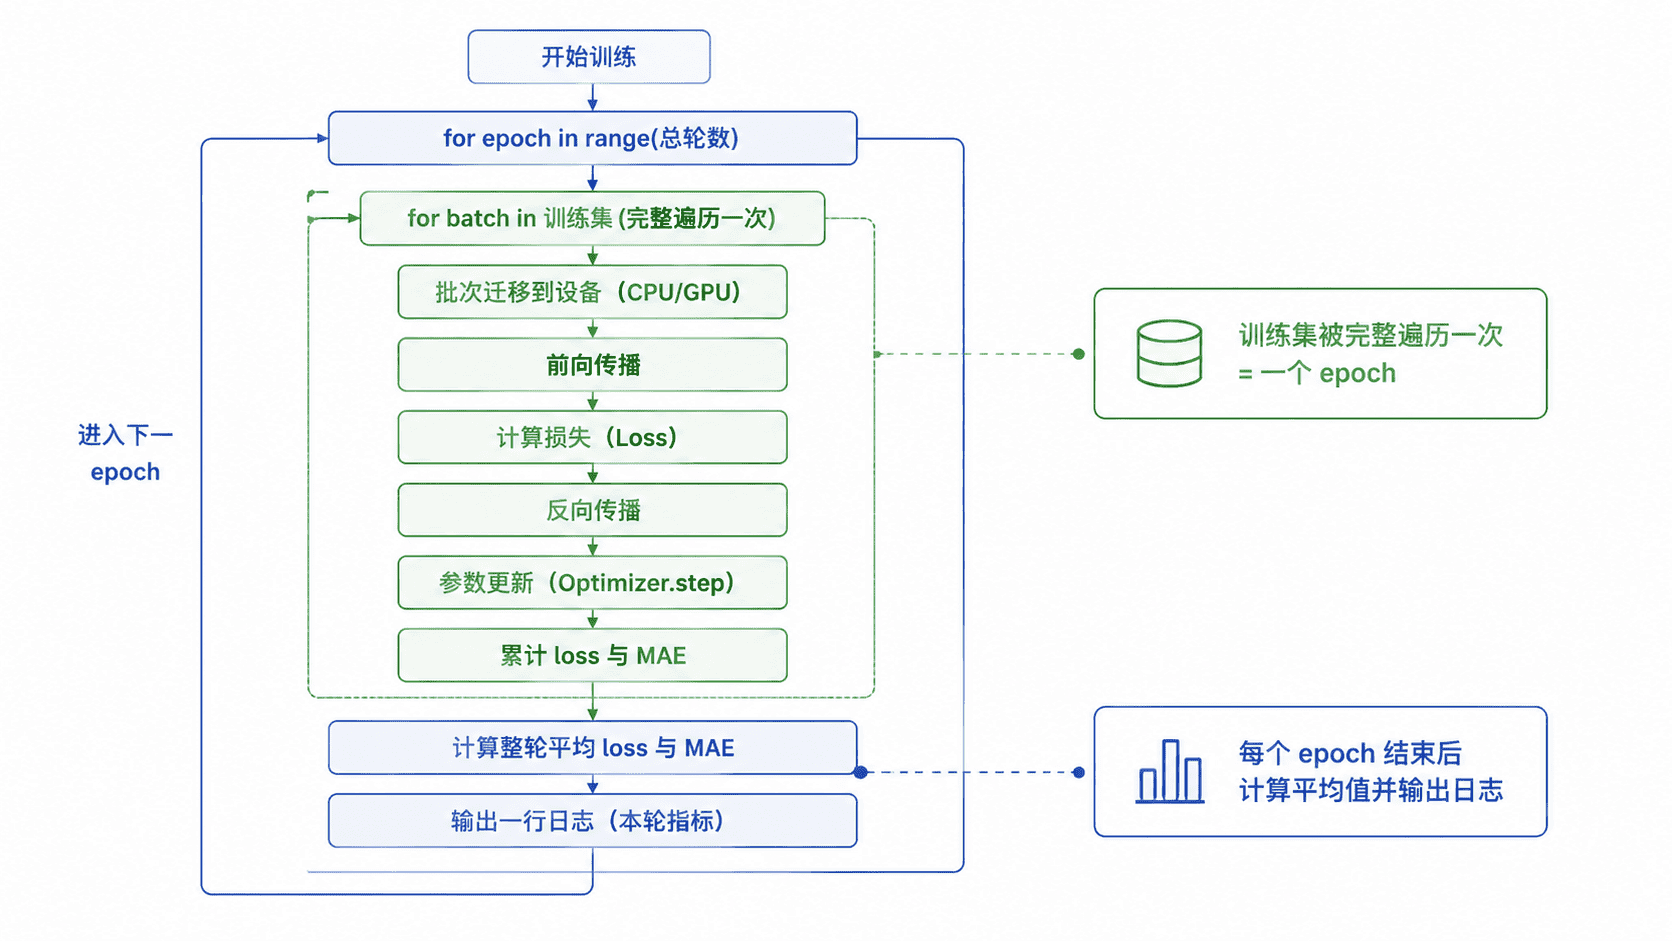
日志不应在每个批次都打印,否则数据量稍大就会产生大量噪声。通常在每轮结束时输出一次;需要排查单批次异常时,再临时增加更细粒度日志。
正确汇总损失和指标
MSELoss 默认返回当前批次的平均损失。若最后一个批次样本较少,直接对各批次损失再求平均会让小批次拥有过高权重。更稳妥的做法是先累加“批次平均损失 × 批次样本数”,最后再除以总样本数。
平均损失可写为 。平均绝对误差同样按所有样本的绝对误差总和计算,确保不同批次大小下的统计口径一致。
完整训练程序
下面构造一个线性关系数据集,训练五轮,并在每轮结束后输出平均损失和平均绝对误差。固定随机种子、数据顺序和 CPU 设备后,日志可以稳定复现。
python
import torch
from torch.utils.data import DataLoader, TensorDataset

def train_epoch(
    model,
    loader,
    criterion,
    optimizer,
    device,
):
    model.train()
    loss_sum = 0.0
    absolute_error_sum = 0.0
    sample_count = 0

    for batch_features, batch_targets in loader:
        batch_features = batch_features.to(device)
        batch_targets = batch_targets.to(device)

        optimizer.zero_grad()
        predictions = model(batch_features)
        loss = criterion(predictions, batch_targets)
        loss.backward()
        optimizer.step()

        # 按样本数加权,避免最后一个小批次扭曲均值
        batch_size = batch_features.size(0)
        loss_sum += loss.item() * batch_size
        absolute_error_sum += (
            predictions - batch_targets
        ).abs().sum().item()
        sample_count += batch_size

    return (
        loss_sum / sample_count,
        absolute_error_sum / sample_count,
    )

def main():
    torch.manual_seed(11)
    device = torch.device("cpu")

    features = torch.tensor([
        [0.0, 0.0],
        [1.0, 0.0],
        [0.0, 1.0],
        [1.0, 1.0],
        [2.0, 0.0],
        [0.0, 2.0],
        [2.0, 1.0],
        [1.0, 2.0],
    ])
    targets = 2 * features[:, :1] + 3 * features[:, 1:2] + 1

    loader = DataLoader(
        TensorDataset(features, targets),
        batch_size=4,
        shuffle=False,
    )

    model = torch.nn.Linear(2, 1).to(device)
    criterion = torch.nn.MSELoss()
    optimizer = torch.optim.SGD(model.parameters(), lr=0.05)

    for epoch in range(1, 6):
        average_loss, mae = train_epoch(
            model,
            loader,
            criterion,
            optimizer,
            device,
        )
        print(
            f"epoch={epoch:02d} "
            f"loss={average_loss:.4f} "
            f"mae={mae:.4f}"
        )

if __name__ == "__main__":
    main()
预期输出
text
epoch=01 loss=27.6414 mae=4.7075
epoch=02 loss=7.1508 mae=2.3469
epoch=03 loss=2.1686 mae=1.2365
epoch=04 loss=0.9430 mae=0.8320
epoch=05 loss=0.6230 mae=0.6610
损失和 MAE 连续下降,说明当前学习率与数据规模下训练正在收敛。训练指标来自参数更新前的批次预测,适合观察优化过程;它不能替代独立验证集上的评估结果。
日志与循环边界
轮次编号使用固定宽度 epoch=01,指标保留固定小数位,便于终端对齐、日志检索和后续解析。真实项目还可加入耗时、学习率和验证指标,但每个字段都应保持稳定名称与单位。
每轮开始时必须把 loss_sum、absolute_error_sum 和 sample_count 重新置零。若把这些变量定义在外层循环之外,日志会变成从第一轮开始的累计平均值,无法反映当前轮次的真实变化。
按自己的节奏,确认真正理解。