
机器学习与深度学习 / 系统课时
管理实验配置
管理实验配置
实验结果只有在配置可追溯时才有比较价值。本课将把模型、数据和训练参数移出代码,加入覆盖、校验、快照与环境记录,形成可复现的实验运行目录。
学习目标
- 将模型、数据和训练参数组织为外部配置
- 安全地应用命令行覆盖并阻止拼写错误
- 保存最终配置、环境信息和配置指纹
配置管理要解决的问题
把学习率、批次大小和模型宽度直接写在训练脚本中,会让代码修改与实验变化混在一起。几次运行后,很难确认某个结果究竟来自参数变化、数据变化,还是程序版本变化。
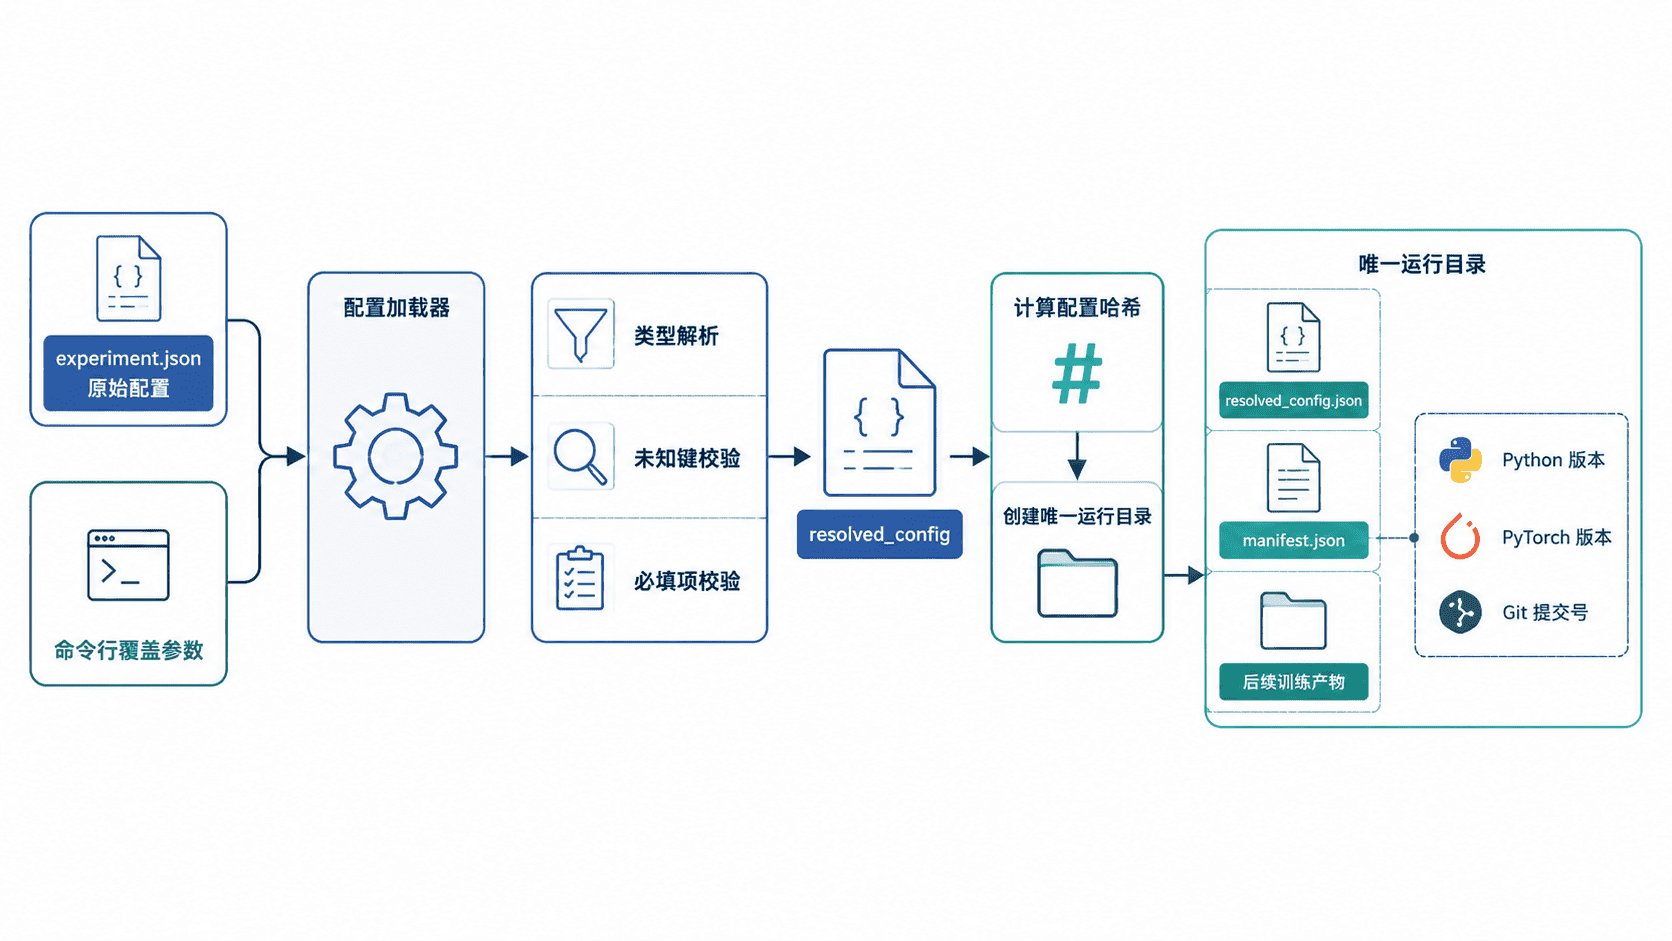
可复现配置需要保存三层信息:原始配置文件、命令行覆盖后的最终配置,以及运行环境与代码版本。真正用于复现实验的是最终配置,因此训练开始前就应把它写入独立运行目录。
划分配置边界
配置应描述会改变实验行为但不需要修改程序逻辑的内容,例如数据路径、模型结构、随机种子、优化器参数、训练轮数和设备选择。固定算法流程仍保留在代码中,避免把配置变成难以维护的脚本语言。
敏感信息不要写入实验配置,也不要随运行目录归档。访问密钥、数据库密码等应通过环境变量或密钥服务注入。路径最好使用项目相对路径;必须使用绝对路径时,应记录数据版本或校验值,避免同一路径指向不同内容。
准备外部配置文件
将下面内容保存为 experiment.json。JSON 虽然不支持注释,但格式严格、无需额外依赖,适合构建最小可复现方案。
{
  "experiment_name": "linear-baseline",
  "seed": 42,
  "data": {
    "train_path": "data/train.csv",
    "val_path": "data/val.csv"
  },
  "model": {
    "input_dim": 32,
    "hidden_dim": 128,
    "num_classes": 10
  },
  "train": {
    "epochs": 20,
    "batch_size": 64,
    "lr": 0.001,
    "weight_decay": 0.0001
  },
  "runtime": {
    "device": "auto",
    "deterministic": true
  }
}
加载后,程序应获得与文件层级一致的字典结构。验证方法是运行下一节脚本,并确认运行目录中的 resolved_config.json 包含全部字段及命令行覆盖后的值。
实现覆盖、校验与快照
下面的脚本支持 --set train.lr=0.0005 model.hidden_dim=256 形式的覆盖。它会拒绝不存在的键,使用 JSON 规则解析数字、布尔值和字符串,然后保存最终配置与环境清单。
import argparse
import hashlib
import importlib.metadata
import json
import platform
import subprocess
from copy import deepcopy
from datetime import datetime
from pathlib import Path
from typing import Any

REQUIRED_PATHS = (
    "experiment_name",
    "seed",
    "data.train_path",
    "data.val_path",
    "model.input_dim",
    "model.hidden_dim",
    "model.num_classes",
    "train.epochs",
    "train.batch_size",
    "train.lr",
)

def load_json(path: str) -> dict[str, Any]:
    with Path(path).open("r", encoding="utf-8") as file:
        return json.load(file)

def get_nested(config: dict[str, Any], dotted_key: str) -> Any:
    value: Any = config
    for part in dotted_key.split("."):
        if not isinstance(value, dict) or part not in value:
            raise KeyError(dotted_key)
        value = value[part]
    return value

def set_nested(config: dict[str, Any], dotted_key: str, raw_value: str) -> None:
    parts = dotted_key.split(".")
    target: dict[str, Any] = config

    for part in parts[:-1]:
        if part not in target or not isinstance(target[part], dict):
            raise KeyError(dotted_key)
        target = target[part]

    leaf = parts[-1]
    if leaf not in target:
        raise KeyError(dotted_key)

    # 使用 JSON 语义解析 0.001、true 和带引号字符串。
    try:
        target[leaf] = json.loads(raw_value)
    except json.JSONDecodeError:
        target[leaf] = raw_value

def validate(config: dict[str, Any]) -> None:
    for path in REQUIRED_PATHS:
        try:
            get_nested(config, path)
        except KeyError as error:
            raise ValueError(f"缺少配置项: {path}") from error

    if get_nested(config, "train.epochs") <= 0:
        raise ValueError("train.epochs 必须大于 0")
    if get_nested(config, "train.lr") <= 0:
        raise ValueError("train.lr 必须大于 0")

def git_commit() -> str:
    try:
        return subprocess.check_output(
            ["git", "rev-parse", "HEAD"],
            text=True,
            stderr=subprocess.DEVNULL,
        ).strip()
    except (FileNotFoundError, subprocess.CalledProcessError):
        return "unknown"

def package_version(name: str) -> str:
    try:
        return importlib.metadata.version(name)
    except importlib.metadata.PackageNotFoundError:
        return "not-installed"

def main() -> None:
    parser = argparse.ArgumentParser()
    parser.add_argument("--config", required=True)
    parser.add_argument("--set", nargs="*", default=[])
    args = parser.parse_args()

    resolved = deepcopy(load_json(args.config))
    for item in args.set:
        if "=" not in item:
            raise ValueError(f"覆盖项必须使用 key=value: {item}")
        key, value = item.split("=", 1)
        try:
            set_nested(resolved, key, value)
        except KeyError as error:
            raise ValueError(f"未知配置项: {key}") from error

    validate(resolved)

    canonical = json.dumps(
        resolved, ensure_ascii=False, sort_keys=True, separators=(",", ":")
    )
    config_hash = hashlib.sha256(canonical.encode("utf-8")).hexdigest()[:10]
    timestamp = datetime.now().strftime("%Y%m%d-%H%M%S")
    run_dir = Path("runs") / (
        f"{resolved['experiment_name']}-{timestamp}-{config_hash}"
    )
    run_dir.mkdir(parents=True, exist_ok=False)

    # 保存训练实际使用的配置,而不是只复制原始文件。
    (run_dir / "resolved_config.json").write_text(
        json.dumps(resolved, ensure_ascii=False, indent=2),
        encoding="utf-8",
    )
    manifest = {
        "created_at": datetime.now().isoformat(timespec="seconds"),
        "config_hash": config_hash,
        "python_version": platform.python_version(),
        "torch_version": package_version("torch"),
        "git_commit": git_commit(),
    }
    (run_dir / "manifest.json").write_text(
        json.dumps(manifest, ensure_ascii=False, indent=2),
        encoding="utf-8",
    )

    print(f"run_dir={run_dir}")
    print(f"train.lr={get_nested(resolved, 'train.lr')}")
    print(f"model.hidden_dim={get_nested(resolved, 'model.hidden_dim')}")
    print(f"config_hash={config_hash}")

if __name__ == "__main__":
    main()
执行脚本时覆盖两个参数:
python train.py --config experiment.json --set train.lr=0.0005 model.hidden_dim=256预期输出
run_dir=runs/linear-baseline-<TIME>-<ID>
train.lr=0.0005
model.hidden_dim=256
config_hash=<ID>
<TIME> 是运行时间,<ID> 是由最终配置计算出的十位哈希。运行目录中还应出现 resolved_config.json 和 manifest.json;相同最终配置会得到相同哈希,不同覆盖值会得到不同哈希。
保证实验可以公平比较
比较实验时,每次只改变计划研究的变量,并保持数据划分、随机种子、训练轮数和评估流程一致。配置哈希相同不代表训练结果一定逐位相同,但它能证明参数集合一致。
需要严格复现时,还要启用确定性算法、记录依赖版本、保存数据版本和代码提交号。某些 GPU 算子仍可能存在非确定性或性能差异,因此报告结果时应同时说明设备型号与重复运行次数。
常见错误与改进
直接复制原始配置文件会漏掉命令行覆盖,允许未知键则会把 train.lrr 之类的拼写错误静默变成无效参数。正确做法是先合并、再校验、后归档,并让训练代码只读取解析后的最终配置。
运行目录名称不要只使用实验名,否则重复运行会覆盖旧结果。时间戳便于定位,配置哈希便于判断参数是否一致;两者结合后,既适合人工浏览,也适合自动化脚本检索。