
机器学习与深度学习 / 系统课时
封装训练器
封装训练器
当训练脚本同时处理前向计算、反向传播、验证、日志和检查点时,代码会迅速变得难以复用。本课将实现一个最小可用的 Trainer,把稳定流程集中管理,同时把模型、数据和损失函数作为可替换依赖。
学习目标
- 划分训练器、模型、数据与回调的职责
- 封装训练轮次、验证、日志和检查点逻辑
- 运行并验收一个可复用的最小训练器
训练器的职责边界
训练器负责控制流程,不应了解具体业务特征含义。模型负责前向计算,数据加载器负责提供批次,损失函数负责计算目标,训练器只协调设备迁移、梯度更新、评估模式、日志和状态保存。
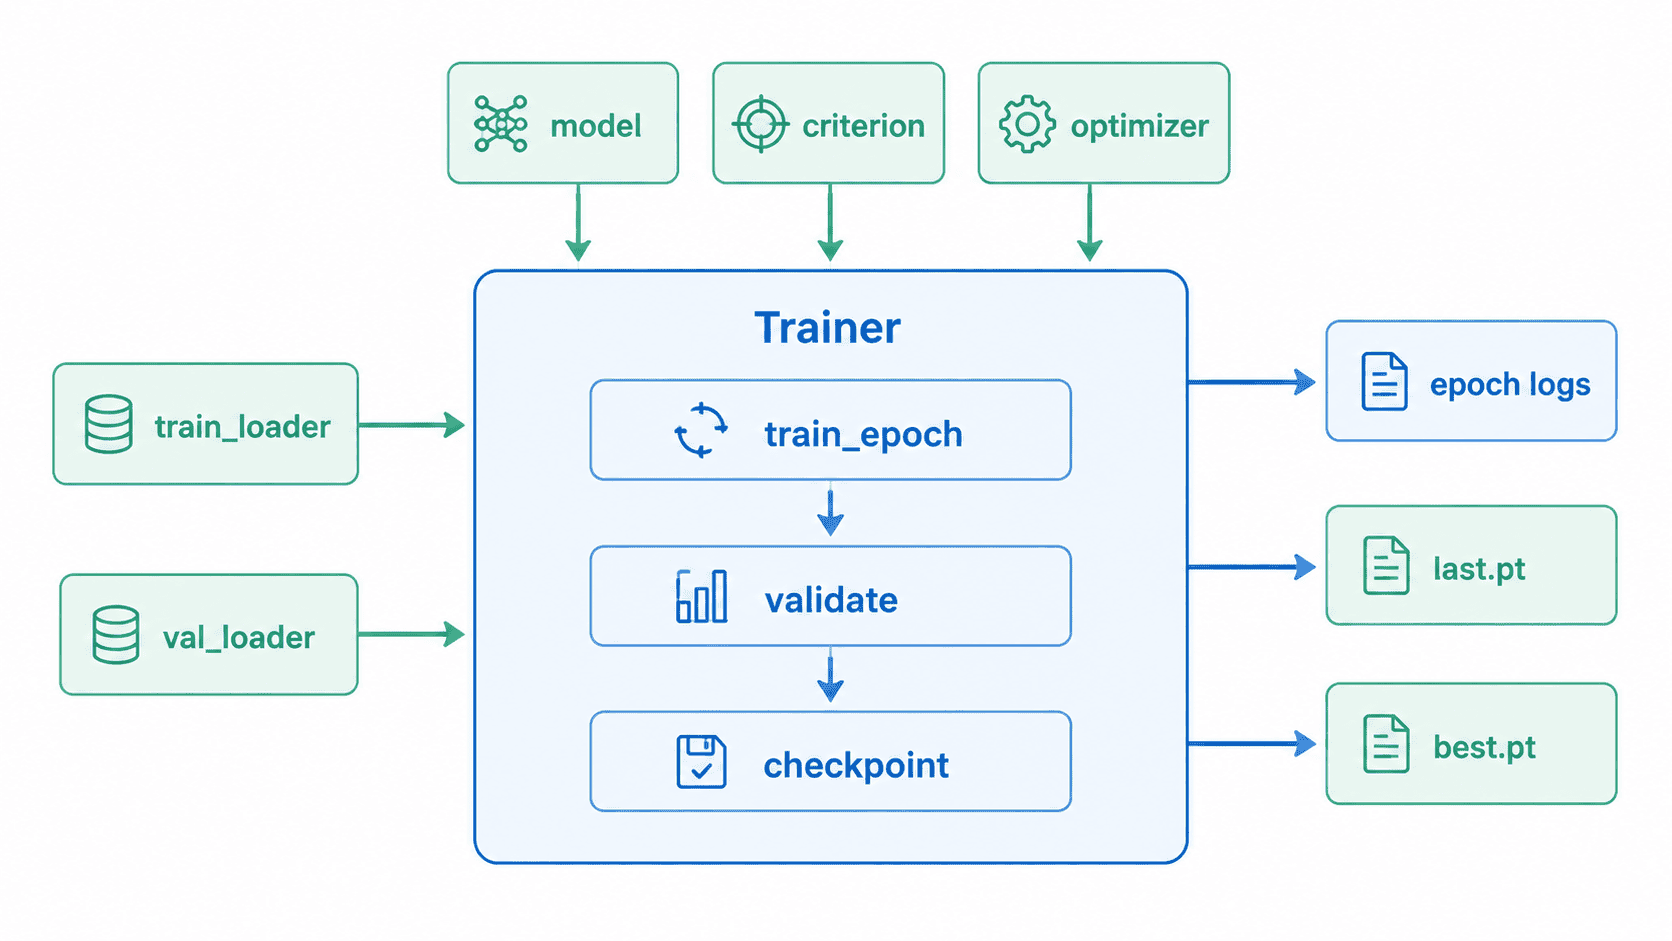
一个可维护的最小边界是:train_epoch() 只处理训练批次,validate() 只做无梯度评估,fit() 负责轮次编排,save_checkpoint() 负责持久化。后续增加混合精度、学习率调度器或早停时,也能在明确位置扩展。
实现最小可用 Trainer
下面示例可直接运行。日志函数通过构造参数注入,默认使用 print;检查点目录由训练器统一管理,每轮写入 last.pt,验证损失改善时额外写入 best.pt。
from collections.abc import Callable
from pathlib import Path

import torch
from torch import nn
from torch.optim import Optimizer
from torch.utils.data import DataLoader, TensorDataset

class Trainer:
    def __init__(
        self,
        model: nn.Module,
        optimizer: Optimizer,
        criterion: nn.Module,
        device: torch.device,
        checkpoint_dir: Path,
        log_fn: Callable[[str], None] = print,
    ) -> None:
        self.model = model.to(device)
        self.optimizer = optimizer
        self.criterion = criterion
        self.device = device
        self.checkpoint_dir = checkpoint_dir
        self.log_fn = log_fn
        self.best_val_loss = float("inf")
        self.checkpoint_dir.mkdir(parents=True, exist_ok=True)

    def train_epoch(self, loader: DataLoader) -> float:
        self.model.train()
        total_loss = 0.0

        for features, targets in loader:
            features = features.to(self.device)
            targets = targets.to(self.device)

            self.optimizer.zero_grad()
            predictions = self.model(features)
            loss = self.criterion(predictions, targets)
            loss.backward()
            self.optimizer.step()

            total_loss += loss.item() * features.size(0)

        return total_loss / len(loader.dataset)

    def validate(self, loader: DataLoader) -> float:
        self.model.eval()
        total_loss = 0.0

        # 验证阶段不构建梯度图,减少显存和计算开销
        with torch.no_grad():
            for features, targets in loader:
                features = features.to(self.device)
                targets = targets.to(self.device)
                predictions = self.model(features)
                loss = self.criterion(predictions, targets)
                total_loss += loss.item() * features.size(0)

        return total_loss / len(loader.dataset)

    def save_checkpoint(
        self,
        filename: str,
        epoch: int,
        metrics: dict[str, float],
    ) -> None:
        torch.save(
            {
                "model_state": self.model.state_dict(),
                "optimizer_state": self.optimizer.state_dict(),
                "epoch": epoch,
                "metrics": metrics,
            },
            self.checkpoint_dir / filename,
        )

    def fit(
        self,
        train_loader: DataLoader,
        val_loader: DataLoader,
        epochs: int,
    ) -> None:
        for epoch in range(epochs):
            train_loss = self.train_epoch(train_loader)
            val_loss = self.validate(val_loader)
            metrics = {
                "train_loss": train_loss,
                "val_loss": val_loss,
            }

            self.save_checkpoint("last.pt", epoch, metrics)
            if val_loss < self.best_val_loss:
                self.best_val_loss = val_loss
                self.save_checkpoint("best.pt", epoch, metrics)

            self.log_fn(
                f"epoch={epoch + 1} "
                f"train_loss={train_loss:.4f} "
                f"val_loss={val_loss:.4f}"
            )

torch.manual_seed(7)

features = torch.arange(0, 20, dtype=torch.float32).reshape(-1, 1)
targets = 3 * features + 2
dataset = TensorDataset(features, targets)

train_loader = DataLoader(dataset, batch_size=5, shuffle=True)
val_loader = DataLoader(dataset, batch_size=10, shuffle=False)

model = nn.Linear(1, 1)
optimizer = torch.optim.SGD(model.parameters(), lr=0.001)
criterion = nn.MSELoss()

trainer = Trainer(
    model=model,
    optimizer=optimizer,
    criterion=criterion,
    device=torch.device("cpu"),
    checkpoint_dir=Path("trainer_checkpoints"),
)
trainer.fit(train_loader, val_loader, epochs=3)

print(
    "checkpoint files:",
    sorted(path.name for path in Path("trainer_checkpoints").glob("*.pt")),
)
预期输出:
epoch=1 train_loss=<TRAIN_LOSS> val_loss=<VAL_LOSS>
epoch=2 train_loss=<TRAIN_LOSS> val_loss=<VAL_LOSS>
epoch=3 train_loss=<TRAIN_LOSS> val_loss=<VAL_LOSS>
checkpoint files: ['best.pt', 'last.pt']
损失值会受 PyTorch 版本和底层计算实现影响,因此用占位符表示;实际运行时应看到三个轮次日志,并生成两个检查点文件。
运行流程与验收
fit() 每轮先调用 train_epoch(),再调用 validate()。训练阶段必须执行 model.train() 和梯度更新;验证阶段必须执行 model.eval() 与 torch.no_grad(),否则 Dropout、BatchNorm 或梯度图行为可能不符合预期。
验收时重点检查三点:每个轮次只记录一次汇总日志;last.pt 每轮都会更新;best.pt 只在验证损失改善时更新。还可加载检查点,核对其中是否包含 model_state、optimizer_state、epoch 和 metrics。
扩展时避免过度封装
训练器可以继续接入学习率调度器、混合精度、梯度裁剪和早停,但不要把业务数据预处理或模型内部逻辑塞进训练器。通用流程放在训练器,任务差异通过构造参数、回调或子类扩展,才能在多个项目间复用。
当一个批次不再是简单的 (features, targets) 时,可新增 training_step(batch) 回调,让任务代码解释批次结构,而训练器继续负责优化器和轮次控制。这比在训练器内部堆积大量条件分支更稳定。