
机器学习与深度学习 / 系统课时
定义模型类
定义模型类
自定义 PyTorch 模型的核心,是继承 nn.Module,在初始化阶段注册网络层,在 forward 中描述张量如何流动。本课将完成一个可直接运行的分类模型,并解释 model(x) 背后的调用过程。
学习目标
- 能继承
nn.Module定义自定义模型。 - 能区分
__init__与forward的职责。 - 能通过一次前向传播验证模型输入输出。
模型类的两个职责
__init__ 用于声明模型包含哪些层、参数和子模块。所有需要参与训练或保存的层,都应赋值给 self,这样 PyTorch 才能自动注册它们。
forward 用于描述输入张量经过这些模块的顺序。它只关心前向计算,不负责手动收集参数,也不需要显式编写反向传播逻辑。
定义构造方法时必须先调用 super().__init__()。缺少这一步,子模块和参数的注册机制无法正确初始化。层也不能只保存在局部变量中,应使用 self.layer、nn.Sequential 或 nn.ModuleList 持有。
编写可运行的模型
下面定义一个两层全连接分类器。输入特征数为 4,隐藏层宽度为 8,最终输出 3 个类别的原始分数。
python
import torch
from torch import nn

class SimpleClassifier(nn.Module):
    def __init__(self, input_dim: int, hidden_dim: int, num_classes: int):
        super().__init__()

        # 子模块赋值给 self 后,会被自动注册到当前模型
        self.network = nn.Sequential(
            nn.Linear(input_dim, hidden_dim),
            nn.ReLU(),
            nn.Linear(hidden_dim, num_classes),
        )

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        # forward 只描述张量的计算路径
        return self.network(x)

if __name__ == "__main__":
    torch.manual_seed(0)

    model = SimpleClassifier(input_dim=4, hidden_dim=8, num_classes=3)
    batch = torch.randn(2, 4)
    logits = model(batch)

    print(model.__class__.__name__)
    print(tuple(logits.shape))
    print(logits.requires_grad)
预期输出
text
SimpleClassifier
(2, 3)
True
输出形状 (2, 3) 表示批次中有 2 个样本,每个样本得到 3 个类别分数。requires_grad 为 True,说明结果连接着可求导的参数计算图。
理解调用链并排查形状
实际使用时应写 model(batch),而不是直接调用 model.forward(batch)。前者会先进入 nn.Module.__call__,由框架处理前向钩子和调用包装逻辑,再调用模型实现的 forward。
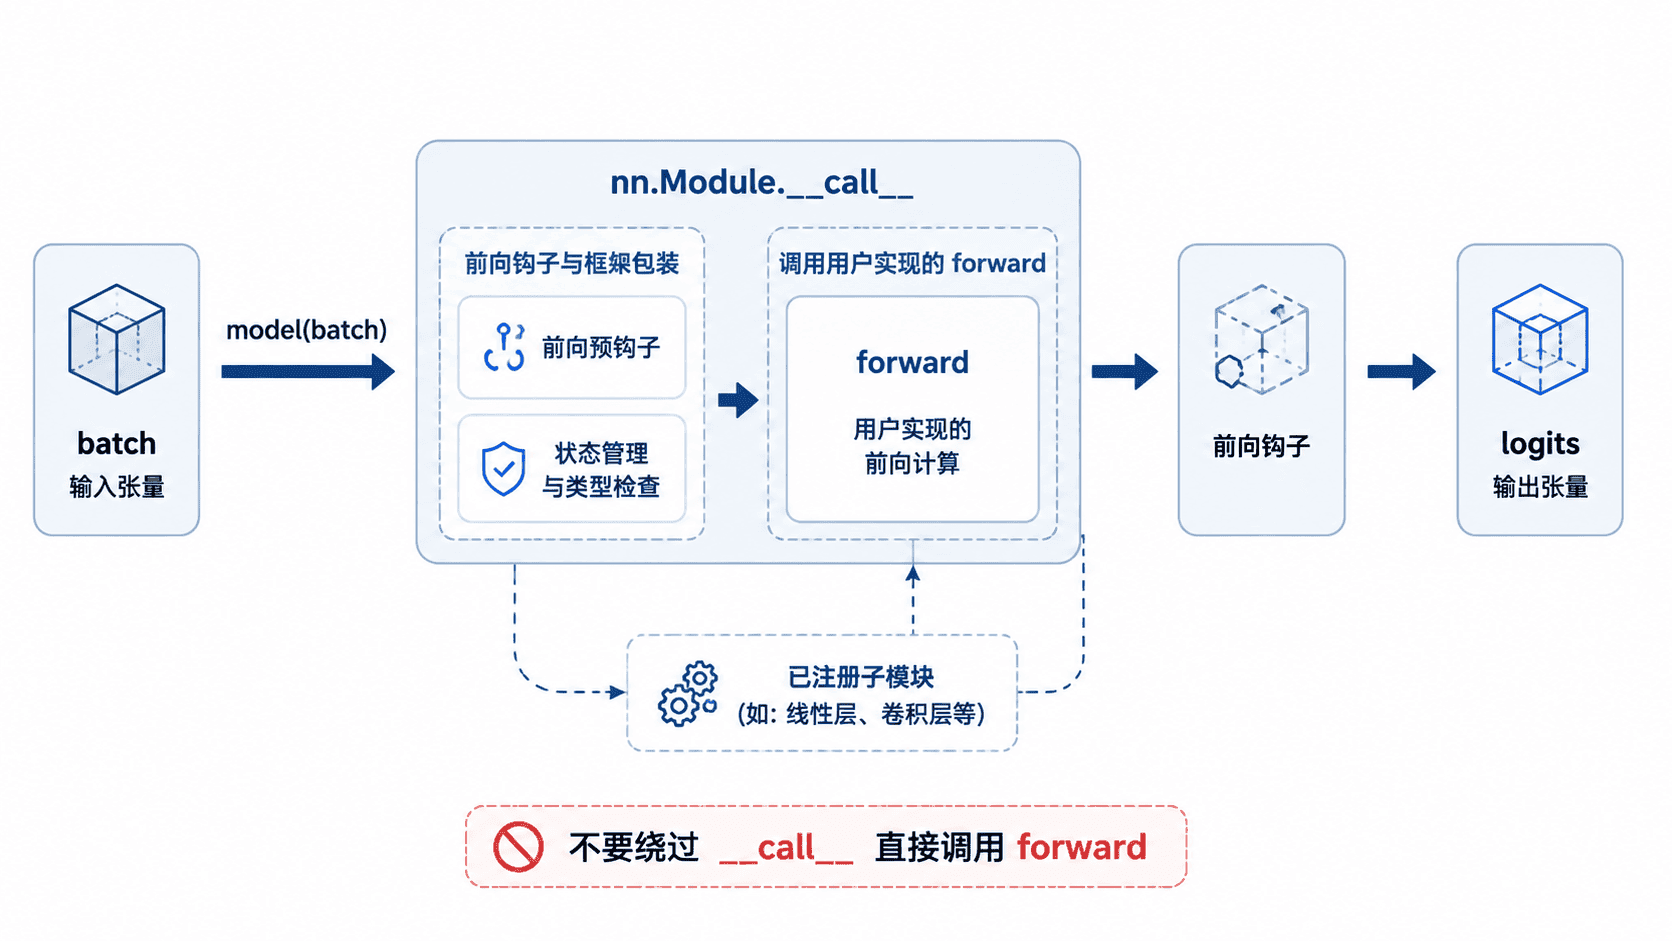
这条调用链让自定义模型只需实现计算逻辑,同时继续使用 nn.Module 提供的训练、保存、设备迁移和钩子能力。前向传播报错时,先打印输入形状,再检查每一层要求的最后一维;本例第一层要求输入最后一维必须是 4。
按自己的节奏,确认真正理解。