
机器学习与深度学习 / 系统课时
残差连接
残差连接
残差连接让卷积模块不必直接学习完整映射,而是只学习输入需要修正的部分。本课将从计算路径和梯度传播两个角度理解其作用,并用 PyTorch 实现支持恒等捷径与投影捷径的残差模块。
学习目标
- 理解残差映射
F(x) + x的含义 - 说明捷径分支为何有助于深层网络训练
- 实现并验证一个基础残差模块
从完整映射到残差映射
普通卷积模块直接学习目标映射 H(x)。残差模块把它改写为:
其中,F(x) 是卷积分支学习到的修正量,x 通过捷径分支直接传到输出。当理想变换接近恒等映射时,卷积分支只需把 F(x) 学到接近 0,比重新拟合整个 H(x) 更容易。
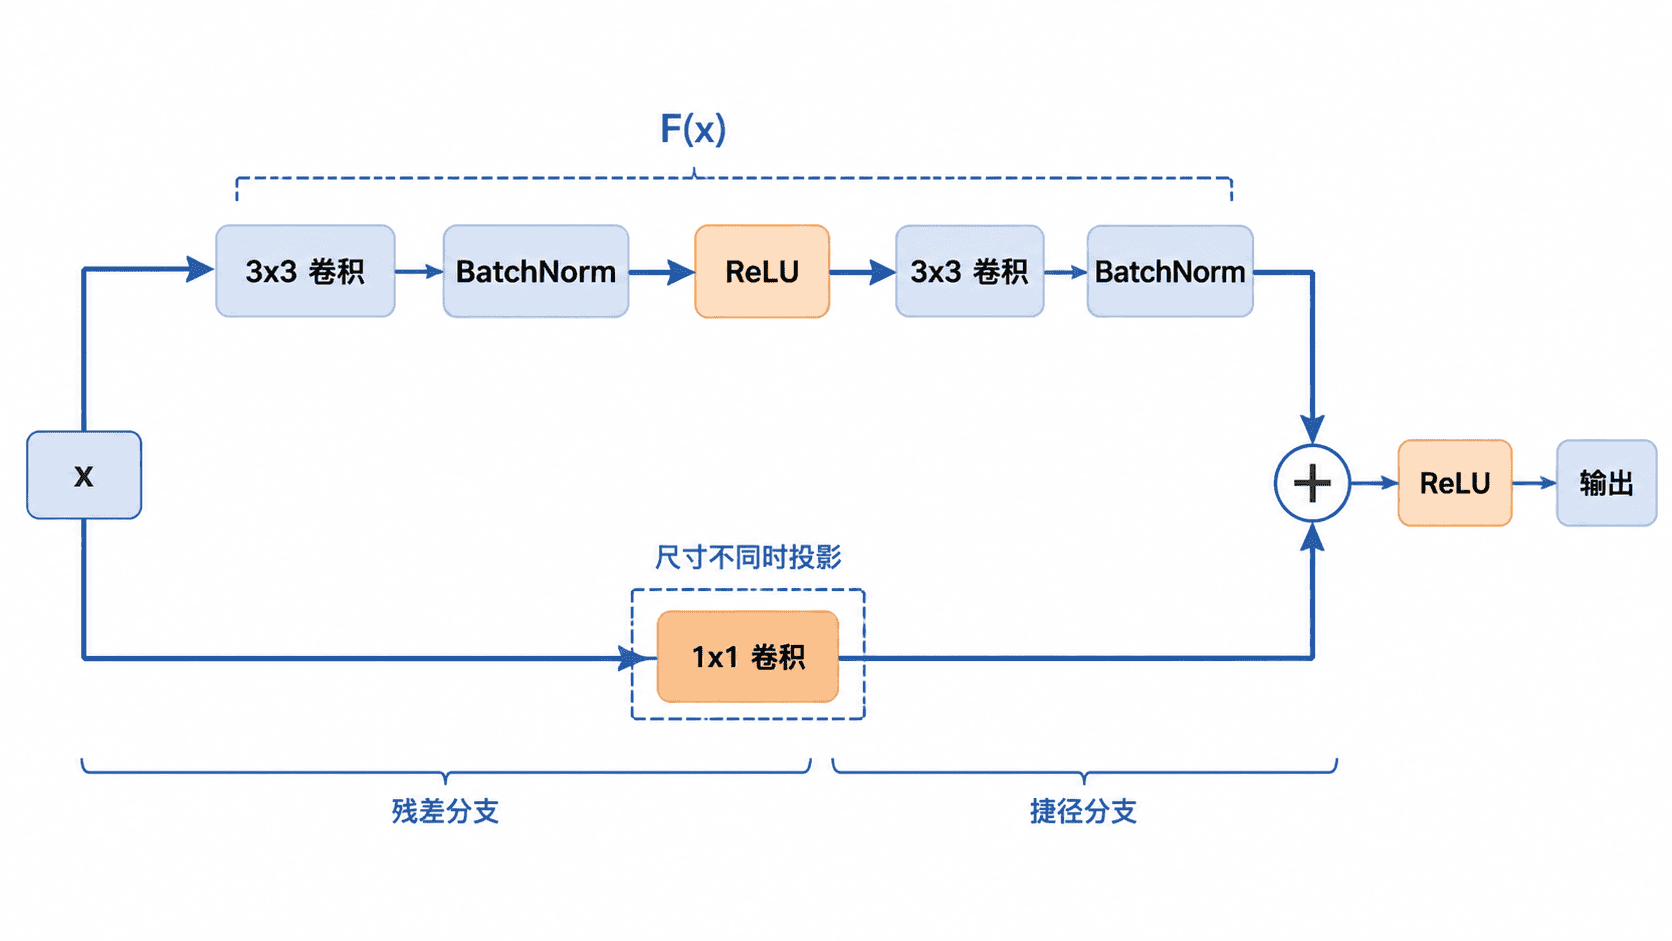
捷径为何改善训练
加法节点对输入 x 保留了一条直接路径。反向传播时,梯度既可以经过卷积分支,也可以沿捷径分支传播,因此深层网络不必完全依赖许多卷积层连续传递梯度。
残差连接并不保证梯度永远稳定,也不能替代合适的初始化、归一化和学习率设置。它提供的是更容易优化的结构,使网络加深后至少可以通过接近恒等映射避免明显退化。
实现基础残差模块
当输入与输出的通道数、空间尺寸相同时,可以直接相加;否则要用 1×1 卷积调整捷径分支。下面的模块同时覆盖这两种情况。
python
import torch
from torch import nn

class BasicResidualBlock(nn.Module):
    def __init__(self, in_channels: int, out_channels: int, stride: int = 1):
        super().__init__()

        # 残差分支负责学习输入需要修正的部分
        self.residual = nn.Sequential(
            nn.Conv2d(
                in_channels,
                out_channels,
                kernel_size=3,
                stride=stride,
                padding=1,
                bias=False,
            ),
            nn.BatchNorm2d(out_channels),
            nn.ReLU(inplace=True),
            nn.Conv2d(
                out_channels,
                out_channels,
                kernel_size=3,
                padding=1,
                bias=False,
            ),
            nn.BatchNorm2d(out_channels),
        )

        # 形状不一致时,用投影捷径完成通道和尺寸对齐
        if stride != 1 or in_channels != out_channels:
            self.shortcut = nn.Sequential(
                nn.Conv2d(
                    in_channels,
                    out_channels,
                    kernel_size=1,
                    stride=stride,
                    bias=False,
                ),
                nn.BatchNorm2d(out_channels),
            )
        else:
            self.shortcut = nn.Identity()

        self.activation = nn.ReLU(inplace=True)

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        return self.activation(self.residual(x) + self.shortcut(x))

def main() -> None:
    x = torch.randn(2, 16, 32, 32)

    same_shape_block = BasicResidualBlock(16, 16)
    downsample_block = BasicResidualBlock(16, 32, stride=2)

    print(same_shape_block(x).shape)
    print(downsample_block(x).shape)

if __name__ == "__main__":
    main()
预期输出:
text
torch.Size([2, 16, 32, 32])
torch.Size([2, 32, 16, 16])
第一组输出使用恒等捷径,输入输出形状相同。第二组输出通过步幅为 2 的投影捷径,把高宽减半并把通道数从 16 调整为 32。
相加前必须满足的条件
逐元素相加要求两条分支的张量形状完全一致。只要批次、通道、高度或宽度中有一项不同,PyTorch 就会报尺寸不匹配错误。
投影捷径的职责只是对齐形状,不应随意加入复杂变换,否则会削弱直接信息通路。实践中通常使用 1×1 卷积和与残差分支一致的步幅。
常见错误:只修改残差分支的通道数或步幅,却仍让捷径分支使用
nn.Identity()。遇到相加报错时,先打印两条分支的shape,再检查通道数和空间尺寸。
按自己的节奏,确认真正理解。