
机器学习与深度学习 / 系统课时
建立实验对比流程
建立实验对比流程
实验对比的关键不是“多跑几次”,而是让每次运行都能被识别、复现和公平比较。本课将建立一套最小实验协议,统一命名、配置、指标、模型版本与输出目录,并用脚本生成可审计的实验记录。
学习目标
- 设计稳定且可检索的实验命名规则
- 统一配置、指标和模型版本的记录方式
- 根据同一指标口径筛选最佳实验
实验为什么会失去可比性
两个实验只有在数据划分、预处理、评价指标和随机性控制方式一致时,结果才有比较价值。若只修改学习率,却同时更换数据版本或统计口径,即使准确率更高,也不能确定提升来自哪个变量。
常见问题包括目录被覆盖、文件名只写“final”、验证指标一会取最后一轮一会取最佳轮,以及代码已修改但没有记录版本。解决办法不是依赖记忆,而是让每次运行自动保存完整上下文。
统一实验协议
建议把一次实验固定为“配置输入、训练过程、模型产物、汇总结果”四部分。每个运行目录只对应一份不可变配置,训练过程中持续追加指标,检查点和最终排名都引用同一个运行标识。
| 对象 | 建议内容 | 作用 |
|---|---|---|
| 运行标识 | 项目、模型、关键参数、随机种子、配置摘要 | 防止重名并便于检索 |
| 配置文件 | 数据版本、超参数、训练轮数、代码提交号 | 复现实验条件 |
| 指标文件 | epoch、训练损失、验证指标 | 追踪过程并统一比较口径 |
| 模型文件 | 权重、配置、运行标识 | 避免权重与配置错配 |
| 环境清单 | Python 与 PyTorch 版本 | 定位环境差异 |
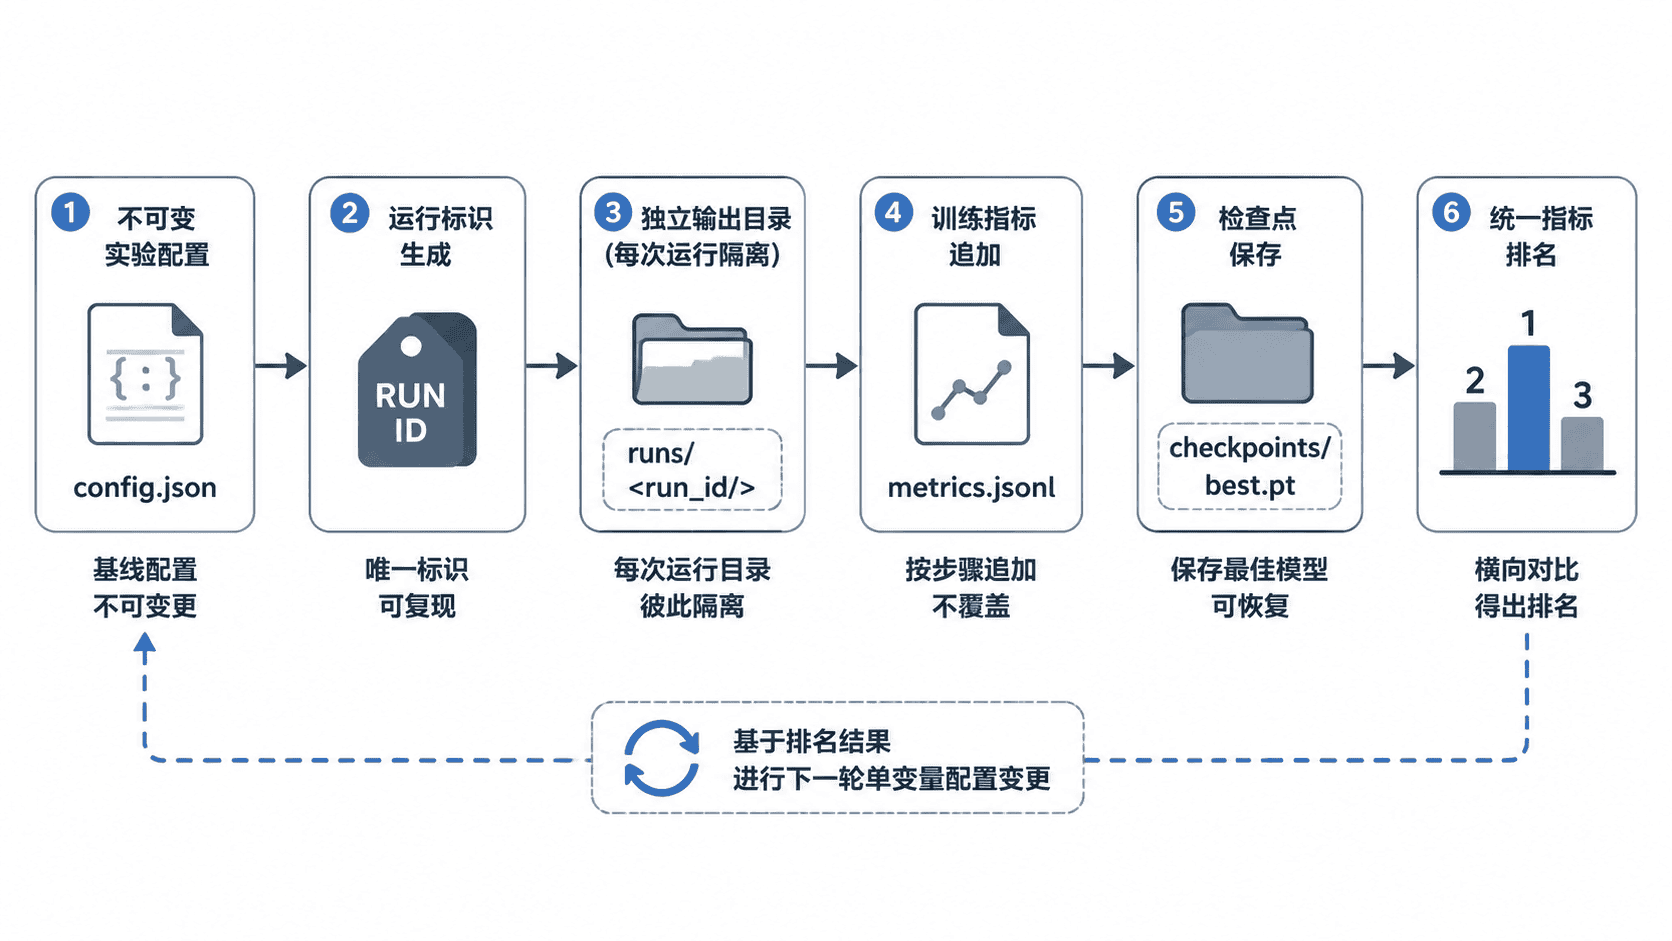
用脚本创建实验记录
下面的完整示例创建两次仅学习率不同的实验。运行标识由关键配置和哈希摘要组成,脚本会写入配置、环境清单、逐轮指标与模型检查点,最后按统一的验证准确率排序。
from dataclasses import asdict, dataclass
from pathlib import Path
import hashlib
import json
import platform

import torch
from torch import nn

@dataclass(frozen=True)
class ExperimentConfig:
    project: str
    dataset: str
    model: str
    lr: float
    batch_size: int
    epochs: int
    seed: int
    git_commit: str

def build_run_id(config: ExperimentConfig) -> str:
    payload = json.dumps(asdict(config), ensure_ascii=False, sort_keys=True)
    digest = hashlib.sha256(payload.encode("utf-8")).hexdigest()[:8]
    return (
        f"{config.project}-{config.model}-lr{config.lr:g}"
        f"-s{config.seed}-{digest}"
    )

def prepare_run(root: Path, config: ExperimentConfig) -> tuple[str, Path]:
    run_id = build_run_id(config)
    run_dir = root / run_id
    (run_dir / "checkpoints").mkdir(parents=True, exist_ok=False)

    (run_dir / "config.json").write_text(
        json.dumps(asdict(config), ensure_ascii=False, indent=2),
        encoding="utf-8",
    )
    manifest = {
        "run_id": run_id,
        "python_version": platform.python_version(),
        "torch_version": torch.__version__,
        "model_version": config.git_commit,
    }
    (run_dir / "manifest.json").write_text(
        json.dumps(manifest, ensure_ascii=False, indent=2),
        encoding="utf-8",
    )
    return run_id, run_dir

def append_metric(run_dir: Path, metric: dict) -> None:
    with (run_dir / "metrics.jsonl").open("a", encoding="utf-8") as file:
        file.write(json.dumps(metric, ensure_ascii=False) + "\n")

def save_checkpoint(
    run_dir: Path,
    run_id: str,
    config: ExperimentConfig,
) -> None:
    model = nn.Linear(4, 2)
    torch.save(
        {
            "run_id": run_id,
            "config": asdict(config),
            "model_state_dict": model.state_dict(),
        },
        run_dir / "checkpoints" / "best.pt",
    )

def main() -> None:
    root = Path("runs")
    experiments = [
        (
            ExperimentConfig(
                "mnist", "mnist-v1", "mlp", 0.001, 64, 2, 42, "abc1234"
            ),
            [
                {"epoch": 1, "train_loss": 0.31, "val_accuracy": 0.912},
                {"epoch": 2, "train_loss": 0.24, "val_accuracy": 0.924},
            ],
        ),
        (
            ExperimentConfig(
                "mnist", "mnist-v1", "mlp", 0.0005, 64, 2, 42, "abc1234"
            ),
            [
                {"epoch": 1, "train_loss": 0.29, "val_accuracy": 0.918},
                {"epoch": 2, "train_loss": 0.21, "val_accuracy": 0.931},
            ],
        ),
    ]

    ranking = []
    for config, metrics in experiments:
        torch.manual_seed(config.seed)
        run_id, run_dir = prepare_run(root, config)
        for metric in metrics:
            append_metric(run_dir, metric)
        save_checkpoint(run_dir, run_id, config)
        ranking.append((run_id, metrics[-1]["val_accuracy"]))
        print(f"created: {run_id}")

    ranking.sort(key=lambda item: item[1], reverse=True)
    print("ranking:")
    for index, (run_id, accuracy) in enumerate(ranking, start=1):
        print(f"{index}. {run_id} val_accuracy={accuracy:.4f}")

if __name__ == "__main__":
    main()
预期输出:
created: mnist-mlp-lr0.001-s42-85cbf95e
created: mnist-mlp-lr0.0005-s42-b47be2c6
ranking:
1. mnist-mlp-lr0.0005-s42-b47be2c6 val_accuracy=0.9310
2. mnist-mlp-lr0.001-s42-85cbf95e val_accuracy=0.9240
脚本使用 exist_ok=False,相同配置再次运行时会直接报目录已存在,从而避免静默覆盖。需要重复同一配置时,应额外加入明确的重复编号或时间戳,而不是删除旧目录后重跑。
规定比较口径
比较前先声明主指标、优化方向和取值规则。例如分类任务可规定“按验证集最高准确率选检查点,测试集只在最终候选上评估”。不要让某次实验使用最后一轮指标,另一次却使用最佳轮指标。
单次随机种子只能用于快速筛选。准备正式结论时,应对候选配置使用多个种子重复运行,再比较均值与波动;否则一次偶然的初始化差异可能被误判为稳定提升。
验收实验目录
一次合格运行至少应能回答四个问题:用了什么配置、基于哪个代码版本、每轮指标如何变化、最佳权重属于哪次运行。删除任意一个目录后,都不应影响其他实验的文件。
还应确认检查点中的 run_id 与目录名一致,并让评估脚本读取对应的 config.json,而不是重新手写预处理参数。这样模型、配置和评价过程才能形成闭环。