
机器学习与深度学习 / 系统课时
梯度累积与清零
梯度累积与清零
本课用连续两次反向传播展示 PyTorch 的梯度累积规则,并给出训练步骤中正确的清零顺序。完成后,你将能避免旧梯度污染当前批次,也能区分原地置零与 set_to_none=True 的行为。
学习目标
- 理解
.grad默认执行累加而不是覆盖 - 验证多次
backward()后梯度值的变化 - 在参数更新前正确使用
zero_grad()
为什么梯度会累积
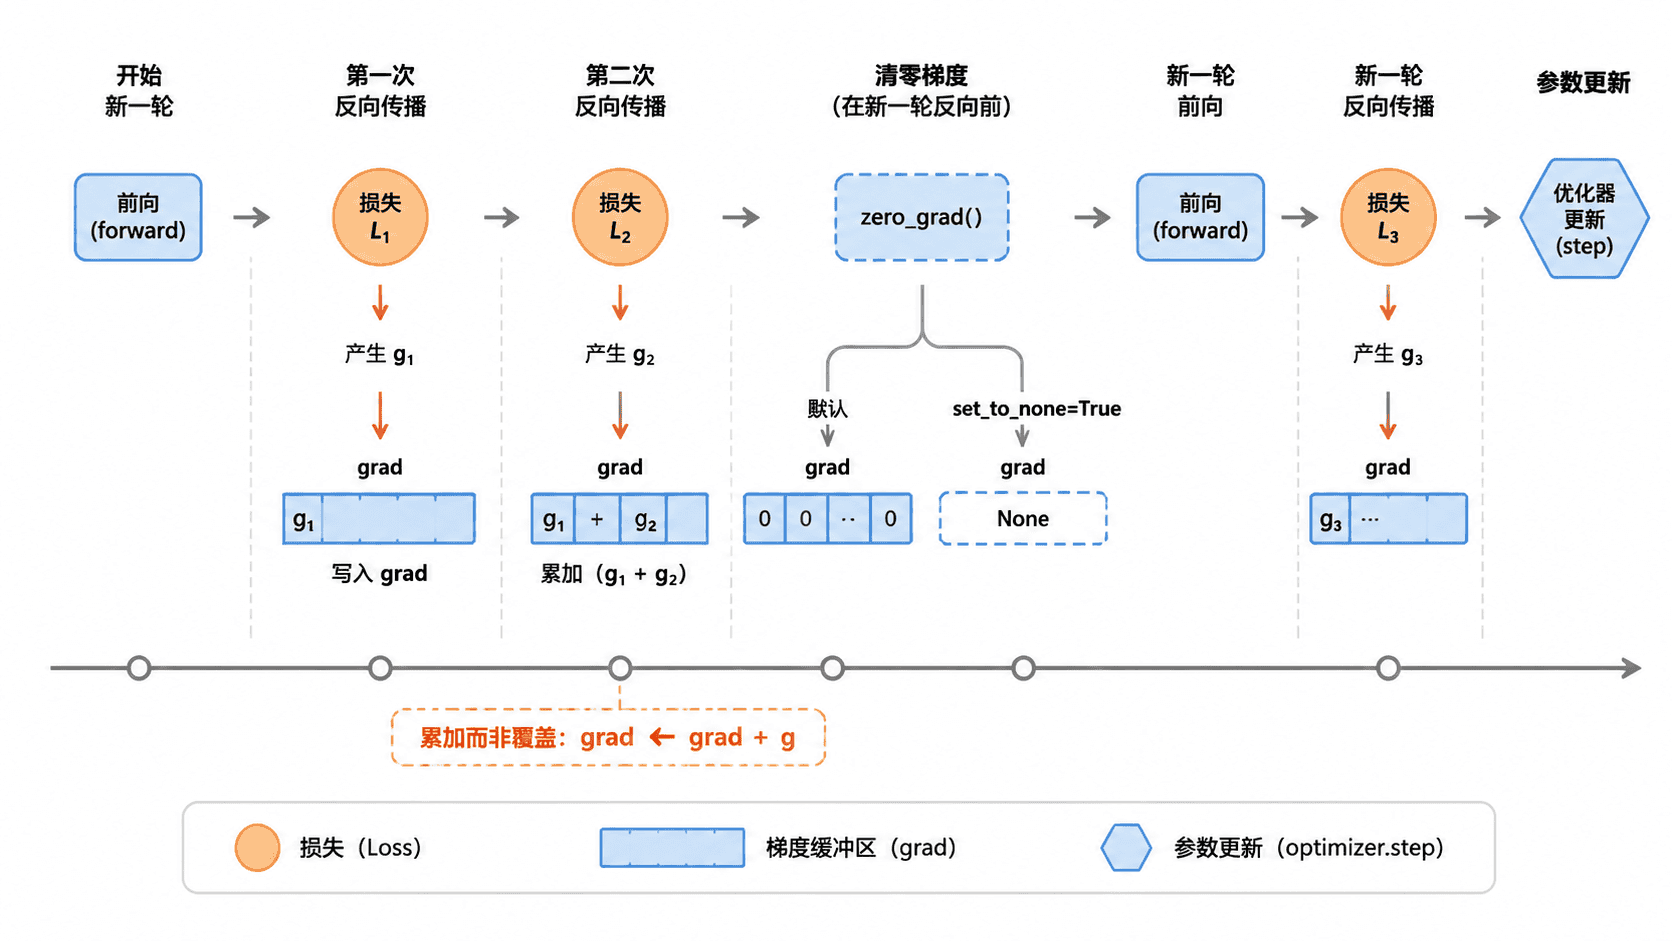
每次反向传播得到的新梯度都会加到现有 .grad 上,行为可写成 。这种设计支持梯度累积、多个损失共同反向等场景,但普通训练若忘记清零,就会把上一批数据的梯度带入下一次更新。
梯度清理必须发生在新一轮前向和反向计算之前。典型顺序是先 optimizer.zero_grad(),再计算损失、调用 loss.backward(),最后执行 optimizer.step()。
运行并观察累积
下面的程序对同一个参数执行两次独立的前向与反向计算。第一次梯度为 -6,第二次新梯度为 12,因此参数中最终保存的是二者之和 6。
python
import torch

def main() -> None:
    w = torch.tensor(2.0, requires_grad=True)

    # 第一次反向传播:新梯度为 2 * (w - 5) = -6
    loss1 = (w - 5) ** 2
    loss1.backward()
    print(f"第一次 backward 后: {w.grad.item():.1f}")

    # 第二次的新梯度为 12,但会累加到已有的 -6 上
    loss2 = (2 * w - 1) ** 2
    loss2.backward()
    print(f"第二次 backward 后: {w.grad.item():.1f}")

    w.grad.zero_()
    print(f"zero_ 清零后: {w.grad.item():.1f}")

    optimizer = torch.optim.SGD([w], lr=0.1)
    optimizer.zero_grad(set_to_none=True)
    print(f"set_to_none 后: {w.grad}")

    loss3 = (w - 1) ** 2
    loss3.backward()
    optimizer.step()
    print(f"参数更新后: {w.item():.1f}")

if __name__ == "__main__":
    main()
预期输出:
text
第一次 backward 后: -6.0
第二次 backward 后: 6.0
zero_ 清零后: 0.0
set_to_none 后: None
参数更新后: 1.8
第二次反向传播后得到 6.0,并不是第二个损失单独产生的梯度,而是 -6+12 的累积结果。optimizer.step() 会直接使用当前 .grad 更新参数,因此清理时机错误会改变训练结果。
训练循环中的清零位置
标准训练步骤应保持以下顺序:清梯度、前向计算、计算损失、反向传播、更新参数。optimizer.zero_grad(set_to_none=True) 会把梯度设为 None,通常能减少不必要的写入;下一次反向传播会重新创建梯度张量。
使用 tensor.grad.zero_() 会保留原梯度张量,只把数值置零。它适合手动管理少量张量,但模型训练更适合由优化器统一清理其管理的全部参数。
有意进行梯度累积时,不应每个小批次都清零,而应累积指定次数后再调用 optimizer.step(),随后立即清零。还应按累积次数缩放损失,避免等效梯度随批次数量成倍放大。
按自己的节奏,确认真正理解。