
机器学习与深度学习 / 系统课时
设计推理流程
设计推理流程
推理代码不能只完成一次 model(x) 调用,还要保证输入校验、预处理、设备迁移、批量执行和结果解码彼此一致。本课将封装一个可直接运行的推理器,使离线验证与线上调用共享同一条数据处理链路。
学习目标
- 划分预处理、模型调用和结果解码的职责
- 使用
eval()与torch.inference_mode()执行批量推理 - 建立线上线下一致性的验证检查项
推理链路的职责边界
稳定的推理流程通常包含输入校验、特征转换、批次组装、模型前向、概率计算和业务结果解码。每个阶段都应有明确输入输出,避免把字段顺序、归一化参数或标签映射散落在接口代码中。
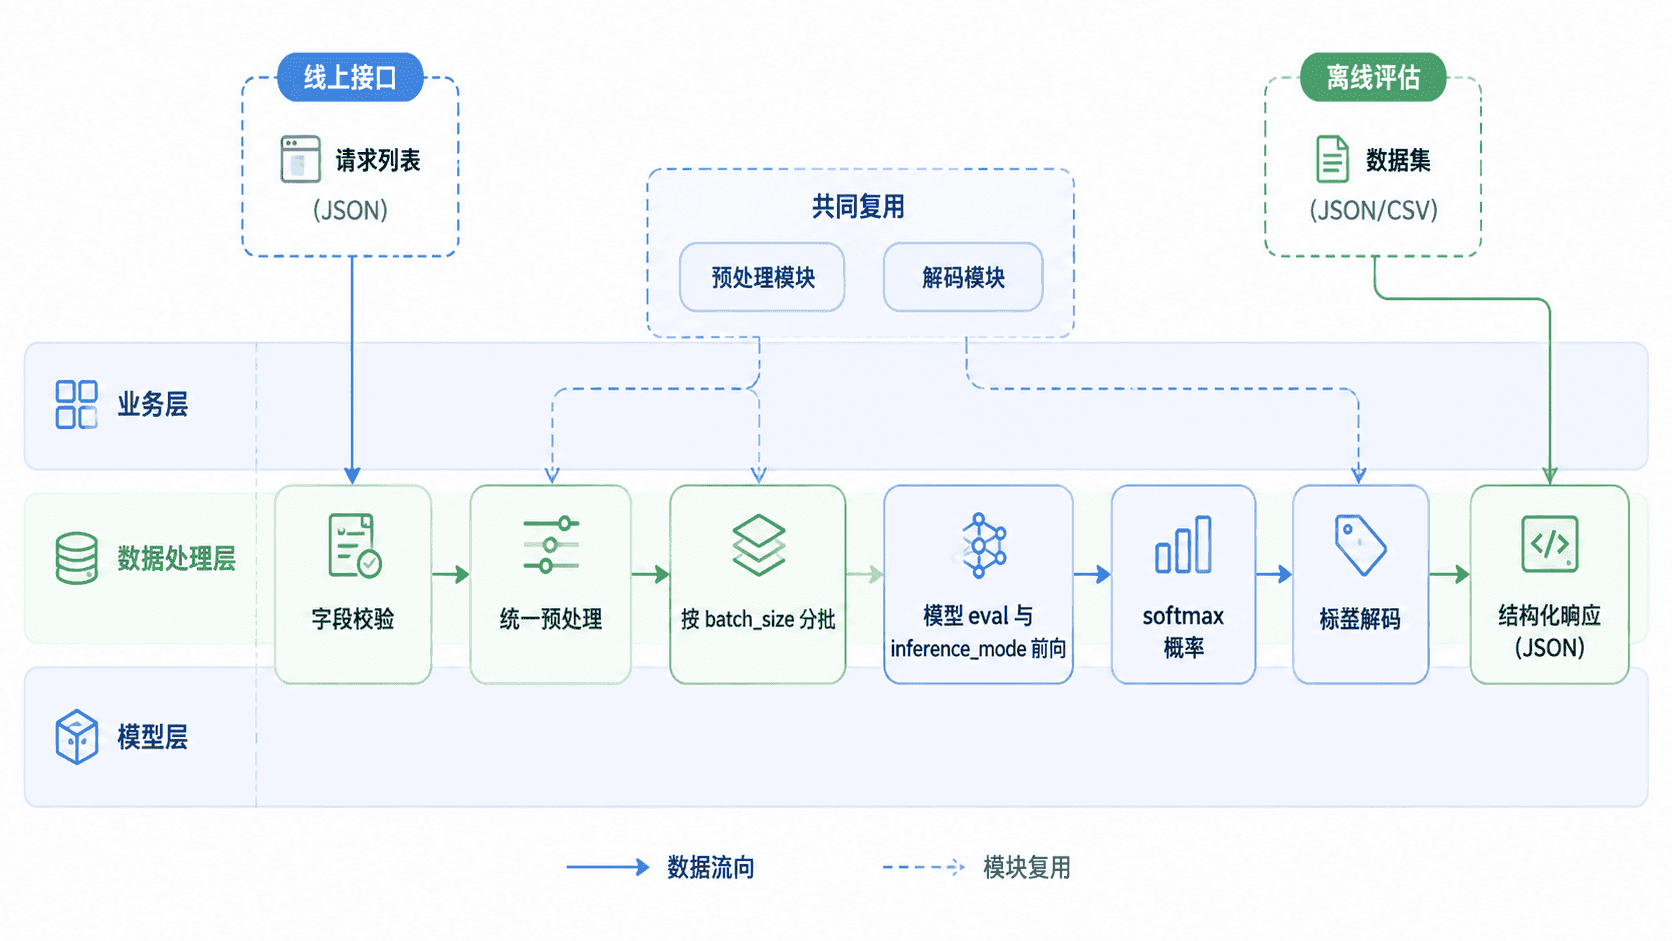
预处理负责把业务输入转换为模型训练时使用的张量格式;模型层只接收张量并返回 logits;解码层再把类别索引映射为业务标签。这样更换接口协议时无需修改模型,更换模型时也不必重写业务响应格式。
实现可复用推理器
下面的完整示例使用固定权重构造一个三分类模型。Predictor 同时处理输入校验、标准化、分批推理和结果解码,输出中保留请求 ID、标签与置信度。
from dataclasses import dataclass
import json
from typing import Sequence

import torch
from torch import nn

LABELS = ["normal", "warning", "critical"]
FEATURE_MEAN = torch.tensor([5.0, 50.0])
FEATURE_STD = torch.tensor([5.0, 10.0])

class Classifier(nn.Module):
    def __init__(self) -> None:
        super().__init__()
        self.linear = nn.Linear(2, 3)

    def forward(self, inputs: torch.Tensor) -> torch.Tensor:
        return self.linear(inputs)

def build_model() -> Classifier:
    model = Classifier()
    # 固定示例权重,使输出可复现并便于核对推理流程。
    with torch.no_grad():
        model.linear.weight.copy_(
            torch.tensor(
                [
                    [1.0, 0.0],
                    [0.0, 1.0],
                    [-0.5, -0.5],
                ]
            )
        )
        model.linear.bias.zero_()
    return model

@dataclass(frozen=True)
class RawRecord:
    request_id: str
    features: Sequence[float]

class Predictor:
    def __init__(self, model: nn.Module, device: str = "cpu") -> None:
        self.device = torch.device(device)
        self.model = model.to(self.device)
        self.model.eval()

    def preprocess(self, records: Sequence[RawRecord]) -> torch.Tensor:
        if not records:
            raise ValueError("records must not be empty")

        rows = []
        for record in records:
            if len(record.features) != 2:
                raise ValueError(
                    f"{record.request_id}: expected 2 features"
                )
            rows.append(record.features)

        tensor = torch.tensor(rows, dtype=torch.float32)
        # 归一化参数必须与训练阶段完全一致。
        return (tensor - FEATURE_MEAN) / FEATURE_STD

    def decode(
        self,
        records: Sequence[RawRecord],
        probabilities: torch.Tensor,
    ) -> list[dict]:
        confidence, class_index = probabilities.max(dim=1)
        results = []
        for record, index, score in zip(
            records,
            class_index.tolist(),
            confidence.tolist(),
        ):
            results.append(
                {
                    "request_id": record.request_id,
                    "label": LABELS[index],
                    "confidence": round(score, 4),
                }
            )
        return results

    def predict(
        self,
        records: Sequence[RawRecord],
        batch_size: int = 2,
    ) -> list[dict]:
        if batch_size <= 0:
            raise ValueError("batch_size must be positive")

        outputs = []
        # inference_mode 比 no_grad 进一步关闭推理期版本追踪。
        with torch.inference_mode():
            for start in range(0, len(records), batch_size):
                batch = records[start : start + batch_size]
                inputs = self.preprocess(batch).to(self.device)
                logits = self.model(inputs)
                probabilities = torch.softmax(logits, dim=1).cpu()
                outputs.extend(self.decode(batch, probabilities))
        return outputs

def main() -> None:
    records = [
        RawRecord("A", [10.0, 50.0]),
        RawRecord("B", [5.0, 70.0]),
        RawRecord("C", [0.0, 40.0]),
    ]
    predictor = Predictor(build_model())
    results = predictor.predict(records, batch_size=2)

    assert [item["label"] for item in results] == [
        "normal",
        "warning",
        "critical",
    ]
    print(json.dumps(results, ensure_ascii=False, indent=2))

if __name__ == "__main__":
    main()
预期输出:
[
  {
    "request_id": "A",
    "label": "normal",
    "confidence": 0.6285
  },
  {
    "request_id": "B",
    "label": "warning",
    "confidence": 0.8438
  },
  {
    "request_id": "C",
    "label": "critical",
    "confidence": 0.787
  }
]
model.eval() 会让 Dropout、BatchNorm 等层切换到推理行为,但不会关闭梯度记录;torch.inference_mode() 负责在调用期间关闭梯度及相关追踪。两者职责不同,生产推理通常需要同时使用。
保证线上线下一致
训练、验证和部署必须复用相同的特征顺序、缺失值策略、归一化参数与标签映射。最稳妥的方式是把这些内容作为模型版本的一部分保存,并让离线评估脚本与线上服务导入同一个预处理模块。
上线前应选取一组固定样本作为基准数据,同时运行离线脚本和服务接口,逐项比较标签、概率与异常响应。浮点结果可以设置合理误差范围,但类别映射和字段语义必须完全一致。
处理批量与异常边界
批量推理通过减少重复调度提高吞吐量,但批次越大,占用的显存或内存也越多。应使用真实请求分布压测,在延迟、吞吐和资源之间选择批次大小,而不是默认越大越好。
输入为空、特征数量错误、出现非数值内容或模型版本不匹配时,应在进入模型前返回明确错误。不要捕获所有异常后统一返回“推理失败”,否则线上日志无法区分数据问题、资源问题和模型问题。
验收推理流程
验收时至少检查单条与批量结果是否一致、不同批次边界是否漏数据、模型是否始终处于评估模式,以及响应顺序是否与请求顺序一致。还应使用训练期保存的真实权重替换示例权重,并验证加载失败时不会继续提供旧模型结果。
当模型运行在 GPU 上时,输入张量与模型必须位于同一设备;解码前再将概率移回 CPU。对延迟敏感的服务还应记录预处理、前向和解码各阶段耗时,以便定位瓶颈。