
机器学习与深度学习 / 系统课时
渐进式微调
渐进式微调
渐进式微调不是一次性解冻整个预训练模型,而是从输出层开始,分阶段向前解冻更深的主干模块,并为早期层设置更小学习率。这样既能适配新任务,又能降低预训练特征被快速破坏的风险。
学习目标
- 理解分阶段解冻比一次性全量微调更稳定的原因
- 使用不同参数组为各层设置差异化学习率
- 根据验证表现决定是否继续解冻或停止训练
分阶段解冻的核心策略
靠近输入端的层通常保存更通用的视觉特征,靠近输出端的层更依赖原任务。渐进式微调先训练新分类头,再解冻最后一个残差阶段,必要时继续向前解冻,同时逐步降低主干层学习率。
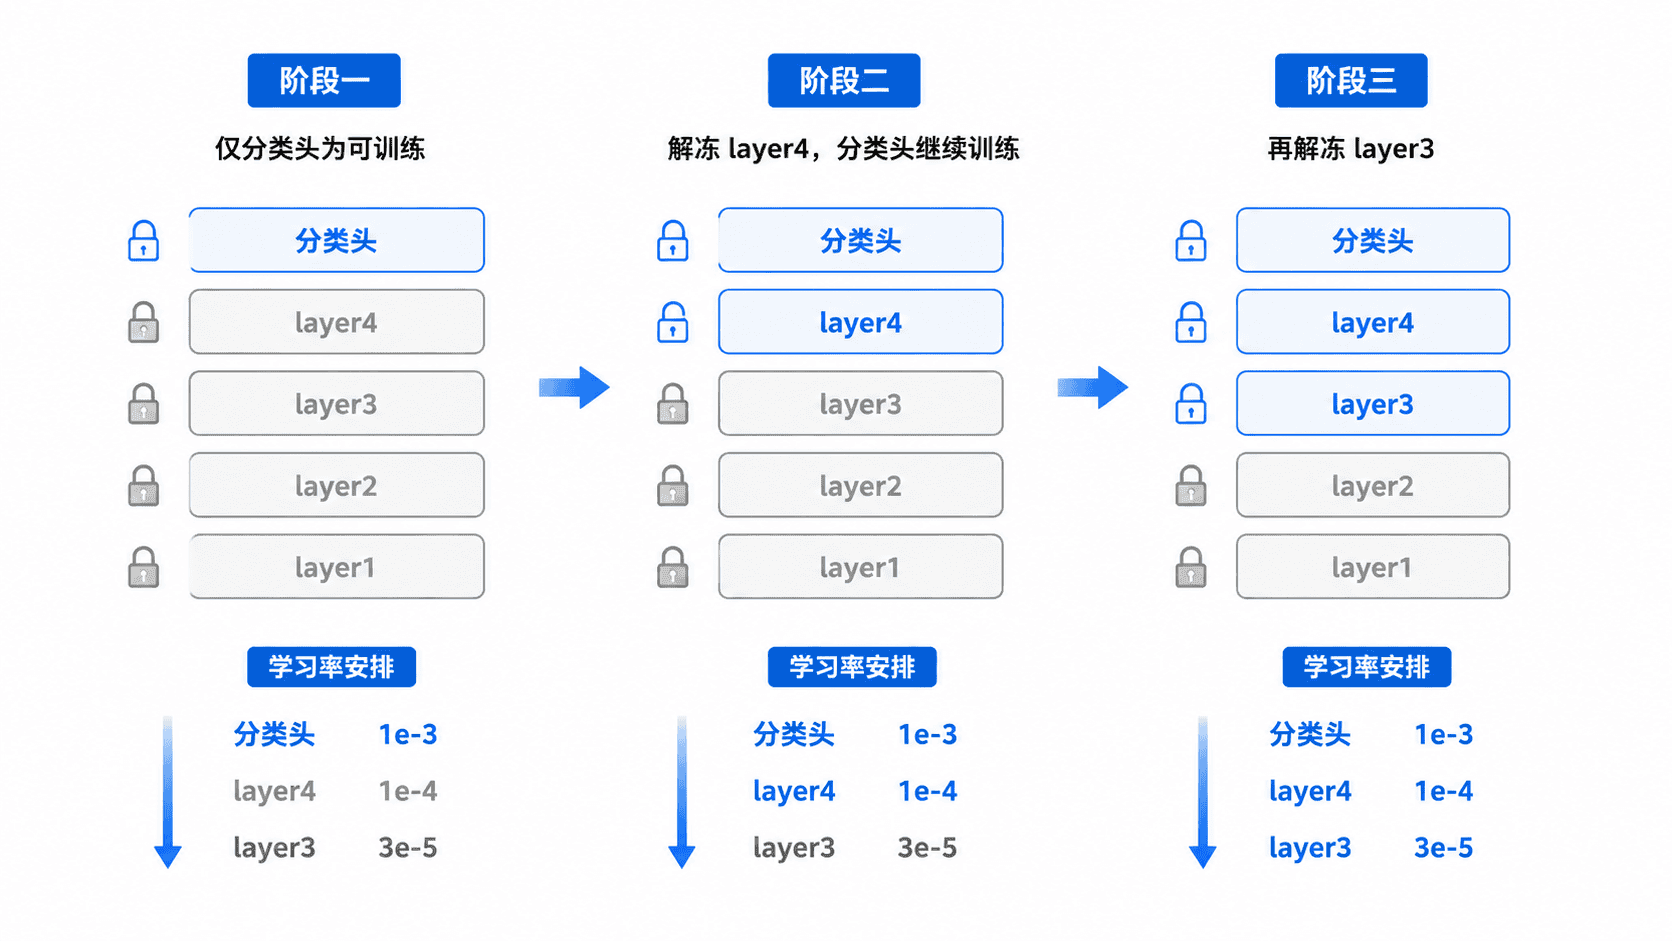
每进入一个新阶段,都应重新创建优化器,使参数组与学习率配置清晰可控。不要把已经解冻的全部参数统一设置为同一个较大学习率,否则主干特征可能在少量批次内发生剧烈漂移。
实现三阶段微调
下面的示例依次训练分类头、layer4,再加入 layer3。每个阶段开始前先冻结全部参数,然后只解冻当前参数组;模型整体保持评估模式,仅将正在训练的模块切换为训练模式,从而避免冻结区域的 BatchNorm 状态变化。
import torch
from torch import nn
from torch.utils.data import DataLoader
from torchvision.datasets import FakeData
from torchvision.models import ResNet18_Weights, resnet18

torch.manual_seed(7)

weights = ResNet18_Weights.DEFAULT
dataset = FakeData(
    size=24,
    image_size=(3, 224, 224),
    num_classes=3,
    transform=weights.transforms(),
)
loader = DataLoader(dataset, batch_size=8, shuffle=True)

model = resnet18(weights=weights)
model.fc = nn.Linear(model.fc.in_features, 3)
criterion = nn.CrossEntropyLoss()

stages = [
    ("stage1-head", [(model.fc, 1e-3)]),
    ("stage2-layer4", [(model.layer4, 1e-4), (model.fc, 5e-4)]),
    (
        "stage3-layer3-layer4",
        [(model.layer3, 3e-5), (model.layer4, 1e-4), (model.fc, 3e-4)],
    ),
]

for stage_name, module_groups in stages:
    for parameter in model.parameters():
        parameter.requires_grad = False

    optimizer_groups = []
    for module, learning_rate in module_groups:
        module.train()
        for parameter in module.parameters():
            parameter.requires_grad = True
        optimizer_groups.append(
            {"params": module.parameters(), "lr": learning_rate}
        )

    optimizer = torch.optim.AdamW(optimizer_groups, weight_decay=1e-4)

    model.eval()
    for module, _ in module_groups:
        module.train()

    running_loss = 0.0
    for images, labels in loader:
        optimizer.zero_grad()
        logits = model(images)
        loss = criterion(logits, labels)
        loss.backward()
        optimizer.step()
        running_loss += loss.item()

    trainable_count = sum(
        parameter.numel()
        for parameter in model.parameters()
        if parameter.requires_grad
    )
    print(
        f"{stage_name}: trainable={trainable_count}, "
        f"loss=<{running_loss / len(loader):.4f}>"
    )
预期输出
stage1-head: trainable=1539, loss=<LOSS_1>
stage2-layer4: trainable=8395267, loss=<LOSS_2>
stage3-layer3-layer4: trainable=10494979, loss=<LOSS_3>
损失值会因运行环境而变化;可训练参数量应随解冻阶段增加。若使用不同类别数,分类头参数量也会改变,因此实际数字应以当前模型为准。
用验证集控制解冻节奏
每个阶段都应观察验证损失和目标指标,而不是机械地解冻全部层。如果验证指标仍提升,可以进入下一阶段;如果开始下降或训练集继续变好而验证集变差,应停止解冻、降低学习率或恢复表现最佳的检查点。
新数据集较小或与预训练数据相似时,通常只解冻最后一个阶段即可。数据量更大、领域差异明显时,可以继续向前解冻,但越靠近输入端,学习率应越小,训练轮数也应更谨慎。
常见失误与修正
一次性解冻全部参数并沿用分类头学习率,容易造成灾难性遗忘。另一类问题是解冻参数后仍使用旧优化器,导致新解冻参数没有进入优化器参数组,看似训练正常,实际上权重不会更新。
分阶段时还要关注 BatchNorm。小批量数据会让运行统计量波动明显,因此冻结区域应保持评估模式;解冻区域是否更新 BatchNorm,需要结合批量大小和验证结果决定。