
机器学习与深度学习 / 系统课时
学习所需数学基础
学习所需数学基础
深度学习不要求先成为数学专家,但必须能读懂数据怎样表示、误差怎样计算,以及参数为什么能够被更新。本课集中回顾向量、矩阵、导数、梯度和概率分布,并用一个 PyTorch 示例把这些概念串成完整训练过程。
学习目标
- 理解向量和矩阵在样本、特征与模型参数中的作用
- 说明导数、梯度与梯度下降之间的关系
- 理解概率分布和损失函数为何能够衡量预测质量
向量与矩阵表示数据
标量只有一个数值,例如学习率和单个损失值。向量是一组有顺序的数,常用来表示一条样本的多个特征。若样本包含身高、体重和年龄,可以写成 。
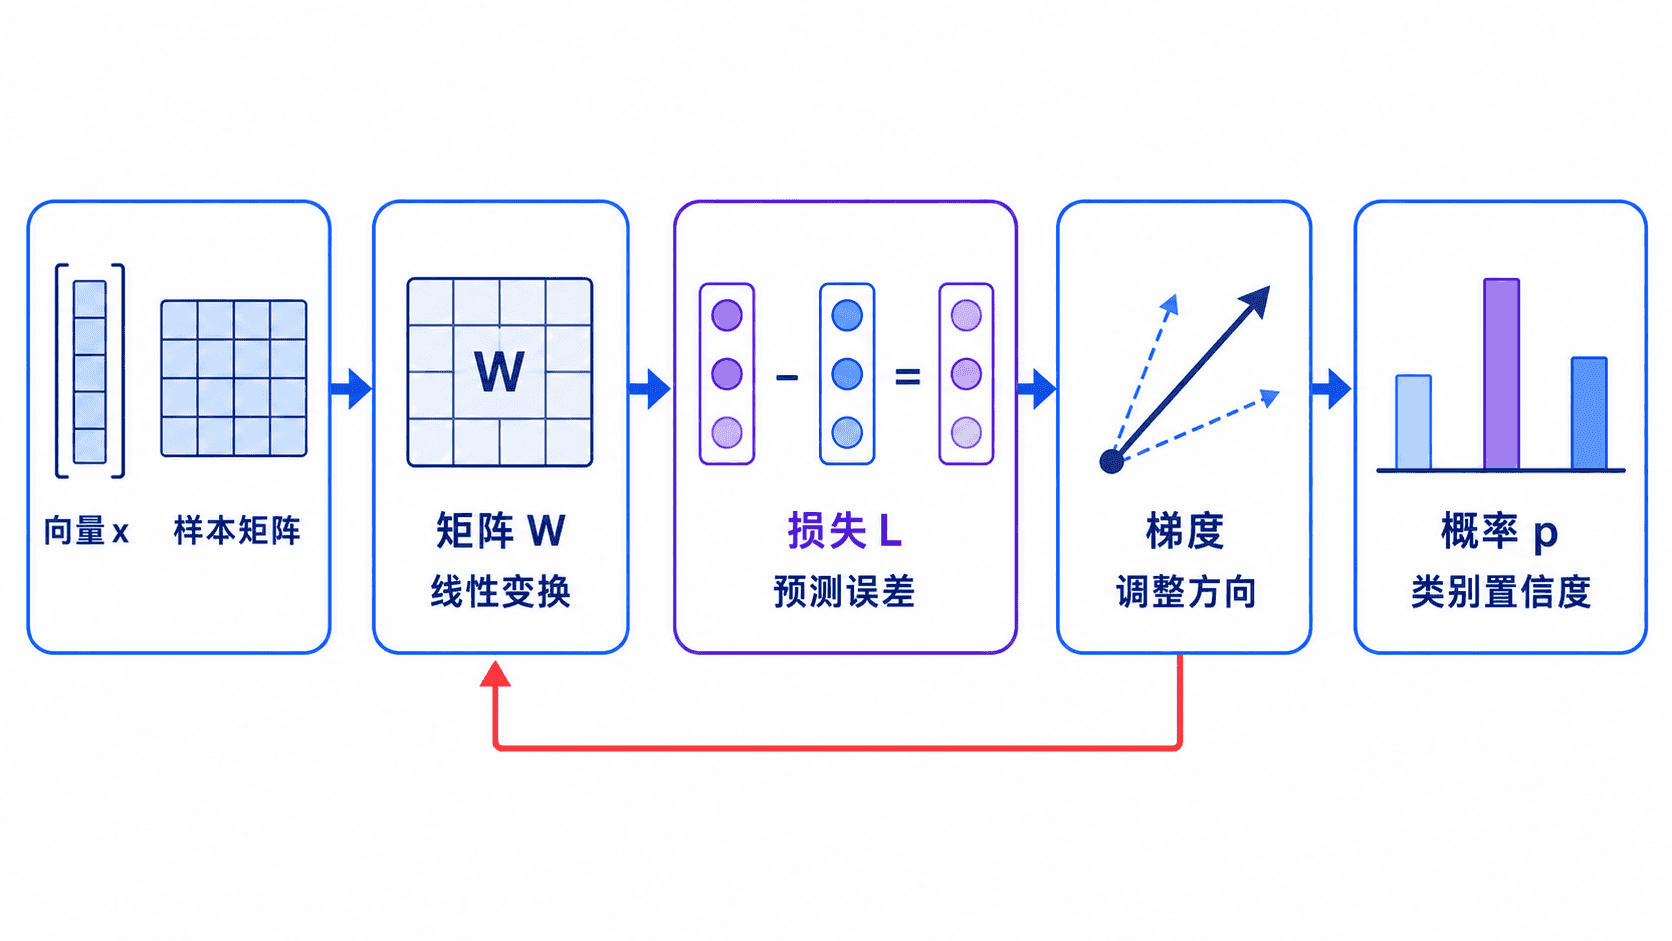
矩阵可以同时容纳多条样本或多组参数。一个包含 100 条样本、每条样本有 3 个特征的数据集,可以表示为 。神经网络中的权重也通常按矩阵保存。线性层的核心计算可以写成:
。其中, 是输入向量, 是权重矩阵, 是偏置向量, 是该层输出。矩阵维度必须匹配,否则程序无法完成乘法运算。
导数与梯度指导参数更新
导数描述一个变量发生微小变化时,函数值怎样变化。例如损失随某个权重增大而上升,则该权重对应的导数为正;若损失下降,则导数为负。
模型通常包含大量参数,因此需要同时计算损失对所有参数的偏导数。这些偏导数组成的向量称为梯度。梯度指出损失上升最快的方向,训练时沿相反方向更新参数:
其中, 表示模型参数, 表示损失, 是学习率。学习率过大会造成更新震荡,过小则会使训练速度明显变慢。
概率分布与损失函数
分类模型通常输出每个类别的概率。所有类别概率都应位于 0 到 1 之间,并且总和为 1。Softmax 可以把一组任意实数转换成概率分布:
模型输出概率后,还需要损失函数衡量预测与真实答案的差距。分类任务常使用交叉熵损失,回归任务常使用均方误差。损失值不是准确率,而是训练算法用于比较和优化的目标。
用 PyTorch 验证梯度
下面的完整示例定义一个二维输入和权重向量,通过平方误差计算损失,再调用自动求导得到梯度。
import torch

x = torch.tensor([1.0, 2.0])
w = torch.tensor([3.0, 4.0], requires_grad=True)
target = torch.tensor(10.0)

# 预测值为权重与输入的点积
prediction = torch.dot(w, x)
loss = (prediction - target) ** 2

# 反向传播会把损失对 w 的梯度写入 w.grad
loss.backward()

print(f"prediction={prediction.item():.1f}")
print(f"loss={loss.item():.1f}")
print(f"gradient={w.grad.tolist()}")
预期输出:
prediction=11.0
loss=1.0
gradient=[2.0, 4.0]
预测值比目标值大 1,平方误差为 1。梯度中的两个数分别对应两个权重,表示每个权重对当前损失的影响程度。优化器会根据这些梯度调整权重,而不需要开发者手工推导每一步计算。
易混淆点
导数针对单个变量,梯度针对一组变量;梯度给出参数调整方向,但不直接等于本次调整量,实际步长还要乘以学习率。概率表示模型对结果的相对置信程度,也不能直接视为预测必然正确的保证。