
机器学习与深度学习 / 系统课时
完成文本分类项目
完成文本分类项目
本课将完成一个最小但完整的文本分类项目:建立词表、批量填充文本、使用嵌入和 Transformer 编码器提取序列特征,再完成训练、验证与新文本推理。代码可直接运行,并保留继续替换真实数据集的接口。
学习目标
- 串联文本编码、批处理、序列建模和分类输出
- 编写训练与验证循环,并正确切换模型模式
- 使用训练后的模型预测新的文本标签
明确最小项目结构
项目把一句文本映射为正面或负面标签。为了聚焦模型流程,示例使用空格分词和内存中的小型数据集,不引入外部分词库。完整数据流依次为:文本、词元编号、批量填充、词嵌入与位置嵌入、序列编码、掩码平均池化、线性分类。
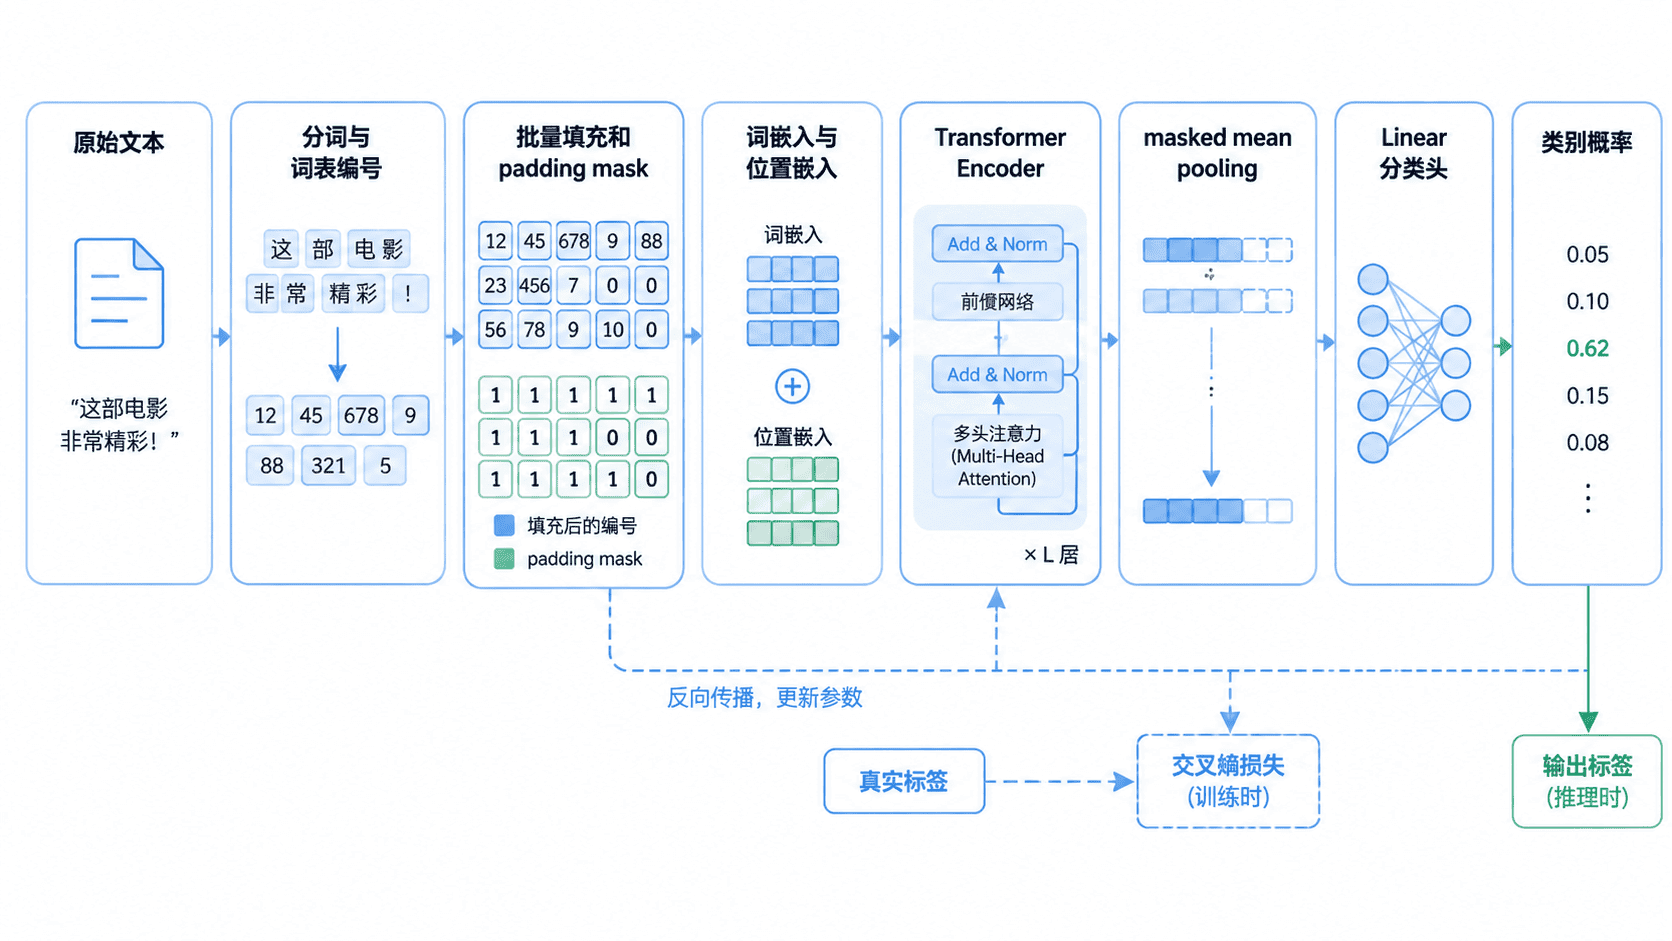
训练集负责更新参数,验证集只衡量泛化效果。推理阶段不再计算损失,也不需要梯度,因此必须使用 model.eval() 和 torch.no_grad()。
实现完整训练流程
下面代码包含数据集、动态填充、模型、训练、验证和推理。示例依赖已安装的 PyTorch,可保存为 text_classifier.py 后直接运行。
import math
from collections import Counter
from typing import Iterable

import torch
from torch import nn
from torch.nn.utils.rnn import pad_sequence
from torch.utils.data import DataLoader, Dataset

PAD_TOKEN = "<pad>"
UNK_TOKEN = "<unk>"
LABEL_NAMES = ["negative", "positive"]

TRAIN_SAMPLES = [
    ("i love this movie", 1),
    ("this film is wonderful", 1),
    ("what a great story", 1),
    ("the acting is excellent", 1),
    ("i hate this movie", 0),
    ("this film is terrible", 0),
    ("what a boring story", 0),
    ("the acting is awful", 0),
]

VALID_SAMPLES = [
    ("i love the story", 1),
    ("this movie is excellent", 1),
    ("i hate the acting", 0),
    ("this story is terrible", 0),
]

def tokenize(text: str) -> list[str]:
    return text.lower().split()

def build_vocab(samples: Iterable[tuple[str, int]]) -> dict[str, int]:
    counter = Counter()
    for text, _ in samples:
        counter.update(tokenize(text))

    # 固定保留填充和未知词编号,部署时必须复用同一份词表。
    vocab = {PAD_TOKEN: 0, UNK_TOKEN: 1}
    for token in sorted(counter):
        vocab[token] = len(vocab)
    return vocab

def encode(text: str, vocab: dict[str, int]) -> torch.Tensor:
    unk_id = vocab[UNK_TOKEN]
    token_ids = [vocab.get(token, unk_id) for token in tokenize(text)]
    # 空文本至少保留一个未知词,避免产生长度为零的序列。
    if not token_ids:
        token_ids = [unk_id]
    return torch.tensor(token_ids, dtype=torch.long)

class TextDataset(Dataset):
    def __init__(
        self,
        samples: list[tuple[str, int]],
        vocab: dict[str, int],
    ) -> None:
        self.items = [
            (encode(text, vocab), label)
            for text, label in samples
        ]

    def __len__(self) -> int:
        return len(self.items)

    def __getitem__(self, index: int) -> tuple[torch.Tensor, int]:
        return self.items[index]

def collate_batch(
    batch: list[tuple[torch.Tensor, int]],
) -> tuple[torch.Tensor, torch.Tensor]:
    sequences, labels = zip(*batch)
    # 每个批次只填充到当前最长文本,减少无效计算。
    tokens = pad_sequence(
        sequences,
        batch_first=True,
        padding_value=0,
    )
    return tokens, torch.tensor(labels, dtype=torch.long)

class TransformerClassifier(nn.Module):
    def __init__(self, vocab_size: int, pad_id: int) -> None:
        super().__init__()
        self.pad_id = pad_id
        self.d_model = 32
        self.max_length = 64
        self.embedding = nn.Embedding(
            vocab_size,
            self.d_model,
            padding_idx=pad_id,
        )
        self.position_embedding = nn.Embedding(
            self.max_length,
            self.d_model,
        )
        layer = nn.TransformerEncoderLayer(
            d_model=self.d_model,
            nhead=4,
            dim_feedforward=64,
            dropout=0.0,
            batch_first=True,
        )
        self.encoder = nn.TransformerEncoder(
            layer,
            num_layers=2,
            enable_nested_tensor=False,
        )
        self.classifier = nn.Linear(self.d_model, len(LABEL_NAMES))

    def forward(self, tokens: torch.Tensor) -> torch.Tensor:
        if tokens.size(1) > self.max_length:
            raise ValueError("sequence length exceeds max_length")

        padding_mask = tokens.eq(self.pad_id)
        positions = torch.arange(
            tokens.size(1),
            device=tokens.device,
        ).unsqueeze(0)
        # 词嵌入提供词义,位置嵌入提供词序信息。
        features = (
            self.embedding(tokens) * math.sqrt(self.d_model)
            + self.position_embedding(positions)
        )
        encoded = self.encoder(
            features,
            src_key_padding_mask=padding_mask,
        )

        # 只对真实词元求平均,避免填充位置影响句子表示。
        valid = (~padding_mask).unsqueeze(-1)
        summed = (encoded * valid).sum(dim=1)
        counts = valid.sum(dim=1).clamp(min=1)
        pooled = summed / counts
        return self.classifier(pooled)

def train_one_epoch(
    model: nn.Module,
    loader: DataLoader,
    optimizer: torch.optim.Optimizer,
    loss_fn: nn.Module,
) -> float:
    model.train()
    total_loss = 0.0

    for tokens, labels in loader:
        # 清空旧梯度后,再执行前向、反向和参数更新。
        optimizer.zero_grad()
        logits = model(tokens)
        loss = loss_fn(logits, labels)
        loss.backward()
        optimizer.step()
        total_loss += loss.item()

    return total_loss / len(loader)

def evaluate(model: nn.Module, loader: DataLoader) -> float:
    model.eval()
    correct = 0
    total = 0

    # 验证只统计预测结果,不创建反向传播所需的计算图。
    with torch.no_grad():
        for tokens, labels in loader:
            predictions = model(tokens).argmax(dim=1)
            correct += (predictions == labels).sum().item()
            total += labels.numel()

    return correct / total

def predict(
    model: nn.Module,
    texts: list[str],
    vocab: dict[str, int],
) -> list[str]:
    model.eval()
    sequences = [encode(text, vocab) for text in texts]
    tokens = pad_sequence(
        sequences,
        batch_first=True,
        padding_value=vocab[PAD_TOKEN],
    )

    with torch.no_grad():
        label_ids = model(tokens).argmax(dim=1).tolist()
    return [LABEL_NAMES[label_id] for label_id in label_ids]

def main() -> None:
    # 固定随机种子便于复现实验,真实结果仍可能因环境略有差异。
    torch.manual_seed(0)
    vocab = build_vocab(TRAIN_SAMPLES)

    train_loader = DataLoader(
        TextDataset(TRAIN_SAMPLES, vocab),
        batch_size=4,
        shuffle=True,
        collate_fn=collate_batch,
        generator=torch.Generator().manual_seed(0),
    )
    valid_loader = DataLoader(
        TextDataset(VALID_SAMPLES, vocab),
        batch_size=4,
        shuffle=False,
        collate_fn=collate_batch,
    )

    model = TransformerClassifier(
        vocab_size=len(vocab),
        pad_id=vocab[PAD_TOKEN],
    )
    optimizer = torch.optim.Adam(model.parameters(), lr=0.01)
    loss_fn = nn.CrossEntropyLoss()

    for epoch in range(1, 21):
        train_loss = train_one_epoch(
            model,
            train_loader,
            optimizer,
            loss_fn,
        )
        if epoch in {1, 10, 20}:
            accuracy = evaluate(model, valid_loader)
            print(
                f"epoch={epoch:02d} "
                f"train_loss={train_loss:.4f} "
                f"val_accuracy={accuracy:.2f}"
            )

    texts = [
        "what a great film",
        "this movie is awful",
    ]
    for text, label in zip(texts, predict(model, texts, vocab)):
        print(f"text={text!r} prediction={label}")

if __name__ == "__main__":
    main()
预期输出格式:
epoch=01 train_loss=<FLOAT> val_accuracy=<FLOAT>
epoch=10 train_loss=<FLOAT> val_accuracy=<FLOAT>
epoch=20 train_loss=<FLOAT> val_accuracy=<FLOAT>
text='what a great film' prediction=<positive|negative>
text='this movie is awful' prediction=<positive|negative>
损失、准确率和最终标签会受 PyTorch 版本及底层计算差异影响,因此用占位符表示动态值。正常情况下,训练损失应整体下降;这个微型数据集只用于验证流程,不代表真实模型效果。
验证训练与推理是否正确
运行后先检查三件事:训练损失是否总体下降、验证准确率是否在合理范围内、两条新文本是否都返回合法标签。若损失完全不变,应依次检查标签类型、优化器是否收到模型参数,以及是否遗漏 loss.backward() 或 optimizer.step()。
验证阶段必须调用 model.eval(),否则包含 Dropout 等随机层时结果会波动。推理阶段还应使用 torch.no_grad(),避免构建计算图并浪费内存。
从示例迁移到真实项目
真实项目通常需要替换三处。第一,把内存样本改成文件或数据库数据,并严格划分训练集、验证集和测试集。第二,使用适合业务语言的分词器和预训练词表。第三,保存词表、模型参数和标签映射,保证部署时的预处理规则与训练阶段完全一致。
当类别分布不均衡时,不能只看准确率,还应增加精确率、召回率和 F1。文本较长时,应设定最大长度并执行截断,否则注意力的计算量会随序列长度平方增长。