
机器学习与深度学习 / 系统课时
梯度异常排查
梯度异常排查
梯度问题通常表现为参数不更新、.grad 为 None、反向传播报错或数值突然变成 NaN/Inf。本课按“连接关系、图生命周期、张量修改、数值稳定性”的顺序定位问题,并用一个可运行脚本复现常见故障。
学习目标
- 判断梯度缺失是正常现象还是计算图断开
- 定位重复反向传播与原地修改错误
- 检查并处理 NaN、Inf 和异常梯度
先按固定顺序检查
不要一开始就修改学习率或优化器。先确认参数是否参与损失计算,再检查计算图是否被提前断开,随后排查图释放和原地修改,最后检查梯度数值。
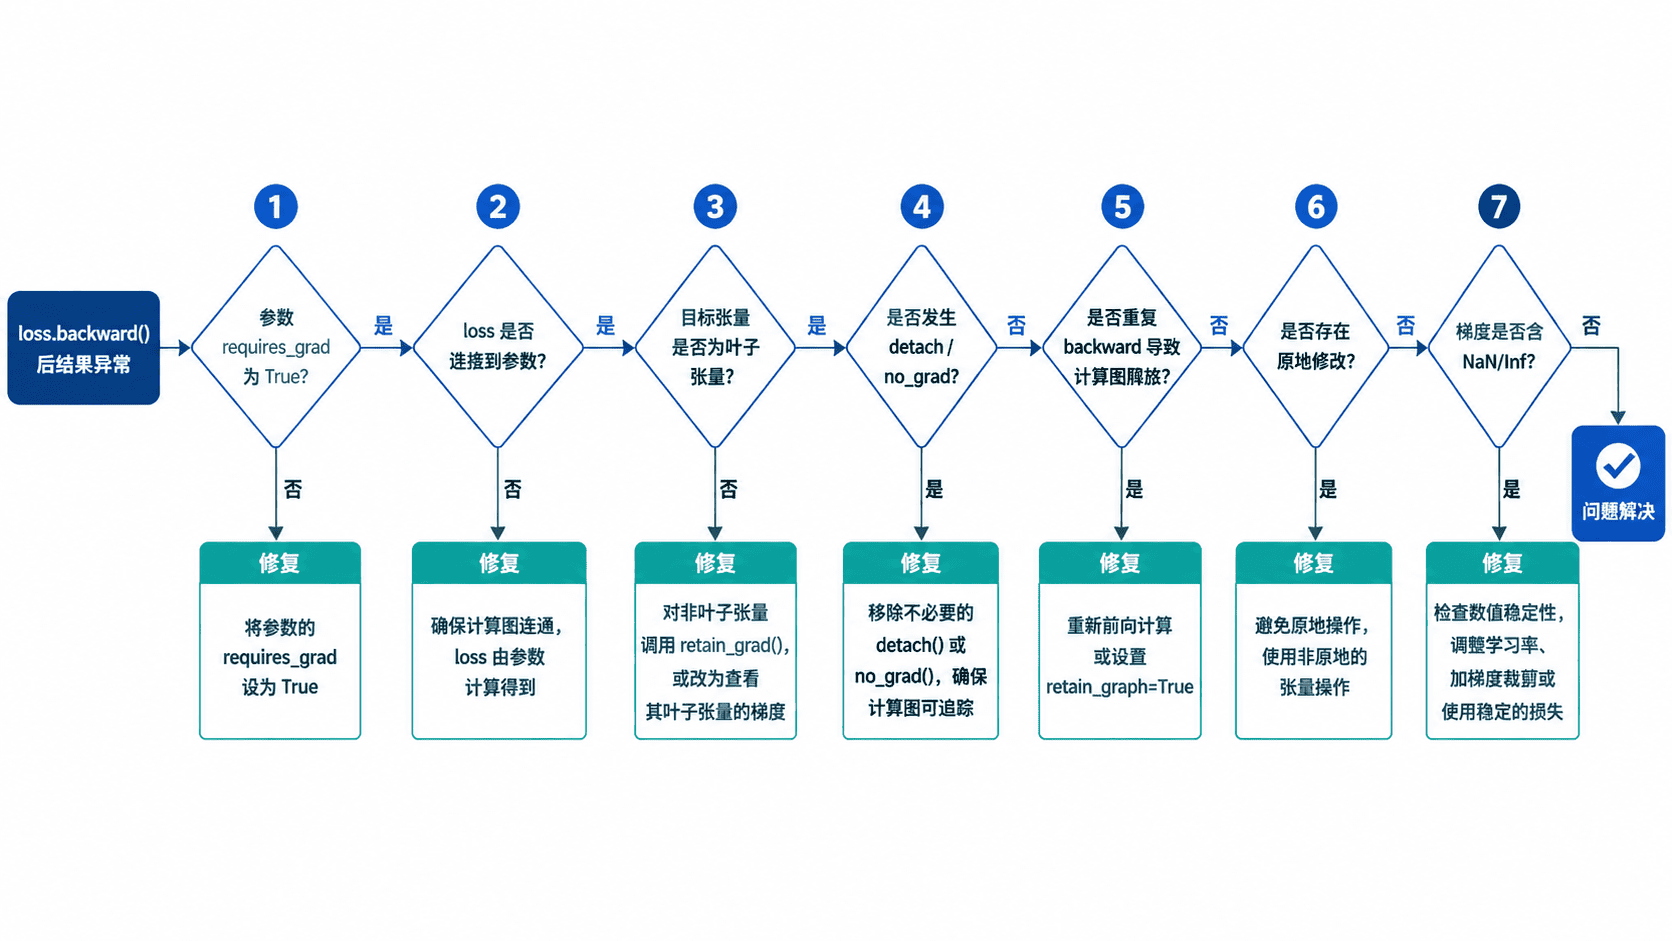
检查时优先打印 requires_grad、is_leaf、grad_fn 和参数的 .grad。叶子参数在反向传播后通常会得到梯度;中间张量默认不会保留 .grad,需要观察中间梯度时应显式调用 retain_grad()。
复现四类常见故障
下面的脚本分别复现计算图断开、重复反向传播、原地修改和非有限梯度。为避免依赖不同 PyTorch 版本的完整报错文本,示例捕获异常后只输出稳定的诊断标签。
import torch

# 1. detach 会切断参数与损失之间的计算图
weight = torch.tensor(2.0, requires_grad=True)
broken_loss = (weight.detach() * 3) ** 2

try:
    broken_loss.backward()
except RuntimeError:
    print("case1: graph-broken")
print("case1-grad:", weight.grad)

fixed_weight = torch.tensor(2.0, requires_grad=True)
fixed_loss = (fixed_weight * 3) ** 2
fixed_loss.backward()
print("case1-fixed-grad:", fixed_weight.grad.item())

# 2. 默认计算图在第一次 backward 后释放
value = torch.tensor(2.0, requires_grad=True)
result = value ** 3
result.backward()

try:
    result.backward()
except RuntimeError:
    print("case2: graph-freed")

# 3. 反向传播依赖的张量被原地修改
source = torch.ones(3, requires_grad=True)
saved_result = source * source

with torch.no_grad():
    source.add_(1)

try:
    saved_result.sum().backward()
except RuntimeError:
    print("case3: inplace-modified")

# 4. 梯度存在,但数值不是有限值
zero = torch.tensor(0.0, requires_grad=True)
torch.sqrt(zero).backward()
print("case4-finite:", torch.isfinite(zero.grad).item())

stable_zero = torch.tensor(0.0, requires_grad=True)
torch.sqrt(stable_zero + 1e-6).backward()
print("case4-fixed:", torch.isfinite(stable_zero.grad).item())
预期输出
case1: graph-broken
case1-grad: None
case1-fixed-grad: 36.0
case2: graph-freed
case3: inplace-modified
case4-finite: False
case4-fixed: True
第一类问题通常来自 detach()、item()、在 no_grad() 中执行关键计算,或把张量转换成 NumPy 后重新创建。修复原则是让损失从模型输出直接计算,避免在反向路径中产生不可微分的副本。
计算图释放与原地修改
同一张计算图默认只能反向传播一次。确实需要对同一前向结果多次求梯度时,可以在第一次调用中设置 retain_graph=True,但训练循环更常见的正确做法是重新执行前向传播,避免长期保留图导致内存增长。
名称以 _ 结尾的方法通常是原地操作,例如 add_()、relu_()。当反向传播需要旧值时,原地修改会破坏版本检查。优先改用非原地表达式,例如 x = x + 1;若必须原地更新参数,应在优化器或 torch.no_grad() 的受控范围内完成,并确保没有破坏当前计算图。
检查异常数值
梯度不是 None 仍可能无法训练。每次 backward() 后,可以抽查参数梯度是否有限,并记录梯度范数。出现 NaN/Inf 时,先检查损失输入范围、除零、对负数开方、对非正数取对数和指数溢出,再考虑降低学习率或裁剪梯度。
调试复杂模型时,可临时启用 torch.autograd.set_detect_anomaly(True)。它会记录前向调用位置,并在反向传播产生异常时提供更具体的算子线索,但运行开销较大,不应长期用于正式训练。
参数不更新时再检查优化器
参数有梯度但数值不变时,检查该参数是否真的传给优化器、是否在 step() 前误调用了 zero_grad()、学习率是否为零,以及参数是否被意外冻结。推荐的基本顺序是:清空梯度、前向计算、计算损失、反向传播、优化器更新。
使用 optimizer.zero_grad(set_to_none=True) 后,尚未参与本轮计算的参数梯度会保持 None,这是正常现象。不要把“梯度为 None”一律判断为错误,应结合参数是否参与当前损失分支来分析。