
机器学习与深度学习 / 系统课时
LSTM 与 GRU
LSTM 与 GRU
基础 RNN 在长序列中很难稳定保留早期信息。LSTM 和 GRU 通过门控机制控制信息的写入、保留与删除,从而改善长期依赖学习,并成为序列建模中更常用的循环层。
学习目标
- 理解门控结构缓解长期依赖问题的原因
- 区分 LSTM 与 GRU 的状态、门和输出形式
- 能在 PyTorch 中选择并调用对应循环层
为什么需要门控结构
基础 RNN 每个时间步都会整体重写隐藏状态。反向传播跨越很多时间步后,梯度可能连续缩小或放大,使较早输入难以影响最终结果。
门控网络使用取值在 0 到 1 之间的门控制信息比例。接近 0 表示阻断,接近 1 表示保留。模型因此不必在每一步彻底覆盖状态,而能学习“哪些信息继续传递,哪些信息立即遗忘”。
LSTM 与 GRU 的内部差异
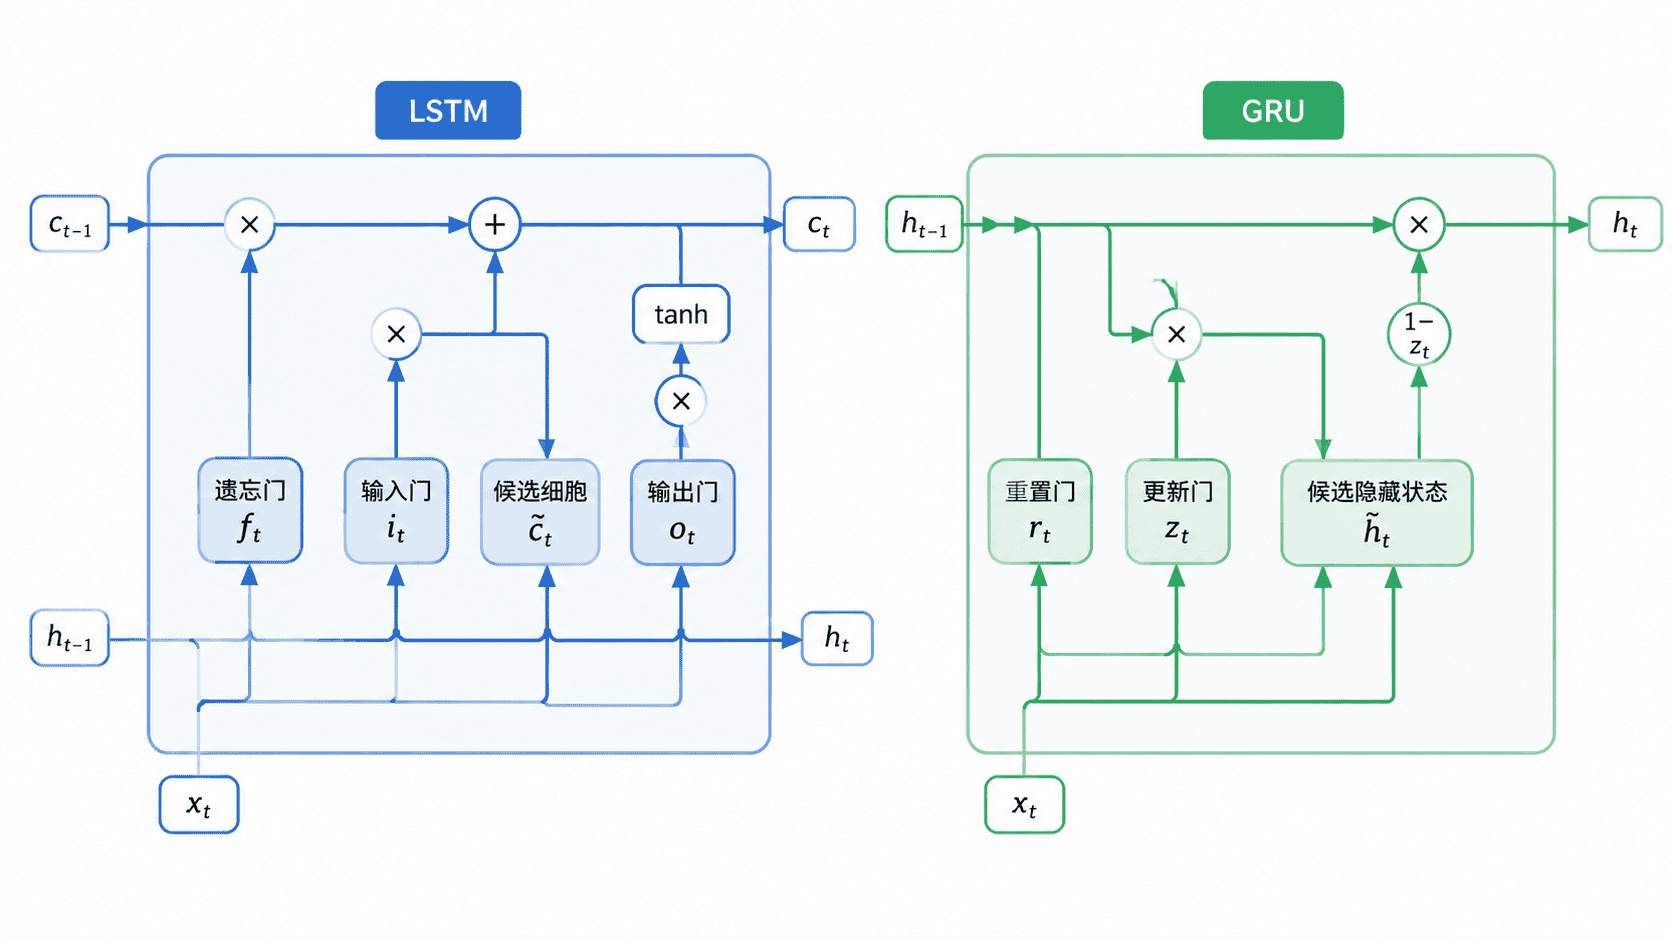
LSTM 维护隐藏状态 和细胞状态 。遗忘门决定旧细胞状态保留多少,输入门决定写入多少候选信息,输出门决定当前暴露多少状态。细胞状态提供了一条相对直接的信息通道。
GRU 把长期状态与隐藏状态合并,只维护 。更新门控制旧状态与新候选状态的混合比例,重置门控制计算候选状态时参考多少历史信息,因此结构更紧凑。
| 对比项 | LSTM | GRU |
|---|---|---|
| 状态 | 隐藏状态与细胞状态 | 仅隐藏状态 |
| 门数量 | 遗忘门、输入门、输出门 | 更新门、重置门 |
| 参数量 | 通常更多 | 通常更少 |
| 常见取舍 | 表达能力强,适合复杂长期依赖 | 训练和推理更轻量 |
两者没有绝对优劣。数据量、序列长度、延迟要求和验证集表现,通常比理论上的结构差异更能决定最终选择。
在 PyTorch 中比较两种循环层
下面使用相同输入维度和隐藏维度分别创建 LSTM 与 GRU,并检查输出形状和参数量。
import torch
from torch import nn

torch.manual_seed(7)

batch_size = 4
sequence_length = 6
input_size = 8
hidden_size = 16

x = torch.randn(batch_size, sequence_length, input_size)

# 使用相同输入与隐藏维度,确保参数量比较公平
lstm = nn.LSTM(input_size, hidden_size, batch_first=True)
gru = nn.GRU(input_size, hidden_size, batch_first=True)

# LSTM 返回隐藏状态和细胞状态,GRU 只返回隐藏状态
lstm_output, (lstm_h, lstm_c) = lstm(x)
gru_output, gru_h = gru(x)

count_parameters = lambda model: sum(
    parameter.numel() for parameter in model.parameters()
)

print("LSTM output:", lstm_output.shape)
print("LSTM h:", lstm_h.shape)
print("LSTM c:", lstm_c.shape)
print("GRU output:", gru_output.shape)
print("GRU h:", gru_h.shape)
print("LSTM params:", count_parameters(lstm))
print("GRU params:", count_parameters(gru))
预期输出:
LSTM output: torch.Size([4, 6, 16])
LSTM h: torch.Size([1, 4, 16])
LSTM c: torch.Size([1, 4, 16])
GRU output: torch.Size([4, 6, 16])
GRU h: torch.Size([1, 4, 16])
LSTM params: 1664
GRU params: 1248
两种网络的逐时间步输出形状相同。区别在于 LSTM 返回 (h, c) 两个最终状态,GRU 只返回 h。在相同维度下,GRU 的门更少,因此本例参数量也更少。
如何做实际选择
优先从 GRU 开始,适合快速建立基线、数据量有限或对延迟较敏感的任务。若验证结果显示模型难以捕获较长依赖,再尝试 LSTM,并保持数据划分、隐藏维度和训练设置一致,避免不公平比较。
选择双向结构时,模型会同时读取正序和逆序信息,适合整段序列已完整可见的分类与标注任务。流式预测、在线生成等场景不能使用未来信息,应采用单向网络。
无论使用哪种结构,都要正确处理填充长度、隐藏状态边界和梯度裁剪。门控结构能缓解长期依赖问题,但不能自动修复错误的数据组织或训练流程。