
机器学习与深度学习 / 系统课时
深度学习解决什么问题
深度学习解决什么问题
当规则难以穷举、特征难以手工设计时,深度学习可以直接从大量样本中学习多层表示,用于识别、预测和生成。本课将建立适用边界,帮助你判断一个问题是否值得使用深度学习。
学习目标
- 说出深度学习常见的任务类型与输出形式
- 理解深度学习和传统机器学习在特征处理上的主要区别
- 根据数据、成本和业务要求判断是否适合采用深度学习
深度学习擅长的问题
深度学习特别适合输入结构复杂、有效特征难以人工描述的问题。图像中的边缘与物体、语音中的音素与语义、文本中的上下文关系,都可以通过多层网络逐级提取。
常见任务可归纳为三类:分类任务输出类别,例如判断图片中的动物;回归任务输出连续数值,例如预测设备剩余寿命;生成任务产生新内容,例如生成文本、图像或语音。
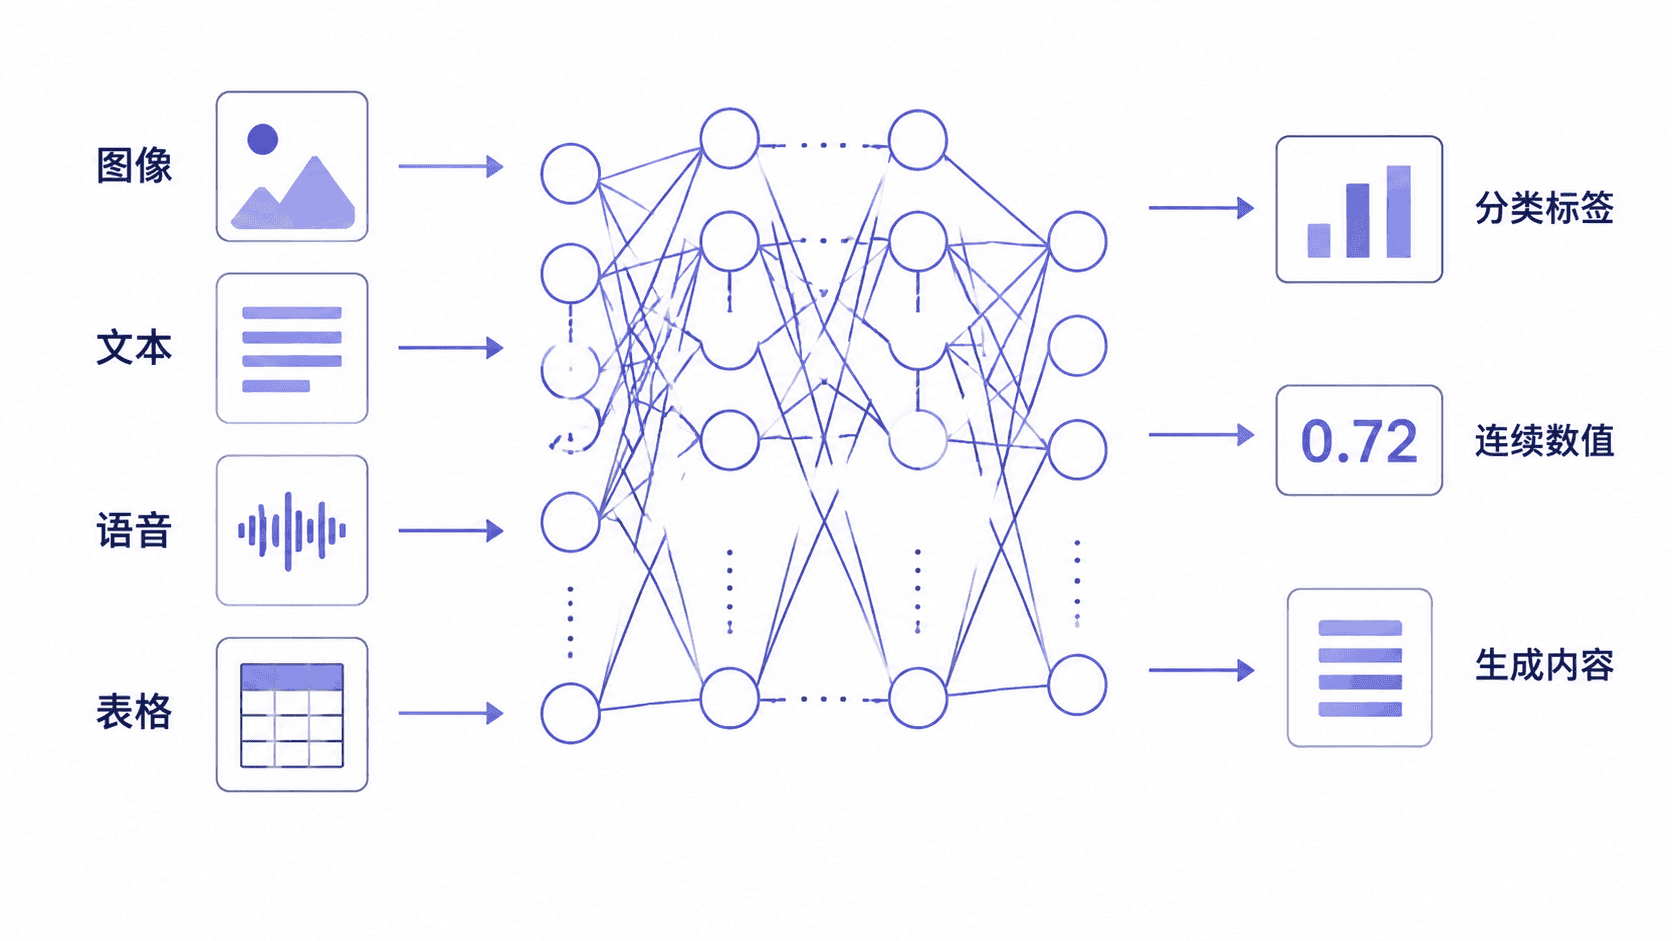
与传统机器学习的主要区别
两者都通过数据寻找输入和输出之间的规律,关键差异在于特征由谁构造。传统机器学习通常先由人提取特征,再交给模型学习;深度学习把特征提取和任务预测放进同一个网络中联合训练。
| 对比项 | 传统机器学习 | 深度学习 |
|---|---|---|
| 特征来源 | 以人工设计为主 | 从数据中自动学习 |
| 适合数据 | 中小规模、结构化数据 | 大规模、图像文本等复杂数据 |
| 计算成本 | 通常较低 | 训练成本通常较高 |
| 可解释性 | 往往更容易分析 | 内部表示通常更难解释 |
自动学习特征并不表示完全不需要人工工作。数据采集、标签质量、网络结构、损失函数和评估指标仍然需要结合业务目标设计。
典型应用场景
视觉任务包括图片分类、目标检测和缺陷识别;自然语言任务包括情感分析、机器翻译和问答;语音任务包括语音识别与声音分类;推荐和风控系统也可以利用深度网络学习用户、商品和行为之间的复杂关系。
判断场景时应先明确输入、目标输出和评价标准。例如“识别发票字段”比“让系统看懂发票”更可执行,因为前者能够定义字段标签、训练样本和准确率。
哪些情况不应优先使用
数据量很小、业务规则稳定、结果必须高度可解释,或者简单模型已经达到要求时,不应仅因为“先进”而选择深度学习。对于结构化表格数据,树模型或线性模型常常更便宜,也更容易部署和解释。
一个实用判断顺序是:先用规则或简单模型建立基线,再确认误差是否来自特征表达能力不足;只有复杂模式确实无法被简单方法捕获时,再投入深度学习训练与部署成本。
Tips:模型越复杂并不代表业务效果一定越好。应同时比较准确率、推理延迟、算力成本、维护难度和错误风险。