
机器学习与深度学习 / 系统课时
迁移学习的适用场景
迁移学习的适用场景
迁移学习解决的是“目标数据不够多,却希望快速得到可靠模型”的问题。本课将帮助你判断源任务知识能否复用,并在固定特征提取、微调和从零训练之间做出合理选择。
学习目标
- 理解预训练模型能够迁移的知识是什么
- 判断数据规模、任务相似度和模型结构是否适合迁移
- 区分固定特征提取、微调与从零训练的使用边界
迁移的不是答案,而是参数起点
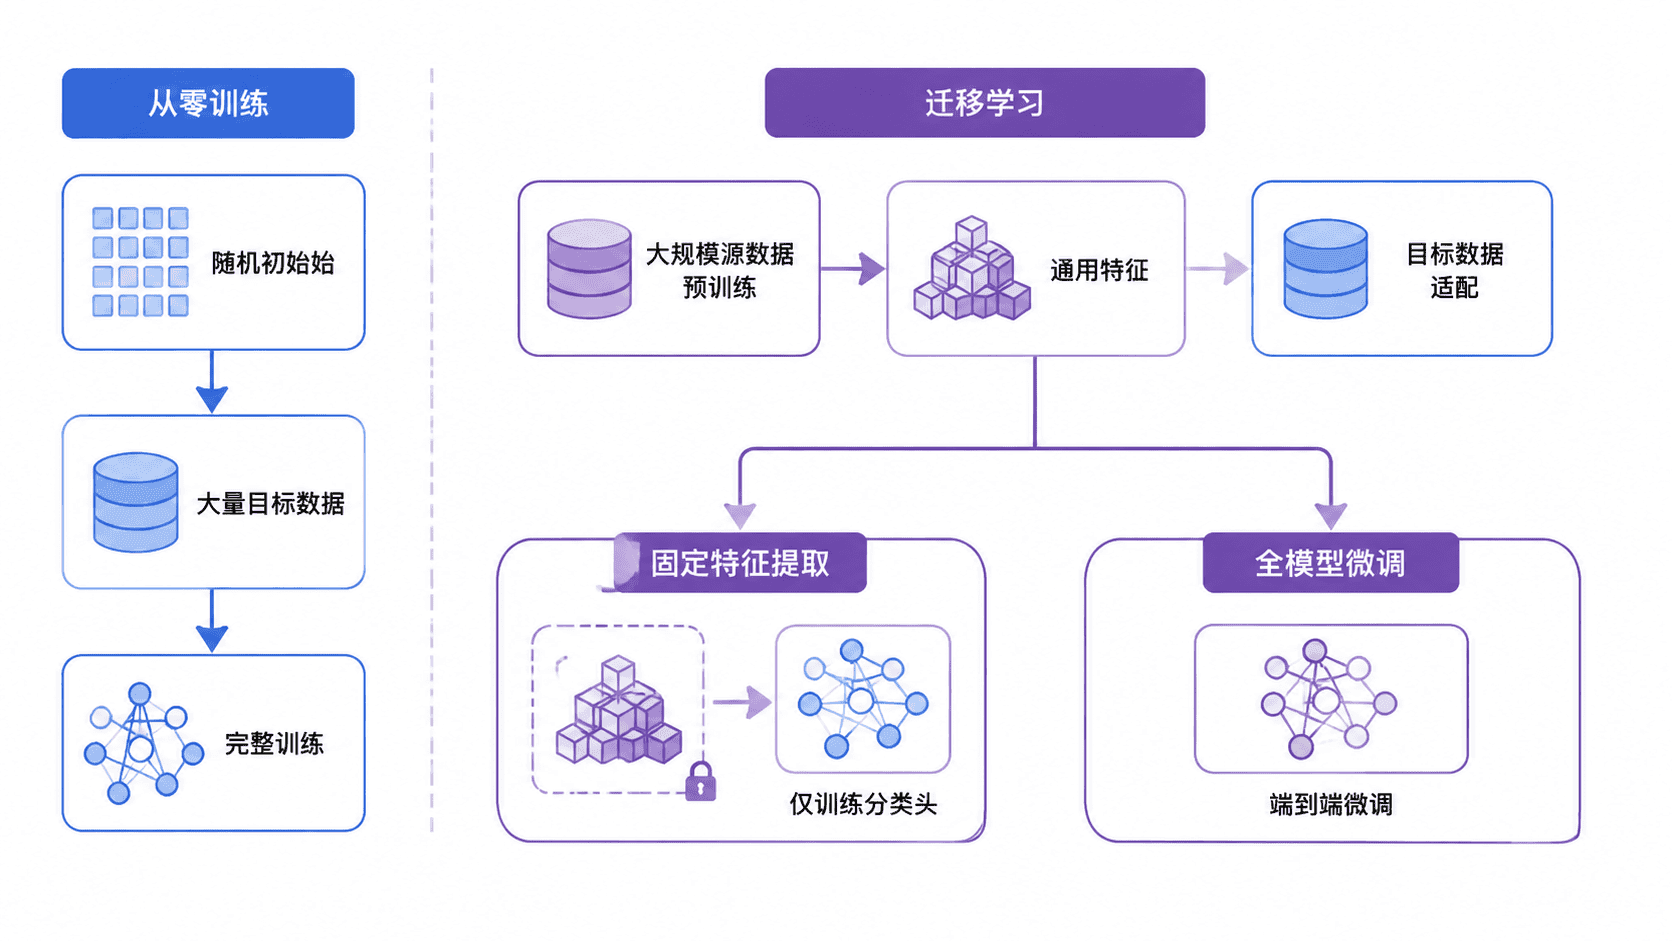
预训练模型已经在大规模源数据上学习过边缘、纹理、形状和高层语义等可复用模式。迁移学习不是直接复制源任务的分类结果,而是把这些参数作为目标任务的起点,再用目标数据完成适配。
在图像分类中,浅层通常更偏向通用视觉特征,靠近输出端的层更依赖具体类别。因此,目标任务与源任务越相近,可直接复用的层通常越多。实践中常见的迁移方式是全模型微调,或固定主干作为特征提取器。
先检查三个适用条件
- 任务相关性:源数据与目标数据是否共享相似的输入模式。例如,自然图像预训练模型通常适合商品、动物或场景图片,但未必适合医学体数据或雷达信号。
- 目标数据规模:样本越少,预训练参数带来的先验价值越大;样本较多时,可以解冻更多层,让模型充分适应目标分布。
- 输入与结构兼容性:通道数、输入维度和网络类型必须能够衔接。二维图像模型不能在不改造结构的情况下直接处理文本或三维点云。
标签质量也很关键。迁移学习可以减少对数据量的要求,却不能修复错误标签、严重类别偏斜或训练集与实际场景不一致的问题。
选择固定特征提取还是微调
| 情况 | 推荐方式 | 原因 |
|---|---|---|
| 数据很少,任务与源任务相近 | 冻结主干,只训练新分类头 | 参数少,过拟合风险较低 |
| 数据中等,任务较相近 | 先训练分类头,再逐步解冻高层 | 兼顾稳定性与适应能力 |
| 数据较多,任务存在明显差异 | 使用较小学习率微调整个模型 | 让更多层适应目标分布 |
| 数据充足且任务差异极大 | 评估从零训练 | 预训练先验可能限制模型 |
实际项目中,最稳妥的基线通常是先冻结主干训练输出层,再解冻后部网络进行小学习率微调。这样既能快速验证数据管道,也能观察继续训练是否真正带来收益。
不适合迁移学习的情况
当输入模态、特征规律或目标定义与源任务差异过大时,预训练参数可能导致负迁移,表现为收敛变慢或最终精度下降。此时应比较“预训练初始化”和“随机初始化”两个基线,而不是默认迁移一定更好。
如果目标数据已经非常充足,且模型结构需要针对业务重新设计,从零训练也可能更合适。涉及许可证、权重来源或可追溯性要求时,还应先确认预训练权重是否允许用于当前产品。
按自己的节奏,确认真正理解。