
机器学习与深度学习 / 系统课时
自动混合精度
自动混合精度
自动混合精度会在一次训练步骤中自动选择适合的数值精度,让部分算子使用低精度计算,同时保留需要稳定性的高精度路径。本课将完成一段可运行的 CUDA AMP 训练代码,并说明缩放梯度、更新参数和验证收益时的关键边界。
学习目标
- 理解
autocast与GradScaler的分工 - 将普通 GPU 训练循环改造成自动混合精度训练
- 正确处理反向传播、梯度裁剪与效果验证
AMP 的核心机制
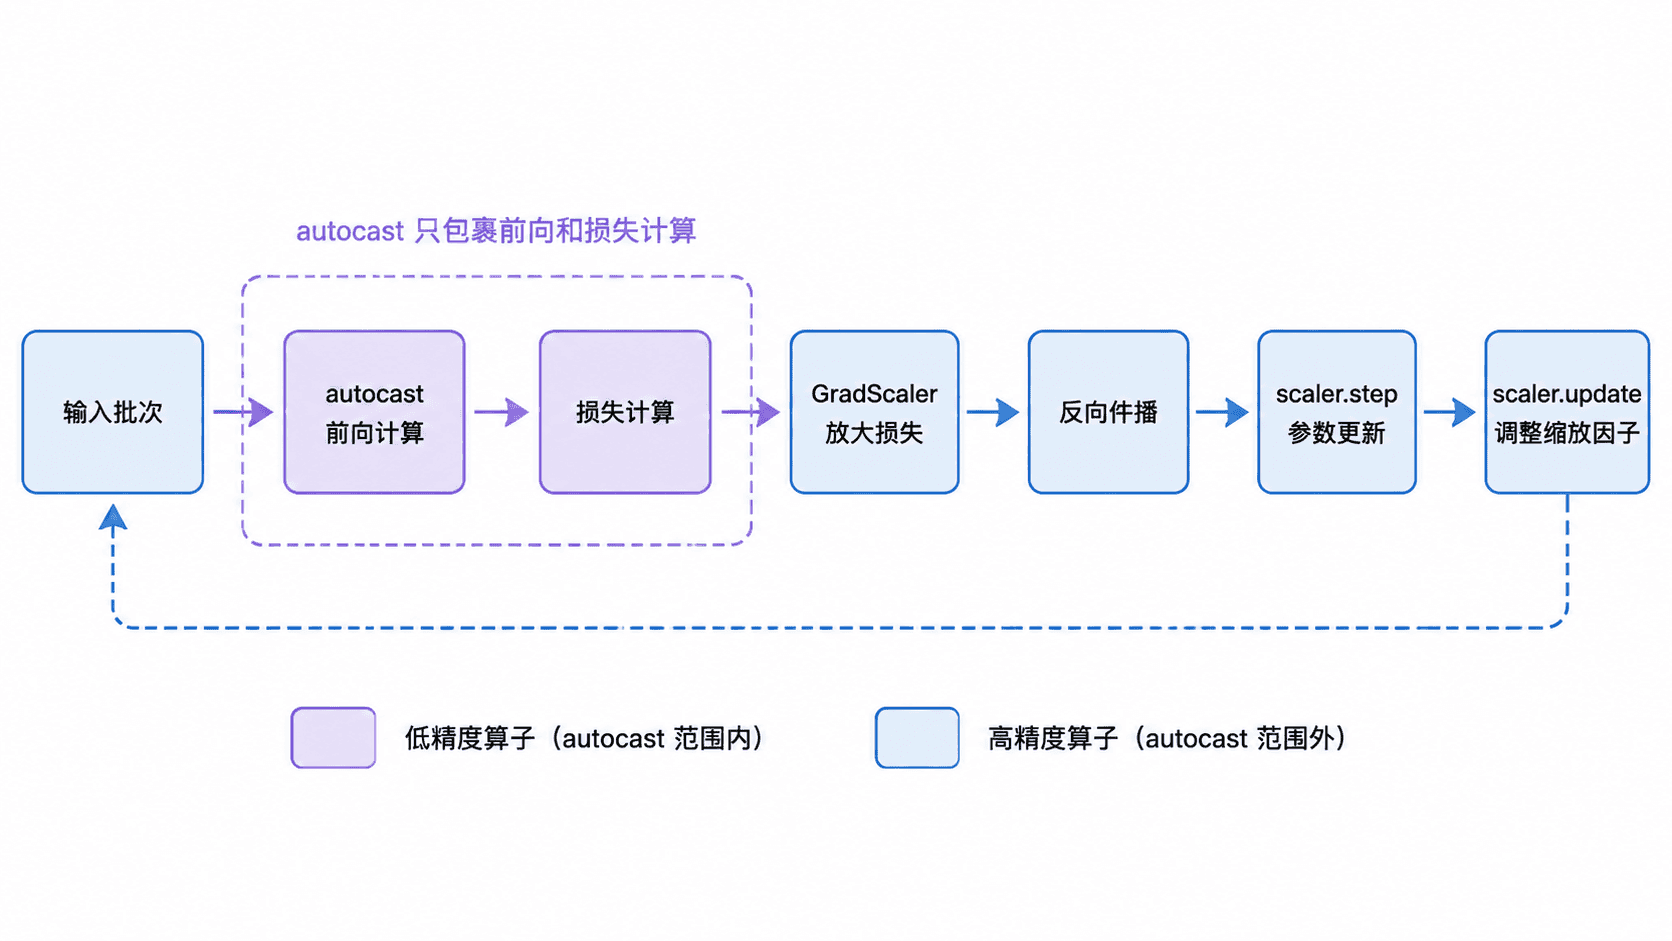
AMP 不是把整个模型永久转换成 float16。进入 autocast 区域后,矩阵乘法、卷积等适合低精度的算子可以使用 float16,对数值范围更敏感的算子则保留更高精度,从而兼顾吞吐量与稳定性。
使用 float16 训练时,较小的梯度可能因表示范围有限而下溢为零。GradScaler 会先放大损失再执行反向传播,在参数更新前恢复梯度尺度,并在检测到无穷大或非数值梯度时跳过本次更新。
完整训练示例
下面的程序要求存在可用的 CUDA GPU。模型参数保持默认精度,前向计算和损失计算放在 autocast 中,反向传播由 GradScaler 管理。
import torch
from torch import nn
from torch.utils.data import DataLoader, TensorDataset

if not torch.cuda.is_available():
    raise RuntimeError("本示例需要支持 CUDA 的 GPU")

torch.manual_seed(42)
device = torch.device("cuda")

features = torch.randn(256, 32)
labels = (features.sum(dim=1) > 0).long()
loader = DataLoader(
    TensorDataset(features, labels),
    batch_size=64,
    shuffle=False,
)

model = nn.Sequential(
    nn.Linear(32, 64),
    nn.ReLU(),
    nn.Linear(64, 2),
).to(device)

criterion = nn.CrossEntropyLoss()
optimizer = torch.optim.AdamW(model.parameters(), lr=1e-3)
scaler = torch.amp.GradScaler("cuda")

model.train()
for inputs, targets in loader:
    inputs = inputs.to(device)
    targets = targets.to(device)
    optimizer.zero_grad(set_to_none=True)

    # autocast 只负责前向计算和损失计算的精度选择
    with torch.amp.autocast("cuda", dtype=torch.float16):
        logits = model(inputs)
        loss = criterion(logits, targets)

    # 缩放损失后反向传播,再由 scaler 安全地更新参数
    scaler.scale(loss).backward()
    scaler.step(optimizer)
    scaler.update()

print(f"device={device.type}, amp=True, loss={loss.item():.4f}")
预期输出
device=cuda, amp=True, loss=<LOSS><LOSS> 是最后一个批次的动态损失值,具体数值会受到 GPU、PyTorch 版本和计算精度影响。
关键执行边界
autocast 不应包裹 backward()。反向传播会沿用前向阶段建立的计算图,直接对缩放后的损失调用 backward() 即可。参数更新也不要改回普通的 optimizer.step(),否则会绕过溢出检查和梯度还原。
需要裁剪梯度时,必须先调用 scaler.unscale_(optimizer),再执行 torch.nn.utils.clip_grad_norm_()。此时裁剪的是恢复到正常尺度的梯度,之后仍使用 scaler.step(optimizer) 完成更新。
bfloat16 的动态范围更接近 float32,某些硬件上不需要梯度缩放;本课示例聚焦 CUDA 上常见的 float16 训练路径。
验证是否真正受益
先以相同模型、批量大小和输入形状分别运行普通精度与 AMP,跳过若干预热步骤后再统计稳定阶段。至少记录单步耗时、峰值显存和最终损失,不能只凭 GPU 利用率判断。
AMP 的收益依赖模型结构和硬件。卷积、线性层和较大矩阵运算通常更容易获得加速;模型过小、数据加载过慢或频繁在 CPU 与 GPU 之间同步时,混合精度的优势可能被其他开销抵消。