
机器学习与深度学习 / 系统课时
早停与最佳模型
早停与最佳模型
早停用于在验证性能不再改善时结束训练,避免继续拟合训练集。本课将实现可复用的监控器,在停止前持续保存最佳参数,并验证恢复后的模型确实来自最佳轮次。
学习目标
- 区分训练指标、验证指标与早停判定依据
- 正确设置
patience、min_delta和优化方向 - 保存并恢复验证表现最好的模型参数
为什么不能只保存最后一轮
训练损失通常会持续下降,但验证损失可能先下降后上升。最后一轮参数只是训练结束时的状态,不一定具有最好的泛化能力,因此早停和最佳模型保存必须同时设计。
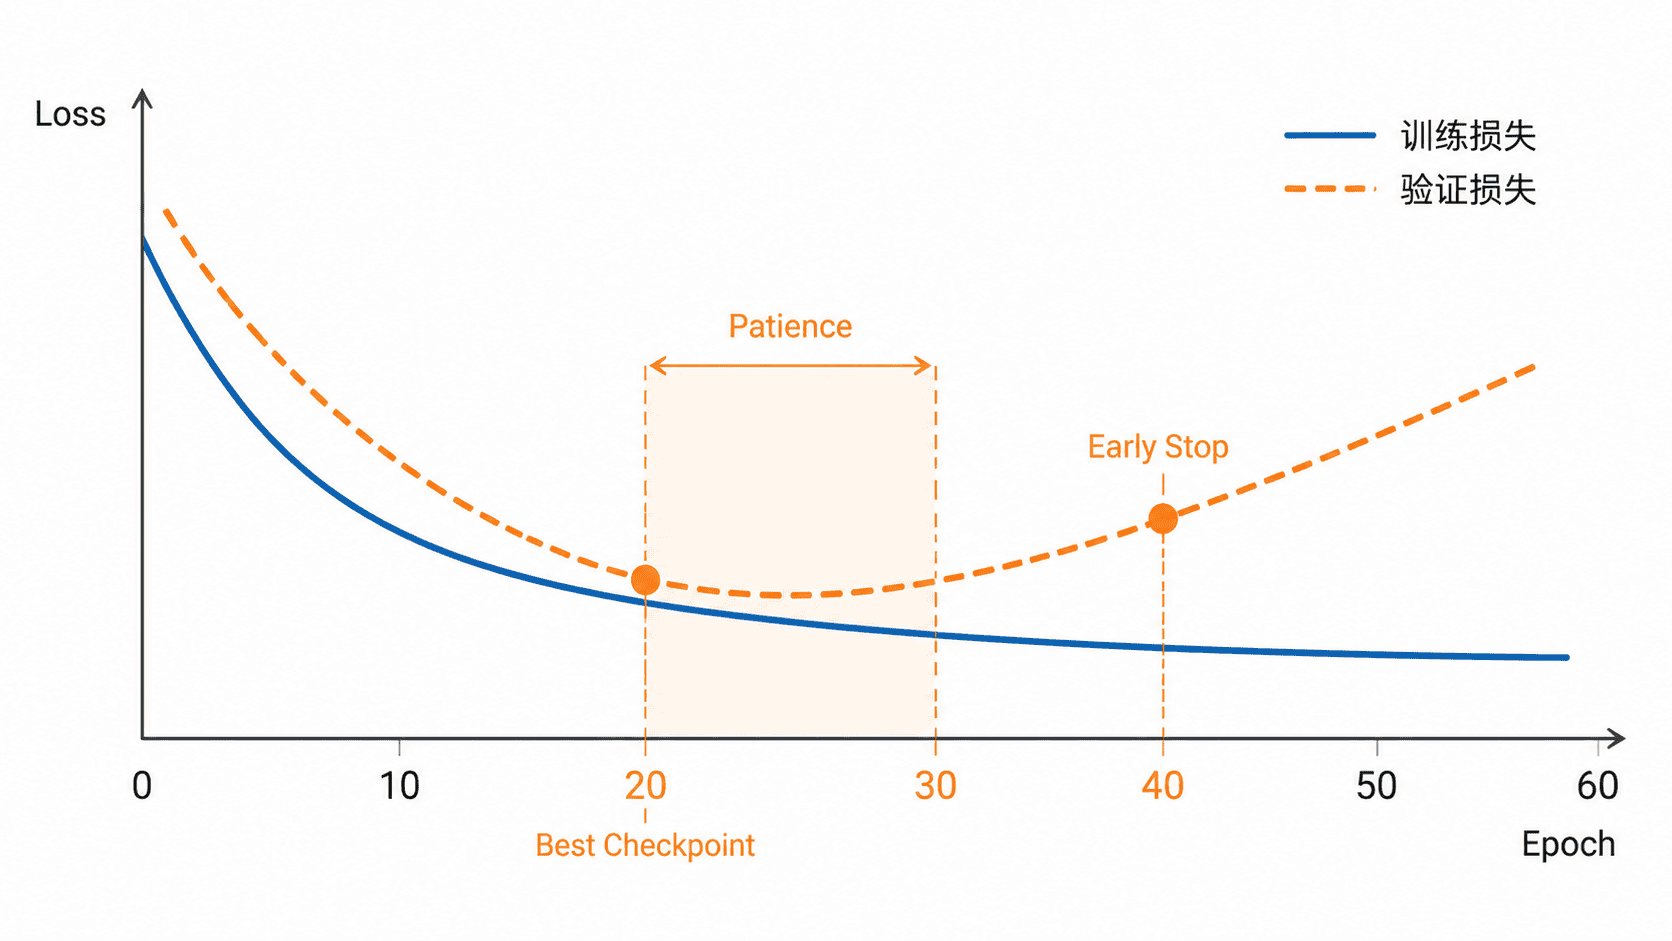
最佳模型应在验证指标每次刷新最优值时立即保存。早停只负责决定何时终止后续训练,两者共享同一项验证指标,但承担不同职责。
定义停止条件
以验证损失为例,数值越小越好。只有当新损失小于 best - min_delta 时,才算真正改善;否则等待计数加一。当连续未改善次数达到 patience,训练停止。
min_delta 可以过滤极小的数值抖动。它过小会让无意义波动不断重置等待计数,过大则可能忽略真实但缓慢的进步。patience 应覆盖验证指标正常波动的周期,而不是机械设置为固定比例。
实现早停与最佳参数保存
下面的可运行示例使用一组预设验证损失模拟训练过程。示例每轮修改模型偏置,只是为了让检查点内容可见;真实项目中应由优化器更新参数,并把实际验证损失传给 update()。
from pathlib import Path
from tempfile import TemporaryDirectory

import torch
from torch import nn

class EarlyStopping:
    def __init__(self, patience: int = 2, min_delta: float = 0.0) -> None:
        self.patience = patience
        self.min_delta = min_delta
        self.best = float("inf")
        self.wait = 0

    def update(self, metric: float, model: nn.Module, path: Path) -> tuple[bool, bool]:
        improved = metric < self.best - self.min_delta

        if improved:
            self.best = metric
            self.wait = 0
            # 只保存参数字典,便于之后恢复到最佳验证轮次
            torch.save(model.state_dict(), path)
        else:
            self.wait += 1

        should_stop = self.wait >= self.patience
        return improved, should_stop

model = nn.Linear(1, 1)
validation_losses = [0.52, 0.44, 0.40, 0.405, 0.41, 0.42]
stopper = EarlyStopping(patience=2, min_delta=0.001)

with TemporaryDirectory() as directory:
    checkpoint = Path(directory) / "best.pt"

    for epoch, val_loss in enumerate(validation_losses, start=1):
        # 模拟每轮训练后模型参数发生变化
        with torch.no_grad():
            model.bias.fill_(float(epoch))

        improved, should_stop = stopper.update(val_loss, model, checkpoint)
        print(
            f"epoch={epoch} val_loss={val_loss:.3f} "
            f"improved={improved} wait={stopper.wait}"
        )

        if should_stop:
            print(f"early stop at epoch {epoch}")
            break

    # 恢复最佳轮次,而不是保留停止时的参数
    state_dict = torch.load(checkpoint, map_location="cpu", weights_only=True)
    model.load_state_dict(state_dict)
    print("restored bias:", model.bias.item())
预期输出:
epoch=1 val_loss=0.520 improved=True wait=0
epoch=2 val_loss=0.440 improved=True wait=0
epoch=3 val_loss=0.400 improved=True wait=0
epoch=4 val_loss=0.405 improved=False wait=1
epoch=5 val_loss=0.410 improved=False wait=2
early stop at epoch 5
restored bias: 3.0
最佳验证损失出现在第 3 轮,因此恢复后的偏置为 3.0。训练在第 5 轮结束,是因为第 4、5 轮连续两次没有达到至少 0.001 的改善。
接入真实训练循环
每轮应先完成训练,再在 model.eval() 和 torch.no_grad() 环境下计算完整验证集指标,最后调用早停监控器。不能用训练损失触发早停,否则监控到的是拟合能力,而不是泛化能力。
若只为推理部署,保存 model.state_dict() 通常足够。若停止后还要继续训练,应同时保存优化器、学习率调度器、当前轮次和随机状态,避免恢复后学习率或动量与模型参数不一致。
验收与边界检查
完成接入后至少验证三件事:指标改善时检查点会被覆盖;达到耐心次数后训练立即退出;重新加载后模型指标等于历史最佳值,而不是停止轮次的指标。
准确率、F1 等越大越好的指标,需要把比较方向改为大于。分布式训练时通常只让主进程写检查点,并把停止信号同步给其他进程,避免多个进程同时写同一个文件。