
机器学习与深度学习 / 系统课时
开发任务与学习路线
开发任务与学习路线
完成一个深度学习项目,不只是写出能够训练的模型,还要验证效果、执行推理、保存产物并交付运行。本课梳理训练、验证、推理和部署四个阶段的职责,并给出一条能够逐步验收的 PyTorch 学习路线。
学习目标
- 区分训练、验证、推理和部署阶段的输入与产出
- 建立从最小实验到工程交付的学习顺序
- 运行一个包含训练、验证、推理和模型保存的最小闭环
四个阶段分别解决什么问题
训练阶段的目标是让模型从数据中学习参数。开发者需要准备训练数据、定义模型与损失函数、执行反向传播,并通过优化器不断更新权重。训练阶段的主要产出是模型参数和训练指标。
验证阶段不更新参数,而是使用未参与当前训练的数据评估模型。它用于发现过拟合、选择超参数和决定保存哪个模型版本。验证代码应切换到评估模式,并关闭梯度计算。
推理阶段把训练完成的模型用于新数据。此时更关注输入预处理、输出解释、响应速度和内存占用,而不是损失能否继续下降。
部署阶段将推理能力交付给真实用户或其他系统,可能采用 HTTP 服务、批处理任务、移动端模型或边缘设备。除了模型文件,还要处理版本管理、运行环境、监控、回滚和数据漂移。
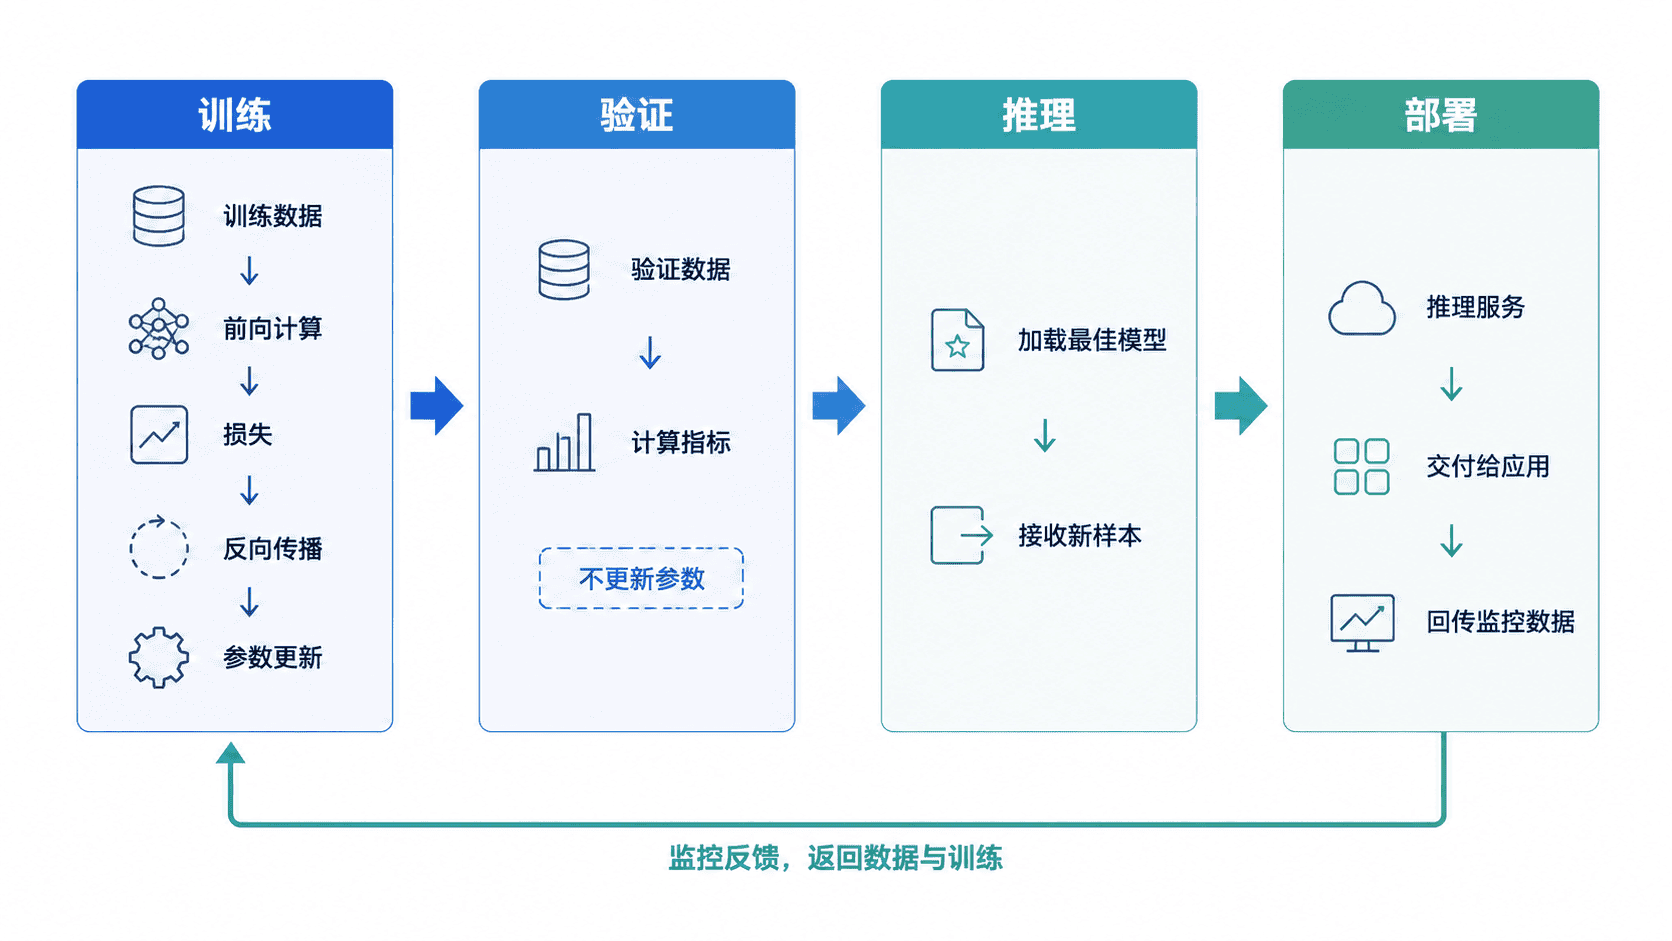
运行一个最小开发闭环
下面的完整示例使用线性数据训练一个回归模型。代码同时包含数据拆分、训练、验证、推理和模型参数保存,对应一个最小但完整的开发流程。
import torch
from torch import nn
from torch.utils.data import DataLoader, TensorDataset, random_split

torch.manual_seed(42)

# 构造关系为 y = 3x + 2 的可学习数据
x = torch.linspace(-1, 1, steps=200).unsqueeze(1)
y = 3 * x + 2
dataset = TensorDataset(x, y)

train_set, val_set = random_split(
    dataset,
    [160, 40],
    generator=torch.Generator().manual_seed(42),
)
train_loader = DataLoader(train_set, batch_size=32, shuffle=True)
val_loader = DataLoader(val_set, batch_size=40)

model = nn.Linear(1, 1)
loss_fn = nn.MSELoss()
optimizer = torch.optim.SGD(model.parameters(), lr=0.1)

for _ in range(100):
    model.train()
    for features, targets in train_loader:
        predictions = model(features)
        loss = loss_fn(predictions, targets)

        optimizer.zero_grad()
        loss.backward()
        optimizer.step()

# 验证和推理阶段不需要记录梯度
model.eval()
with torch.no_grad():
    val_features, val_targets = next(iter(val_loader))
    val_loss = loss_fn(model(val_features), val_targets)
    sample_prediction = model(torch.tensor([[4.0]]))

torch.save(model.state_dict(), "linear_model.pt")
print(f"validation_loss={val_loss.item():.6f}")
print(f"prediction_at_4={sample_prediction.item():.3f}")
print("saved=linear_model.pt")
预期输出:
validation_loss=<SMALL_VALUE>
prediction_at_4=<VALUE_NEAR_14>
saved=linear_model.pt
<SMALL_VALUE> 应接近 0,<VALUE_NEAR_14> 应接近 14。不同 PyTorch 版本和浮点计算环境可能产生轻微差异。运行结束后,当前目录还应出现 linear_model.pt,它保存的是模型参数,而不是完整部署服务。
从实验代码走向工程项目
第一阶段应掌握张量操作、自动求导、常用网络层、损失函数和优化器,能够在单个脚本中训练并验证一个小模型。此时重点是理解执行过程,而不是搭建复杂目录。
第二阶段应学习自定义数据集、批量加载、指标统计、随机种子、设备选择和检查点保存。代码需要拆分为数据、模型、训练和配置模块,并保证实验可以重复运行。
第三阶段再进入工程交付,包括模型导出、接口封装、容器部署、性能测试、日志监控和版本回滚。部署之前还要固定输入格式与预处理规则,否则训练环境和线上环境可能产生不同结果。
建议的学习顺序
可以按以下顺序推进,每一步都应完成可验证产物:
- 使用张量完成数据变换,并理解形状与数据类型。
- 使用自动求导和优化器训练一个线性模型。
- 使用
Dataset和DataLoader组织训练集与验证集。 - 完成图像或文本任务,记录损失和核心评估指标。
- 保存最佳模型,编写独立推理程序加载模型。
- 将推理程序封装为服务,并补充性能与异常监控。
不要在尚未完成独立推理前直接进入部署。能训练不代表能交付,只有模型能够被重新加载,并对固定输入产生符合预期的输出,才算形成可部署产物。
阶段验收标准
训练阶段要确认损失整体下降,且参数确实发生变化;验证阶段要确认没有执行反向传播,并记录独立指标;推理阶段要确认程序能加载保存的参数;部署阶段要确认调用方能够稳定获得结果,并能识别模型版本和异常请求。
当结果异常时,应先判断问题属于数据、训练、验证、推理还是运行环境。按阶段定位通常比直接修改模型结构更高效,也能避免把数据处理错误误判为算法问题。