
机器学习与深度学习 / 系统课时
构建推理接口
构建推理接口
模型文件准备好之后,还需要一个稳定的服务边界来接收输入、执行预处理并返回预测。本课使用 FastAPI 构建最小可运行接口,确保模型只加载一次、非法请求被拦截,并让响应结构保持明确可验证。
学习目标
- 定义带长度和数值约束的预测请求与响应模型
- 在服务启动阶段加载模型,并使用推理模式执行预测
- 通过 HTTP 请求验证成功响应和接口运行状态
接口需要承担什么
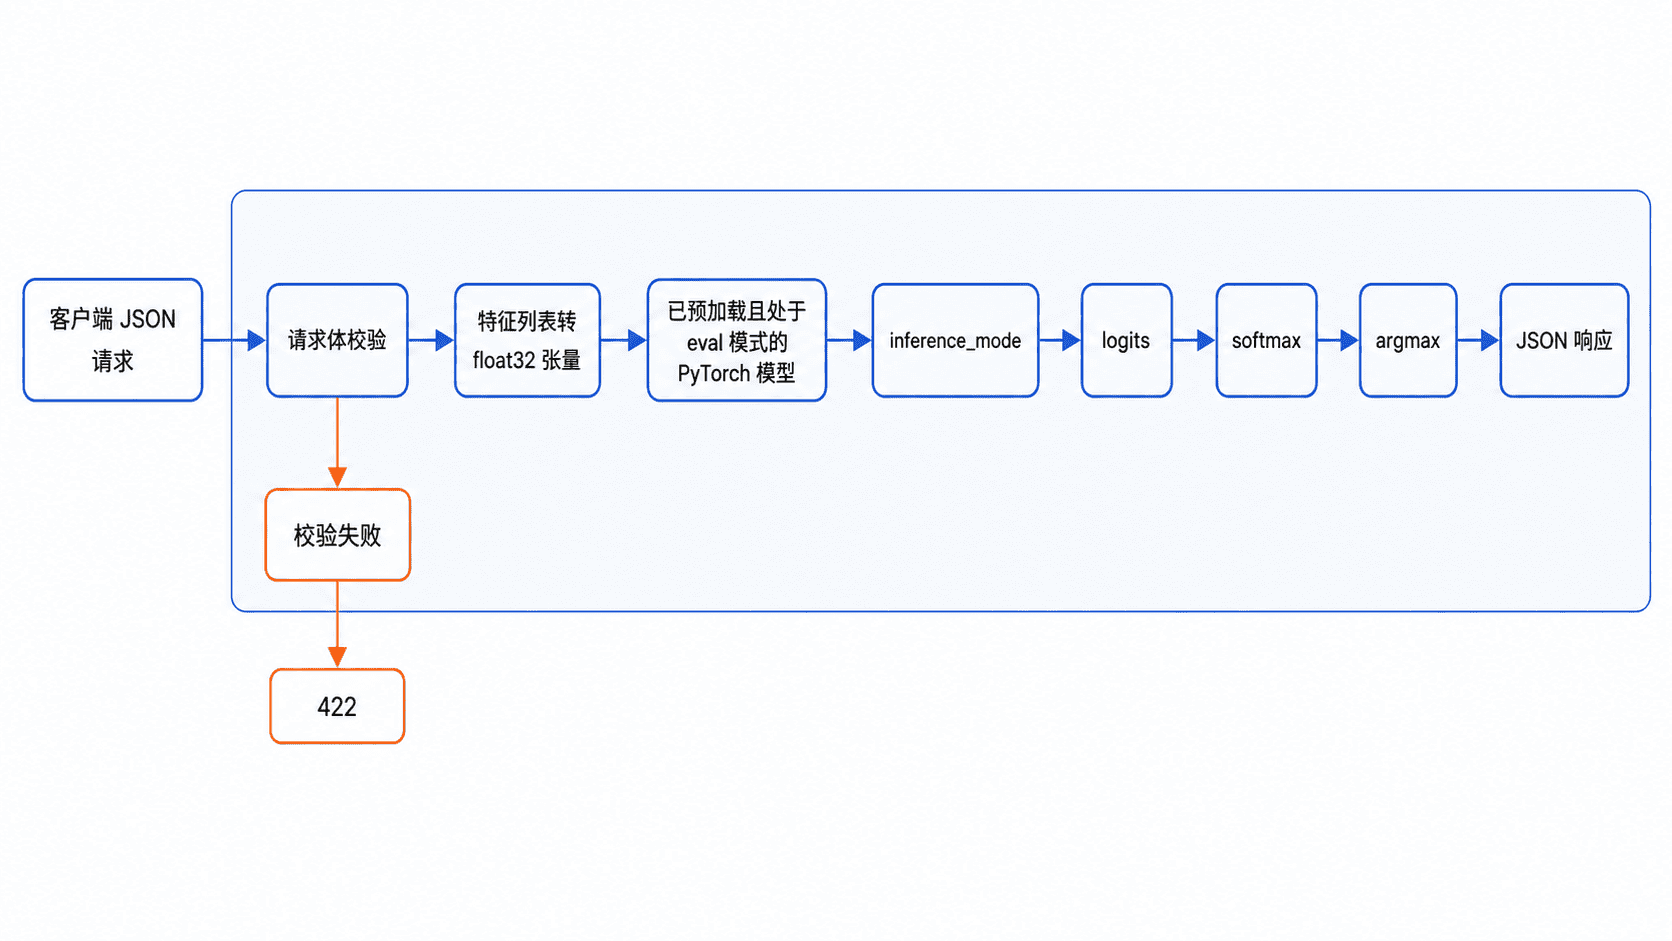
推理接口不应只是把 model(x) 暴露出去。它至少要负责输入校验、张量转换、模型调用、后处理和响应序列化;生产环境还应补充鉴权、限流、日志、指标与超时控制。
完整服务实现
下面的 app.py 使用四维特征输入和三分类线性模型。为了让示例能够独立运行,首次启动时会生成一份固定的演示权重;生产环境应删除自动生成逻辑,并把 MODEL_PATH 指向经过验证的真实模型权重。
import math
from contextlib import asynccontextmanager
from pathlib import Path

import torch
from fastapi import FastAPI, Request
from pydantic import BaseModel, Field, field_validator
from torch import nn

MODEL_PATH = Path("classifier-state.pth")

class TinyClassifier(nn.Module):
    def __init__(self) -> None:
        super().__init__()
        self.linear = nn.Linear(4, 3)

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        return self.linear(x)

def create_demo_weights(path: Path) -> None:
    model = TinyClassifier()
    with torch.no_grad():
        model.linear.weight.copy_(
            torch.tensor(
                [
                    [0.5, -0.2, 0.1, 0.0],
                    [-0.1, 0.3, 0.4, -0.2],
                    [0.2, 0.1, -0.3, 0.5],
                ],
                dtype=torch.float32,
            )
        )
        model.linear.bias.copy_(
            torch.tensor([0.1, -0.05, 0.0], dtype=torch.float32)
        )
    torch.save(model.state_dict(), path)

def load_model() -> TinyClassifier:
    if not MODEL_PATH.exists():
        create_demo_weights(MODEL_PATH)

    model = TinyClassifier()
    state_dict = torch.load(
        MODEL_PATH,
        map_location="cpu",
        weights_only=True,
    )
    model.load_state_dict(state_dict)
    model.eval()
    return model

@asynccontextmanager
async def lifespan(app: FastAPI):
    # 启动时加载一次,避免每个请求重复读取模型文件。
    app.state.model = load_model()
    yield
    del app.state.model

app = FastAPI(title="Tiny Classifier API", lifespan=lifespan)

class PredictRequest(BaseModel):
    features: list[float] = Field(min_length=4, max_length=4)

    @field_validator("features")
    @classmethod
    def reject_non_finite(cls, values: list[float]) -> list[float]:
        if not all(math.isfinite(value) for value in values):
            raise ValueError("features must contain finite numbers")
        return values

class PredictResponse(BaseModel):
    class_id: int
    confidence: float
    probabilities: list[float]

@app.get("/health")
def health() -> dict[str, str]:
    return {"status": "ok"}

@app.post("/predict", response_model=PredictResponse)
def predict(payload: PredictRequest, request: Request) -> PredictResponse:
    model: TinyClassifier = request.app.state.model
    inputs = torch.tensor([payload.features], dtype=torch.float32)

    # inference_mode 同时关闭梯度记录和推理中不需要的状态更新。
    with torch.inference_mode():
        logits = model(inputs)
        probabilities = torch.softmax(logits, dim=1)[0]

    class_id = int(torch.argmax(probabilities).item())
    values = [round(float(value), 6) for value in probabilities.tolist()]
    return PredictResponse(
        class_id=class_id,
        confidence=values[class_id],
        probabilities=values,
    )
预期结果:将代码保存为 app.py 后,首次启动会在当前目录创建 classifier-state.pth,随后模型被加载到应用状态中。访问 /health 返回服务状态,访问 /predict 返回类别、置信度和全部类别概率。
启动并发送请求
运行环境需要安装 torch、fastapi、pydantic 和 uvicorn。在 app.py 所在目录启动服务:
uvicorn app:app --host 0.0.0.0 --port 8000预期输出:
INFO:     Started server process [<ID>]
INFO:     Application startup complete.
INFO:     Uvicorn running on http://0.0.0.0:8000
<ID> 为动态进程号,日志格式可能随 Uvicorn 版本略有差异。服务启动后发送预测请求:
curl -X POST "http://127.0.0.1:8000/predict" -H "Content-Type: application/json" -d '{"features":[1.0,0.5,-0.5,2.0]}'预期状态码为 200,响应体为:
{"class_id":2,"confidence":0.656997,"probabilities":[0.254088,0.088915,0.656997]}校验与部署边界
features 长度不是 4,或包含 NaN、正无穷等非有限值时,请求会在进入模型前被拒绝。这样可以把输入错误与模型故障分开,避免错误数据进入张量计算。
模型在应用生命周期开始时加载一次,请求处理中只读取参数,不修改权重。替换模型文件后必须重启当前进程,或额外实现受控的热更新机制;直接覆盖正在使用的文件并不能让内存模型自动变化。
示例监听 0.0.0.0 是为了便于容器或局域网访问。生产环境不应直接暴露开发服务器,应在反向代理或网关之后配置 HTTPS、鉴权、请求大小限制、并发控制、访问日志和健康检查。
验收检查
/health能稳定返回{"status":"ok"},并且模型加载失败时服务启动直接失败- 合法四维输入返回
200,概率列表长度为 3,且总和接近 1 - 非法长度和非有限数值不会进入模型推理
- 连续请求不会重复读取权重文件,也不会产生梯度