
机器学习与深度学习 / 系统课时
实现验证流程
实现验证流程
验证流程的目标是用固定模型状态评估未参与当前更新的数据,同时不记录梯度、不修改参数,也不让 Dropout 或 BatchNorm 继续按训练规则运行。完成本课后,你将得到一个可直接嵌入训练循环的验证函数。
学习目标
- 正确组合
model.eval()与torch.inference_mode() - 统计验证集平均损失与准确率
- 在验证结束后恢复模型原有训练状态
验证为什么必须与训练隔离
训练阶段需要梯度、参数更新和随机正则化;验证阶段只需要前向计算。若仍处于训练模式,Dropout 会继续随机丢弃神经元,BatchNorm 也会更新运行统计量,导致同一批验证数据得到不稳定结果,甚至污染后续训练状态。
验证时应先切换到评估模式,再关闭梯度记录,逐批累计损失和正确样本数。若验证函数可能在训练循环中被调用,还应保存进入函数前的模式,并在结束后恢复。
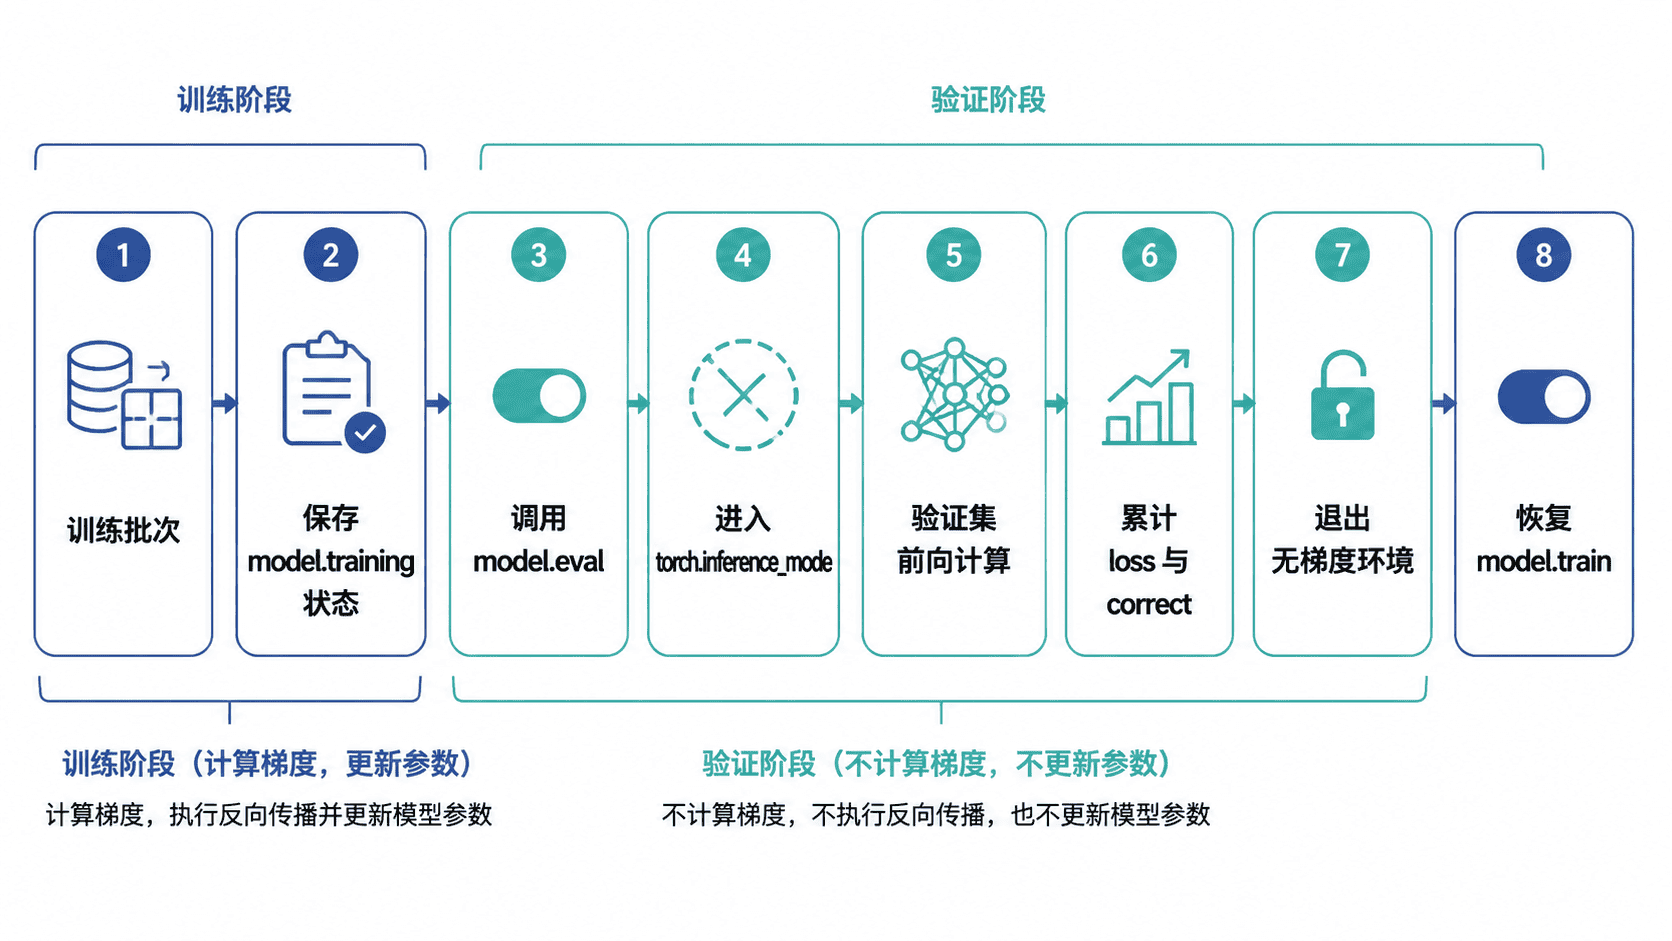
编写可复用的验证函数
下面的完整示例构造一个固定权重的二分类模型,并验证平均交叉熵损失、准确率、梯度状态和模式恢复结果。
python
import torch
from torch import nn
from torch.utils.data import DataLoader, TensorDataset

class TinyClassifier(nn.Module):
    def __init__(self) -> None:
        super().__init__()
        self.linear = nn.Linear(2, 2)

        # 固定参数,便于验证输出是否符合预期
        with torch.no_grad():
            self.linear.weight.copy_(
                torch.tensor([[1.0, 0.0], [0.0, 1.0]])
            )
            self.linear.bias.zero_()

    def forward(self, features: torch.Tensor) -> torch.Tensor:
        return self.linear(features)

@torch.inference_mode()
def validate(
    model: nn.Module,
    loader: DataLoader,
    criterion: nn.Module,
    device: torch.device,
) -> tuple[float, float, bool]:
    was_training = model.training
    model.eval()

    total_loss = 0.0
    total_correct = 0
    total_samples = 0
    logits_require_grad = True

    for features, targets in loader:
        features = features.to(device)
        targets = targets.to(device)

        logits = model(features)
        loss = criterion(logits, targets)

        # 按样本数加权,避免最后一个小批次造成偏差
        batch_size = targets.size(0)
        total_loss += loss.item() * batch_size
        total_correct += (logits.argmax(dim=1) == targets).sum().item()
        total_samples += batch_size
        logits_require_grad = logits.requires_grad

    if was_training:
        model.train()

    average_loss = total_loss / total_samples
    accuracy = total_correct / total_samples
    return average_loss, accuracy, logits_require_grad

def main() -> None:
    device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
    features = torch.tensor(
        [[2.0, 0.0], [1.0, 0.0], [0.0, 1.0], [0.0, 2.0]]
    )
    targets = torch.tensor([0, 0, 1, 1])
    loader = DataLoader(
        TensorDataset(features, targets),
        batch_size=2,
        shuffle=False,
    )

    model = TinyClassifier().to(device)
    model.train()
    criterion = nn.CrossEntropyLoss()

    loss, accuracy, requires_grad = validate(
        model,
        loader,
        criterion,
        device,
    )

    print(f"val_loss={loss:.4f}")
    print(f"val_accuracy={accuracy:.4f}")
    print(f"logits_requires_grad={requires_grad}")
    print(f"model_training_after_validate={model.training}")

if __name__ == "__main__":
    main()
预期输出:
text
val_loss=0.2201
val_accuracy=1.0000
logits_requires_grad=False
model_training_after_validate=True
torch.inference_mode() 比 torch.no_grad() 限制更严格,适合纯推理和验证;若验证代码中仍需要创建随后参与自动求导的张量,可改用 torch.no_grad()。
接入训练循环并验证
以下为片段示例,展示每个训练轮次结束后的调用位置。它依赖已定义的 num_epochs、train_loader、val_loader、optimizer、criterion 和 device。
python
for epoch in range(num_epochs):
    model.train()
    for features, targets in train_loader:
        optimizer.zero_grad()
        logits = model(features)
        loss = criterion(logits, targets)
        loss.backward()
        optimizer.step()

    val_loss, val_accuracy, _ = validate(
        model,
        val_loader,
        criterion,
        device,
    )
    print(
        f"epoch={epoch + 1}, "
        f"val_loss={val_loss:.4f}, "
        f"val_accuracy={val_accuracy:.4f}"
    )
生效后,参数只会在训练批次中更新,验证阶段仅返回损失与准确率。不要在验证函数中调用 optimizer.step(),也不要直接对各批次损失求平均;最后一个批次较小时,应像主示例一样按样本数加权。
可通过三项结果确认实现正确:验证输出张量的 requires_grad 为 False;验证前后模型参数完全一致;函数返回后的模型模式与调用前一致。
按自己的节奏,确认真正理解。