
机器学习与深度学习 / 系统课时
权重衰减与 Dropout
权重衰减与 Dropout
权重衰减和 Dropout 都能缓解过拟合,但它们作用在完全不同的位置。本课将用一个可运行分类模型同时配置两种正则化,并验证训练模式、评估模式和参数更新时的实际差异。
学习目标
- 理解权重衰减与 Dropout 的作用位置
- 会用
AdamW和参数组配置权重衰减 - 能正确切换
model.train()与model.eval()
两种正则化作用在哪
权重衰减属于优化阶段:优化器更新参数时,额外推动权重保持较小。Dropout 属于前向传播阶段:训练时随机屏蔽部分激活值,迫使网络减少对少数神经元的依赖。
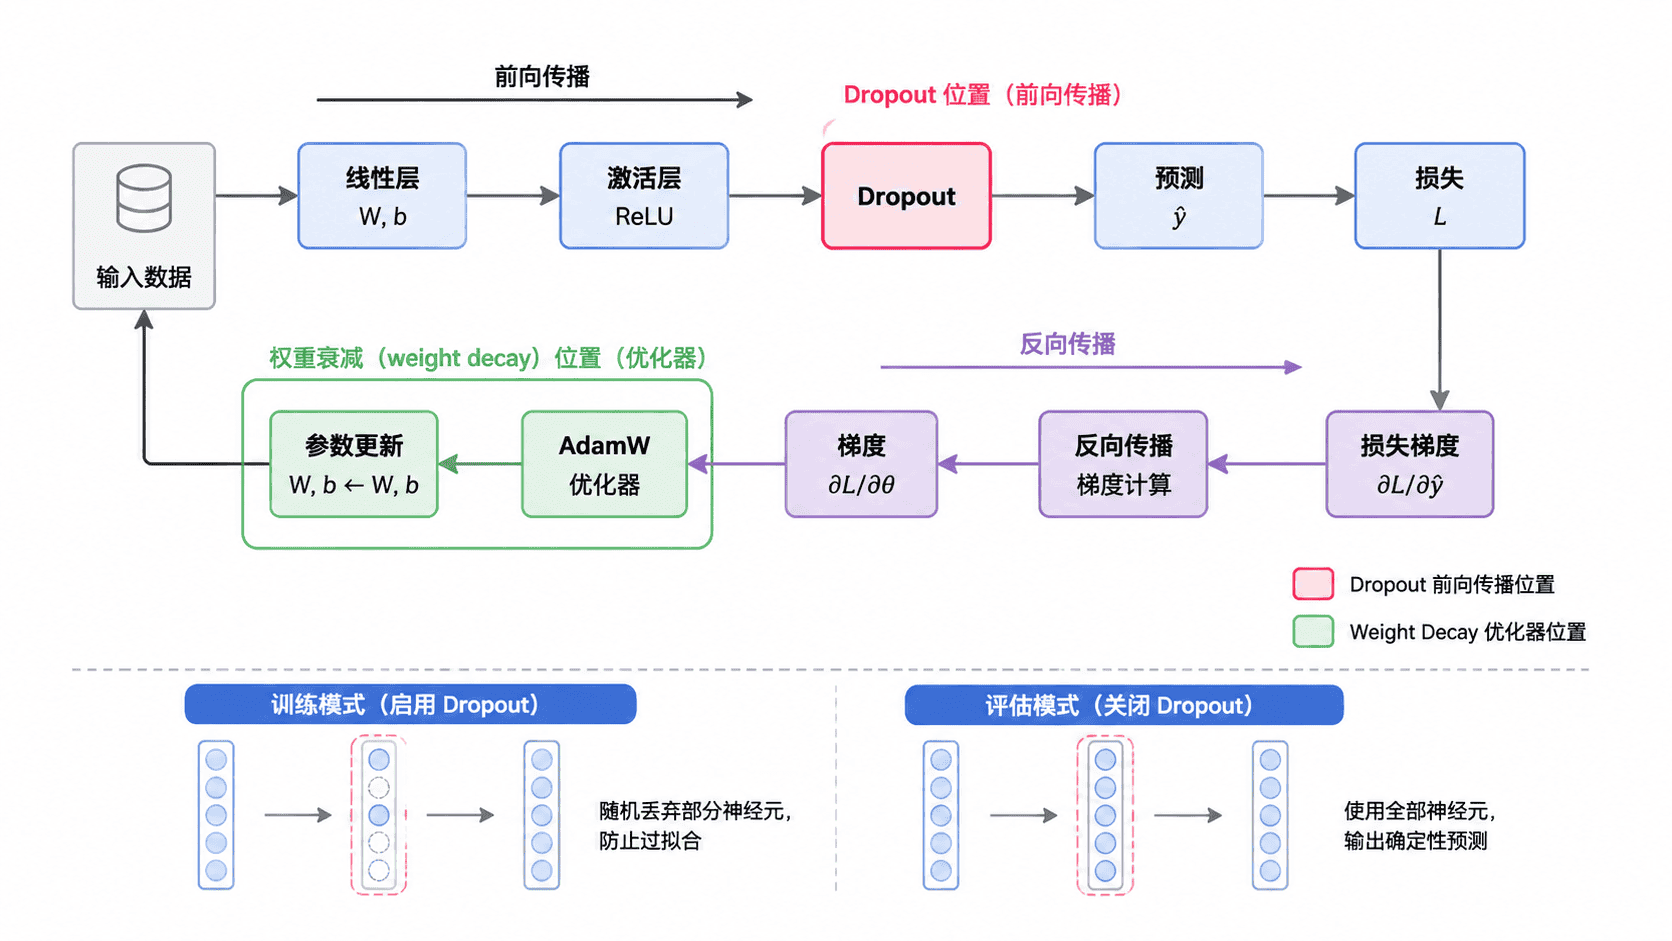
两者可以同时使用,因为一个改变参数更新规则,一个改变训练时的中间表示。它们也都需要验证集来选择强度,正则化过强会造成欠拟合。
权重衰减的配置方式
在 Adam 系列优化器中,通常优先使用 AdamW,通过 weight_decay 配置解耦的权重衰减。实践中常对矩阵权重启用衰减,而对偏置等一维参数关闭衰减,因此可以使用参数组分别设置。
weight_decay 没有通用最优值,可从 1e-4、1e-3 或 1e-2 等量级开始比较。判断依据应是验证集表现,而不是训练损失是否更低。
Dropout 的训练与评估行为
nn.Dropout(p=0.3) 表示训练时以 0.3 的概率将元素置零,并自动缩放保留下来的激活值。调用 model.eval() 后,Dropout 不再随机失活,因此同一输入应得到稳定输出。
torch.no_grad() 只关闭梯度记录,不会自动切换 Dropout。验证和推理通常需要同时使用 model.eval() 与 torch.no_grad(),训练前再调用 model.train() 恢复训练行为。
可运行示例
下面的模型在隐藏层使用 Dropout,并把二维权重与一维偏置放入不同的 AdamW 参数组。程序还会在零梯度条件下执行一次更新,用于验证被衰减权重的范数确实减小。
import torch
from torch import nn

class Classifier(nn.Module):
    def __init__(self):
        super().__init__()
        self.fc1 = nn.Linear(20, 64)
        self.dropout = nn.Dropout(p=0.3)
        self.fc2 = nn.Linear(64, 2)

    def forward(self, x):
        x = torch.relu(self.fc1(x))
        x = self.dropout(x)
        return self.fc2(x)

torch.manual_seed(7)
model = Classifier()

decay_params = []
no_decay_params = []
for parameter in model.parameters():
    # 矩阵权重启用衰减,一维偏置保持不衰减
    target = decay_params if parameter.ndim >= 2 else no_decay_params
    target.append(parameter)

optimizer = torch.optim.AdamW(
    [
        {"params": decay_params, "weight_decay": 1e-2},
        {"params": no_decay_params, "weight_decay": 0.0},
    ],
    lr=1e-3,
)

inputs = torch.ones(2, 20)

model.train()
train_output_1 = model(inputs)
train_output_2 = model(inputs)

model.eval()
with torch.no_grad():
    eval_output_1 = model(inputs)
    eval_output_2 = model(inputs)

weight_norm_before = model.fc1.weight.norm().item()
for parameter in model.parameters():
    parameter.grad = torch.zeros_like(parameter)

# 即使当前梯度为零,AdamW 仍会对启用衰减的权重执行收缩
optimizer.step()
weight_norm_after = model.fc1.weight.norm().item()

print("dropout_train_changes:", not torch.allclose(train_output_1, train_output_2))
print("dropout_eval_stable:", torch.allclose(eval_output_1, eval_output_2))
print(
    "weight_decay_groups:",
    [group["weight_decay"] for group in optimizer.param_groups],
)
print("decayed_weight_norm:", weight_norm_after < weight_norm_before)
预期输出:
dropout_train_changes: True
dropout_eval_stable: True
weight_decay_groups: [0.01, 0.0]
decayed_weight_norm: True
训练模式下两次结果不同,说明 Dropout 每次采样新的掩码;评估模式下结果稳定。最后一行说明启用权重衰减的矩阵权重在优化步骤后变小。
调参顺序与常见错误
先建立不使用正则化的基线,再分别增加权重衰减和 Dropout,最后测试组合效果。若训练集与验证集都表现较差,应优先降低正则化强度,而不是继续增大 weight_decay 或 p。
常见错误包括验证时忘记 model.eval()、把 torch.no_grad() 当成模式切换、对所有参数无差别衰减,以及在网络多处叠加过高的 Dropout。每次调整只改变一个主要变量,才能判断改动是否真正有效。