
机器学习与深度学习 / 系统课时
循环神经网络
循环神经网络
普通全连接网络会把每个输入独立处理,无法自然利用前后顺序。循环神经网络通过隐藏状态在时间步之间传递上下文,使模型能够读取整段序列,并输出每一步表示或最终序列表示。
学习目标
- 理解输入、隐藏状态和时间步之间的关系
- 掌握 PyTorch
nn.RNN的输入与输出形状 - 能用循环层完成基础序列编码
循环状态如何传递
设序列由 组成。RNN 在第 个时间步同时接收当前输入 和上一步隐藏状态 ,再计算新的隐藏状态:
同一组参数会在所有时间步复用,因此模型既能处理不同长度的序列,也能把前面信息逐步传到后面。隐藏状态不是历史数据的原样保存,而是模型压缩后的上下文表示。
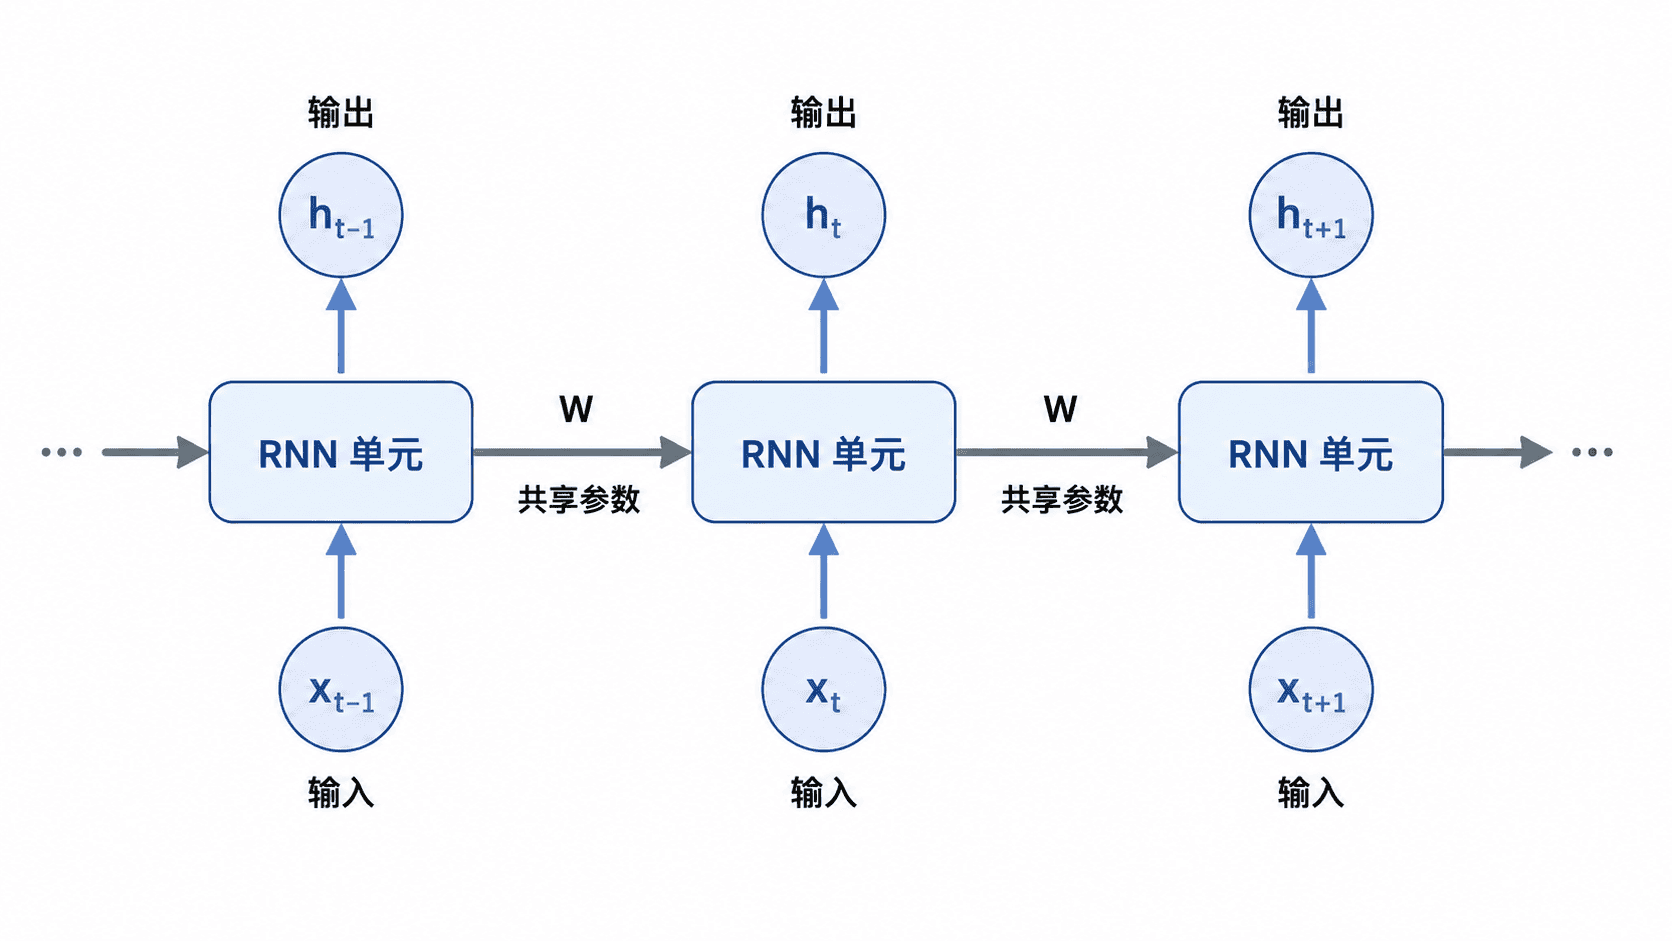
RNN 的“循环”不是程序必须写循环,而是隐藏状态形成递归关系。PyTorch 已在 nn.RNN 内部完成时间步迭代,调用者只需一次传入整个批次的序列张量。
使用 nn.RNN 编码序列
下面示例一次输入两个样本,每个样本包含三个时间步,每步有两个特征。batch_first=True 让输入和输出采用“批次、时间、特征”的顺序。
import torch
from torch import nn

torch.manual_seed(7)

# 两个样本、三个时间步,每个时间步包含两个特征
x = torch.tensor(
    [
        [[1.0, 0.0], [0.5, 0.5], [0.0, 1.0]],
        [[1.0, 1.0], [0.0, 0.5], [0.5, 0.0]],
    ]
)

# batch_first 只改变输入和逐步输出的维度顺序
rnn = nn.RNN(
    input_size=2,
    hidden_size=4,
    num_layers=1,
    batch_first=True,
)

outputs, last_hidden = rnn(x)

print(outputs.shape)
print(last_hidden.shape)
print(torch.allclose(outputs[:, -1, :], last_hidden[0]))
预期输出:
torch.Size([2, 3, 4])
torch.Size([1, 2, 4])
True
outputs 保存所有时间步的隐藏状态,形状为 [batch_size, sequence_length, hidden_size]。last_hidden 只保存每一层最后时间步的隐藏状态,形状始终为 [num_layers, batch_size, hidden_size],不受 batch_first 影响。
选择所需的输出
序列标注任务通常需要每个时间步的表示,因此使用完整的 outputs。文本分类、序列分类等多对一任务常取最后时间步状态,也就是 last_hidden[-1]。
当序列含有填充位置时,不能简单认为张量最后一列就是有效结尾。此时应记录真实长度,并配合 pack_padded_sequence,或者根据长度索引有效时间步,否则模型可能把填充值当作有效输入。
常见边界与错误
独立样本之间通常应重置隐藏状态。未显式传入初始状态时,PyTorch 会使用全零状态;只有连续流式数据确实属于同一序列时,才考虑把上一个批次的状态传给下一个批次。
input_size 必须等于每个时间步的特征数,而不是序列长度。多层 RNN 的 last_hidden 第一维等于层数;双向 RNN 还会把方向数计入这一维,读取最终状态时需要分别处理正向和反向结果。
基础 RNN 能建立短期依赖,但序列很长时容易出现梯度消失或梯度爆炸。实际训练中可使用梯度裁剪控制爆炸问题,而长期依赖通常交给 LSTM 或 GRU 处理。