
机器学习与深度学习 / 系统课时
保存可复用模型
保存可复用模型
训练得到的权重只有在模型结构、类别映射和预处理规则完全一致时才能正确推理。本课将把这些信息与 state_dict 一起保存为可移植文件,并演示如何重建模型、加载权重和验证输出。
学习目标
- 区分必须保存的模型权重、结构参数、类别映射与预处理配置
- 完成一个可运行的模型保存、加载和推理验证流程
- 识别直接保存整个模型对象带来的兼容性问题
可复用模型应保存什么
可复用模型不是单独的权重文件,而是一组能够还原推理环境的契约。至少应包含模型构造参数、参数权重、类别到索引的映射,以及输入尺寸、归一化均值和标准差等预处理配置。
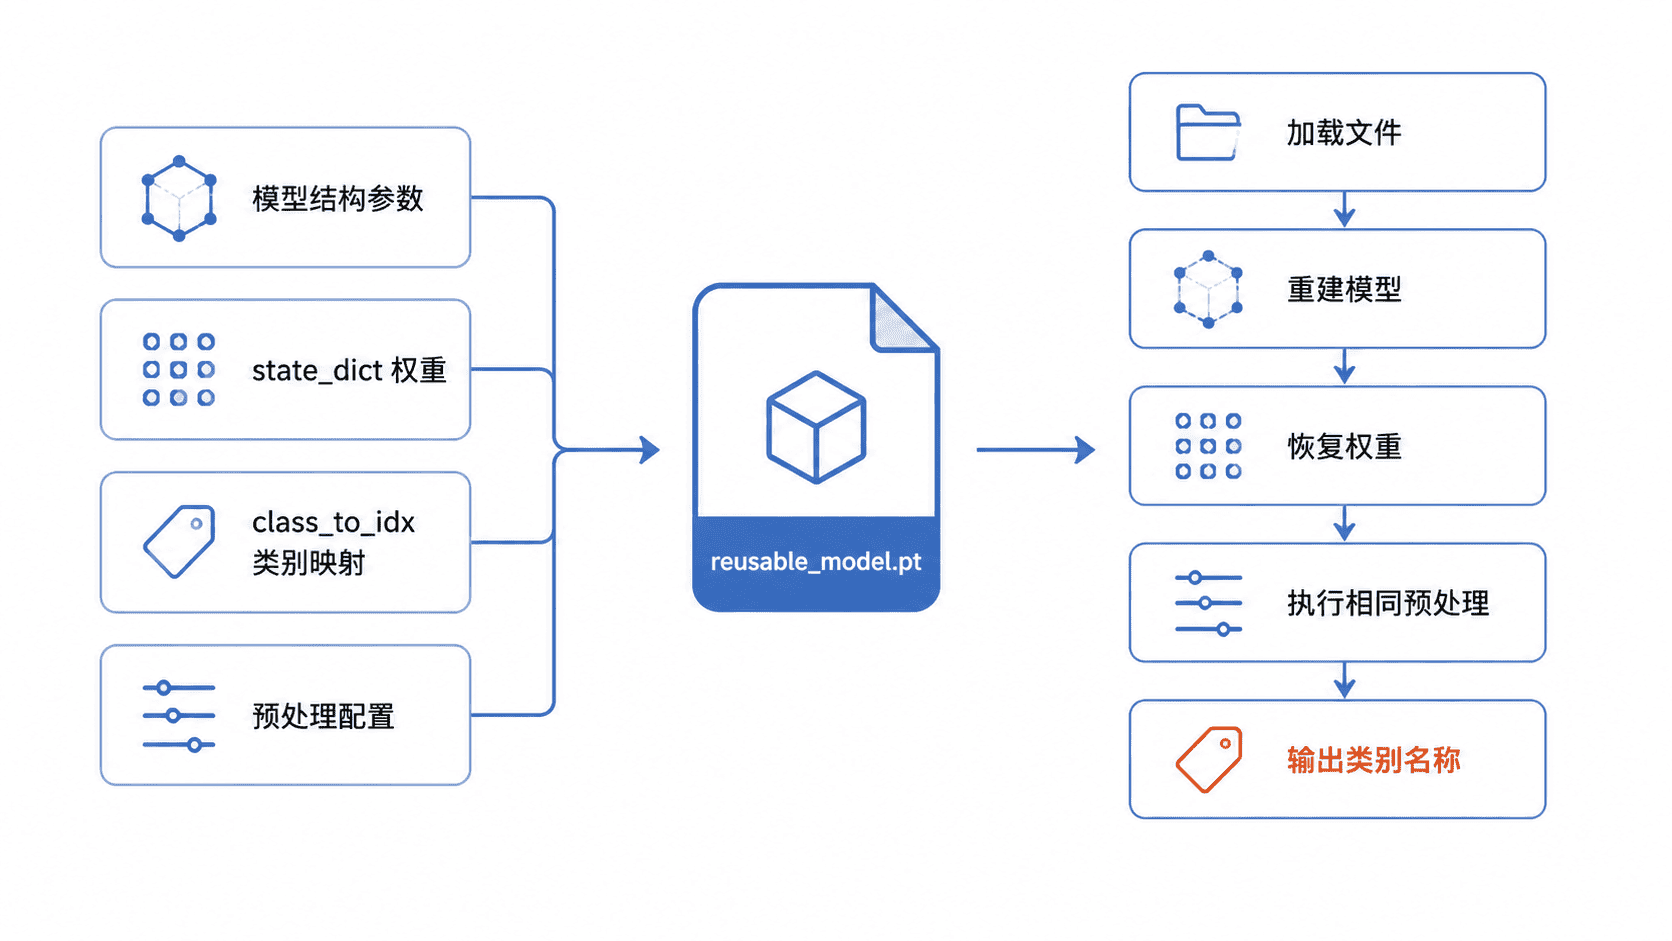
只保存 state_dict 的优点是文件稳定、容易检查,也不会依赖保存时的 Python 对象序列化路径。模型类代码仍应由项目维护,文件中只记录重建它所需的参数。
完整保存与加载示例
下面的脚本定义一个小型图像分类器,将结构参数、类别映射、预处理配置和权重写入同一个文件,再从文件重建模型并完成一次推理。示例使用随机张量模拟已经缩放到 [0, 1] 的图像,因此无需额外数据集。
python
from pathlib import Path

import torch
from torch import nn

class ReusableImageClassifier(nn.Module):
    def __init__(self, num_classes: int, feature_channels: int = 8) -> None:
        super().__init__()
        self.features = nn.Sequential(
            nn.Conv2d(3, feature_channels, kernel_size=3, padding=1),
            nn.ReLU(),
            nn.AdaptiveAvgPool2d((1, 1)),
        )
        self.classifier = nn.Linear(feature_channels, num_classes)

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        x = self.features(x)
        return self.classifier(torch.flatten(x, 1))

def preprocess(image: torch.Tensor, config: dict) -> torch.Tensor:
    # 推理时必须复用训练阶段的归一化参数。
    mean = torch.tensor(config["mean"]).view(1, 3, 1, 1)
    std = torch.tensor(config["std"]).view(1, 3, 1, 1)
    return (image - mean) / std

def main() -> None:
    torch.manual_seed(7)
    output_path = Path("reusable_model.pt")

    class_to_idx = {"cat": 0, "dog": 1, "rabbit": 2}
    model_config = {
        "num_classes": len(class_to_idx),
        "feature_channels": 8,
    }
    preprocessing = {
        "input_size": [3, 32, 32],
        "mean": [0.5, 0.5, 0.5],
        "std": [0.25, 0.25, 0.25],
    }

    model = ReusableImageClassifier(**model_config)
    package = {
        "format_version": 1,
        "model_config": model_config,
        "class_to_idx": class_to_idx,
        "preprocessing": preprocessing,
        "state_dict": model.state_dict(),
    }
    torch.save(package, output_path)

    loaded = torch.load(output_path, map_location="cpu", weights_only=True)
    restored_model = ReusableImageClassifier(**loaded["model_config"])
    restored_model.load_state_dict(loaded["state_dict"])
    restored_model.eval()

    sample = torch.rand(1, *loaded["preprocessing"]["input_size"])
    with torch.inference_mode():
        logits = restored_model(preprocess(sample, loaded["preprocessing"]))
        probabilities = torch.softmax(logits, dim=1)

    print("artifact keys:", sorted(loaded.keys()))
    print("classes:", list(loaded["class_to_idx"].keys()))
    print("output shape:", tuple(probabilities.shape))
    print("probability sum:", round(probabilities.sum().item(), 6))

if __name__ == "__main__":
    main()
预期输出:
text
artifact keys: ['class_to_idx', 'format_version', 'model_config', 'preprocessing', 'state_dict']
classes: ['cat', 'dog', 'rabbit']
output shape: (1, 3)
probability sum: 1.0
运行结束后,当前目录还会生成 reusable_model.pt。实际文件大小会随模型参数量变化,但再次加载后的输出维度应始终与类别数量一致。
一致性验证与常见错误
加载成功不等于模型可用。应同时验证缺失键和多余键均为空、输入尺寸符合配置、输出类别数等于映射长度,并在正式推理前调用 eval(),避免 Dropout 或 BatchNorm 继续采用训练行为。
不要把类别名称写死在推理代码中。训练集目录顺序一旦变化,索引对应关系就可能改变;保存 class_to_idx 后,应在推理时反转为 idx_to_class,再把预测索引转换为业务类别。
直接使用 torch.save(model, path) 会连同对象结构一起序列化,加载时依赖原类所在的模块路径。类名、文件位置或环境变化后都可能失败,因此生产交付通常优先保存 state_dict 与显式配置。
按自己的节奏,确认真正理解。