
机器学习与深度学习 / 系统课时
执行反向传播
执行反向传播
本课通过一个可运行的标量计算示例,演示如何调用 backward() 启动反向传播,并从叶子张量的 .grad 属性读取梯度。完成后,你将能够核对梯度值,并识别非标量输出、重复反向传播等常见边界。
学习目标
- 理解
loss.backward()如何沿计算图反向应用链式法则 - 正确读取启用梯度跟踪的叶子张量的
.grad - 处理非标量输出和重复反向传播的限制
反向传播如何计算梯度
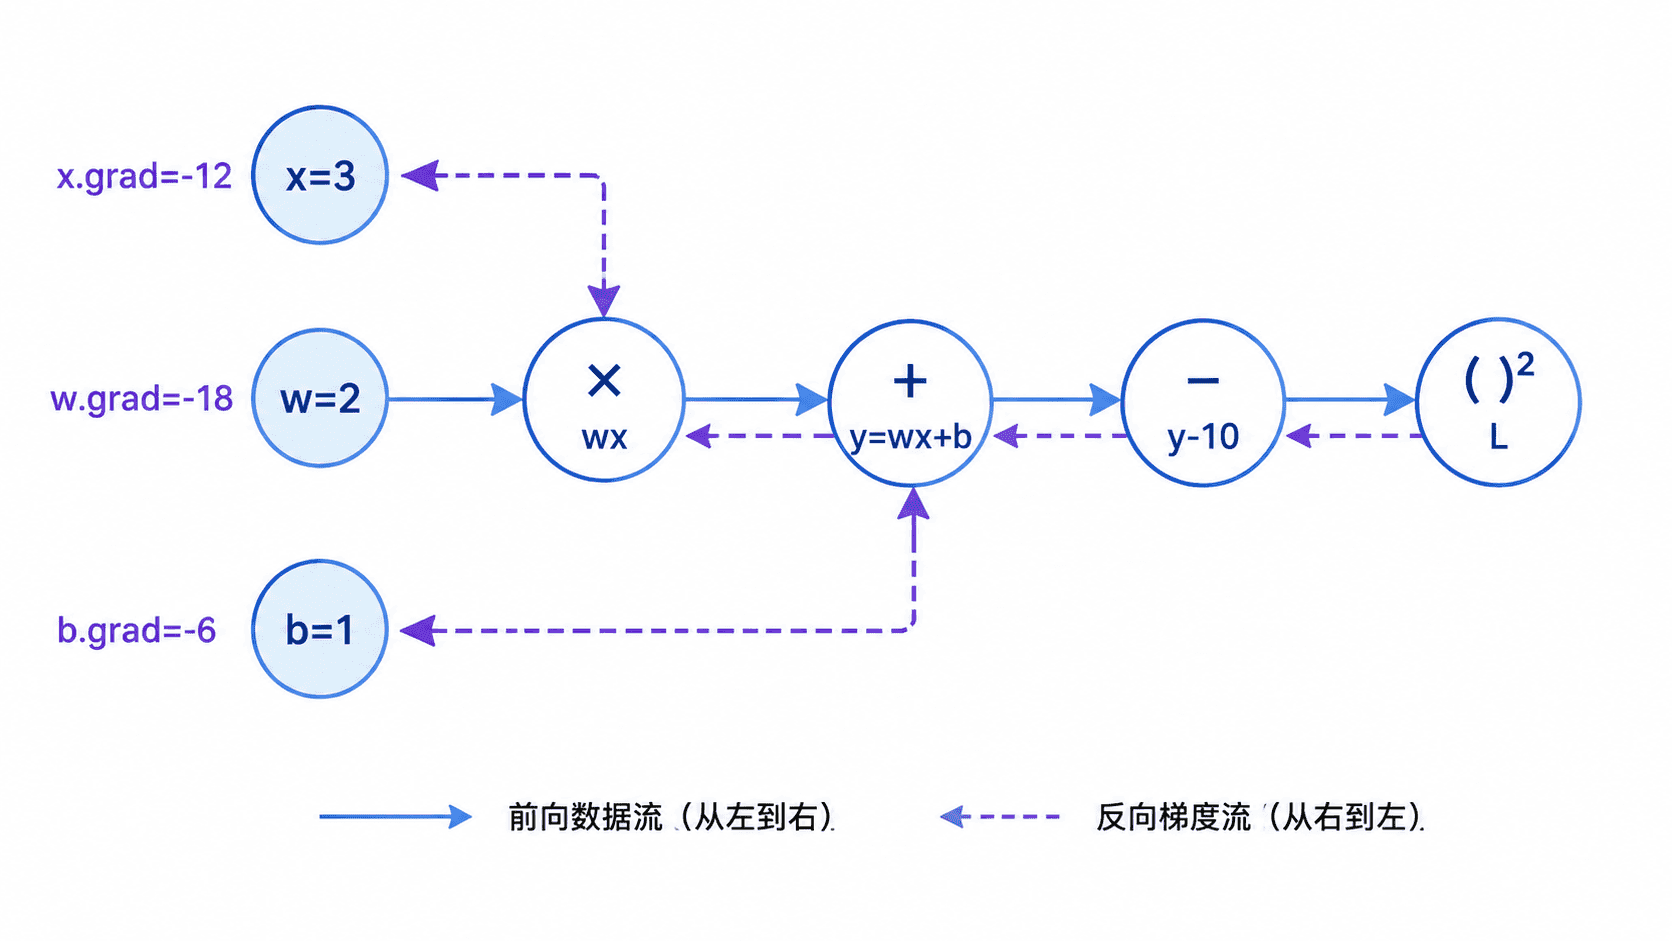
当参与运算的张量设置了 requires_grad=True,PyTorch 会记录后续运算并构建动态计算图。对标量损失调用 backward() 后,自动微分引擎从损失处以初始梯度 1 开始,沿图反向计算每个叶子张量对损失的偏导数。
设 ,损失为 。当 、、 时,前向结果为 、。反向传播会依次计算损失对 的梯度,再乘以前序运算的局部梯度,最终得到 x、w、b 的梯度。
运行并读取梯度
下面的程序创建三个叶子张量,完成前向计算后只调用一次 backward()。.grad 中保存的是损失对对应张量的梯度。
python
import torch

def main() -> None:
    x = torch.tensor(3.0, requires_grad=True)
    w = torch.tensor(2.0, requires_grad=True)
    b = torch.tensor(1.0, requires_grad=True)

    # 前向计算会被自动记录为动态计算图
    y = w * x + b
    loss = (y - 10) ** 2

    # 标量损失可直接反向传播
    loss.backward()

    print(f"loss: {loss.item():.1f}")
    print(f"x.grad: {x.grad.item():.1f}")
    print(f"w.grad: {w.grad.item():.1f}")
    print(f"b.grad: {b.grad.item():.1f}")

if __name__ == "__main__":
    main()
预期输出:
text
loss: 9.0
x.grad: -12.0
w.grad: -18.0
b.grad: -6.0
w.grad=-18 的原因是损失对 的梯度为 ,而 对 的梯度为 ,二者相乘得到 。其他梯度也遵循相同的链式法则。
关键边界
只有叶子张量默认把结果写入 .grad。像 y、loss 这样的中间张量通常不会保留梯度;调试确有需要时,可在反向传播前调用 retain_grad()。
backward() 默认会释放本次反向计算所需的中间缓存,因此不能在同一计算图上直接再次调用。确需重复反向时可使用 retain_graph=True,但训练循环通常应重新执行一次前向计算,而不是长期保留旧图。
当输出不是标量时,PyTorch 无法自动假定起始梯度。此时应向 backward() 传入与输出形状兼容的梯度张量,本质上是在计算向量与雅可比矩阵的乘积。
按自己的节奏,确认真正理解。