
机器学习与深度学习 / 系统课时
张量的设备迁移
张量的设备迁移
模型训练时,张量和模型参数必须位于同一计算设备。本课用一个可运行示例完成 CPU/GPU 自动选择、整体迁移和结果校验,并说明最常见的设备不一致问题。
学习目标
- 理解张量、模型参数和运算设备必须一致的规则
- 掌握
to(device)、cpu()与设备自动选择的用法 - 能定位未赋值迁移、NumPy 转换等常见错误
设备迁移的核心规则
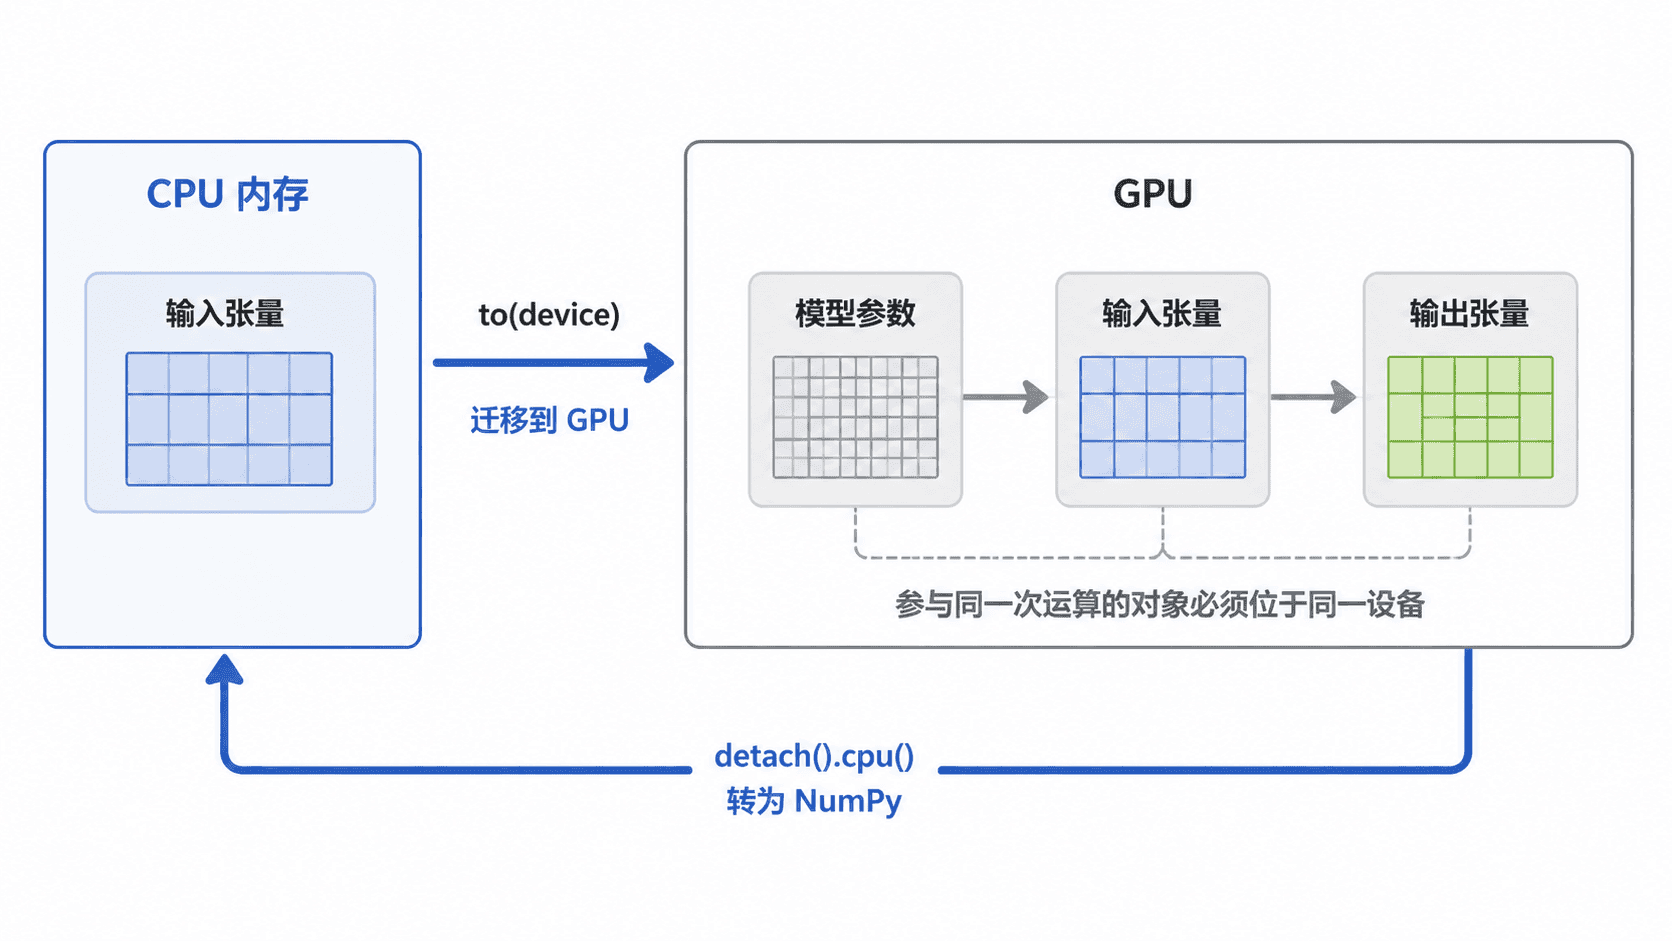
PyTorch 的每个张量都有 device 属性,常见值是 cpu 或 cuda:0。一次运算涉及的输入张量、模型参数和辅助张量通常必须位于同一设备,否则会触发设备不一致异常。
迁移张量时,tensor.to(device) 会返回目标设备上的张量,应接收返回值;迁移模型时,通常写成 model = model.to(device),让代码清楚表达模型已切换设备。
统一选择计算设备
推荐只在程序入口确定一次设备,并把该变量传给模型、批次数据和新建张量。下面的表达式会在 CUDA 可用时选择第一块 GPU,否则回退到 CPU:
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
这种写法不会保证一定使用 GPU,但能让同一份代码在不同机器上运行。多 GPU、Apple 芯片的 MPS 等场景需要额外选择策略,本课先聚焦单设备迁移。
完整迁移示例
下面的程序同时迁移模型、输入和标签,并通过设备比较验证迁移结果。保存为 device_transfer.py 后直接运行。
import torch
from torch import nn

def main() -> None:
    device = torch.device("cuda" if torch.cuda.is_available() else "cpu")

    # 模型参数与输入必须使用同一个 device。
    model = nn.Sequential(
        nn.Linear(4, 8),
        nn.ReLU(),
        nn.Linear(8, 2),
    ).to(device)

    # 张量迁移会返回新引用,因此必须接收 to(device) 的结果。
    features = torch.tensor(
        [[1.0, 2.0, 3.0, 4.0], [4.0, 3.0, 2.0, 1.0]],
        dtype=torch.float32,
    ).to(device)
    labels = torch.tensor([0, 1], dtype=torch.long, device=device)

    # 这里只验证迁移结果,关闭梯度可减少额外开销。
    with torch.no_grad():
        logits = model(features)

    model_device = next(model.parameters()).device
    print(f"input_device == model_device: {features.device == model_device}")
    print(f"label_device == model_device: {labels.device == model_device}")
    print(f"output_shape: {tuple(logits.shape)}")
    print(f"output_device == model_device: {logits.device == model_device}")

if __name__ == "__main__":
    main()
预期输出
input_device == model_device: True
label_device == model_device: True
output_shape: (2, 2)
output_device == model_device: True
无论程序最终选择 CPU 还是 GPU,上述布尔值都应为 True,因此该输出可以稳定验证设备是否统一。
常见错误与修复
最常见的问题是模型已迁移到 GPU,但输入仍在 CPU。应在每个训练批次进入模型前执行 features = features.to(device),标签参与损失计算时也要同步迁移。
第二类错误是只调用 features.to(device) 却没有接收返回值。此时原变量仍可能留在 CPU,应写成重新赋值,或在创建张量时直接传入 device=device。
将结果交给 NumPy 前,张量必须回到 CPU,并与计算图断开。训练代码中通常使用 result.detach().cpu().numpy();直接对 GPU 张量调用 numpy() 会失败。
迁移后的检查方法
调试时可比较 tensor.device 与 next(model.parameters()).device。若模型没有参数,例如只包含无参数算子,则应检查模型缓冲区或直接记录程序统一使用的 device 变量。
迁移只改变数据所在设备,不会自动修改数据类型。需要半精度时,应单独选择 float16、自动混合精度或其他精度策略,避免把“设备迁移”和“精度转换”混为一谈。