
机器学习与深度学习 / 系统课时
归一化层
归一化层
归一化层通过控制中间特征的数值分布,让优化过程更稳定。本课将比较批归一化与层归一化的计算维度、训练和推理行为,并用 PyTorch 验证两者的实际差异。
学习目标
- 说明 BatchNorm 与 LayerNorm 分别沿哪些维度计算统计量
- 理解
train()、eval()对两类归一化层的不同影响 - 能根据批大小、网络结构和任务类型选择合适的归一化层
批归一化如何工作
批归一化 BatchNorm 对同一特征通道收集一组样本的统计量,再完成标准化和可学习的缩放、平移。其核心计算为:
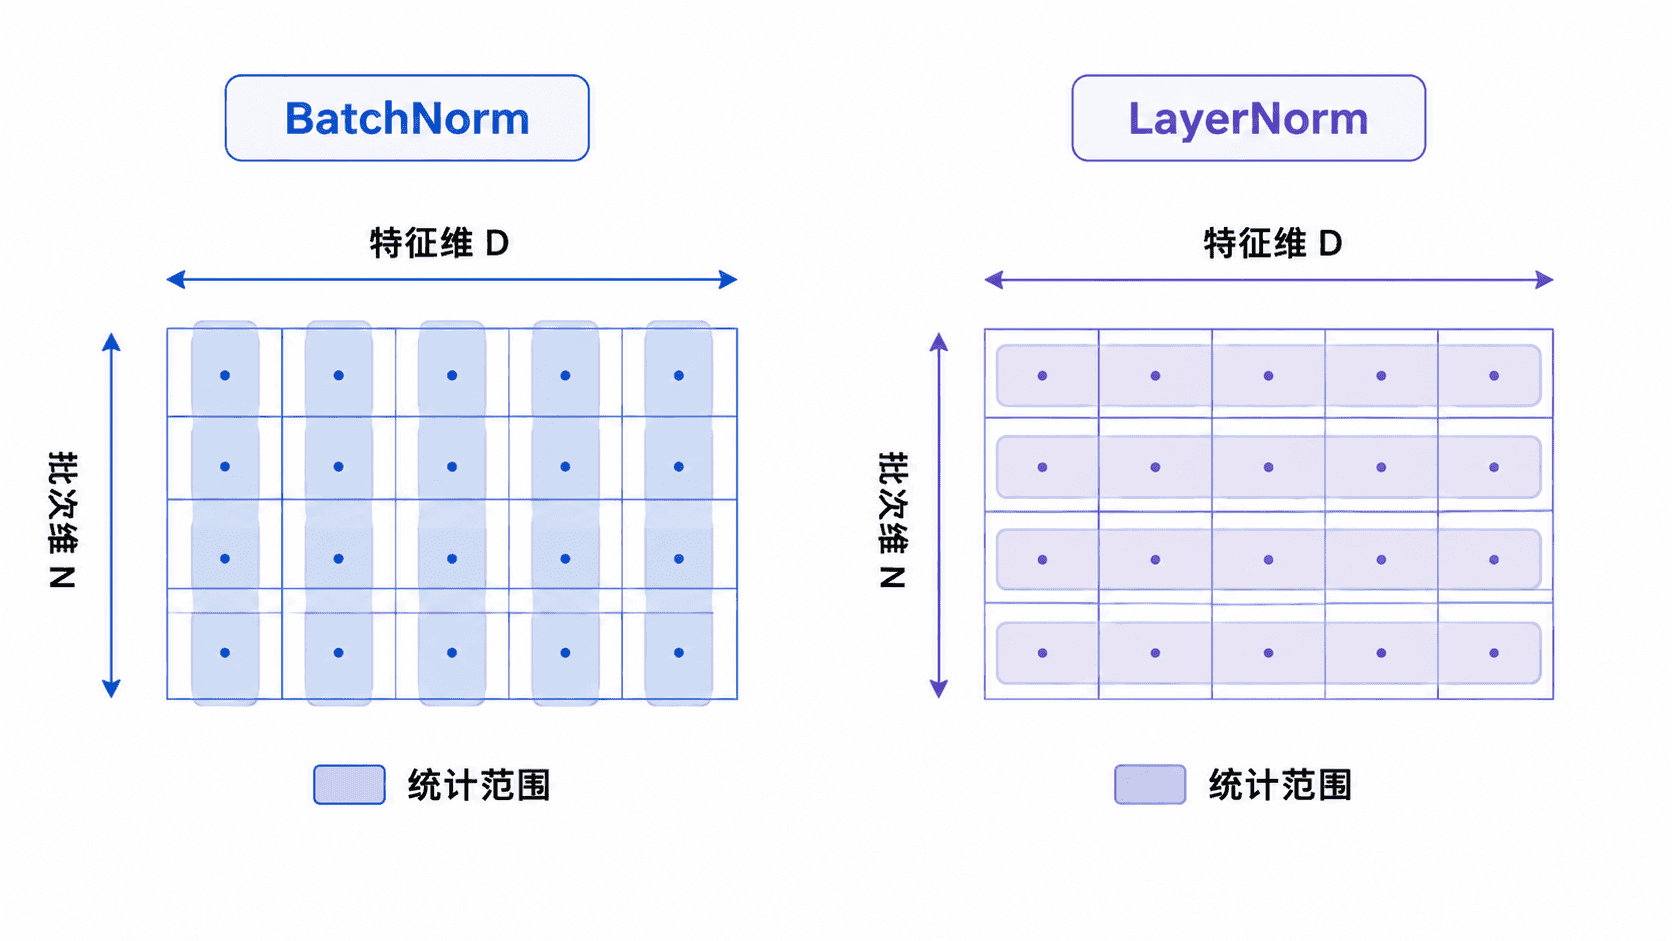
对于形状为 [N, C] 的输入,BatchNorm1d(C) 按通道在批次维 N 上统计均值和方差;对于 [N, C, H, W] 的卷积特征,BatchNorm2d(C) 会按通道在 N、H、W 上共同统计。
训练阶段,BatchNorm 使用当前批次统计量,并更新运行均值与运行方差。推理阶段调用 model.eval() 后,它改用训练期间积累的运行统计量,因此输出不再依赖当前推理批次的组成。
层归一化如何工作
层归一化 LayerNorm 在每个样本内部,对 normalized_shape 指定的末尾维度计算统计量。若输入为 [N, D],LayerNorm(D) 会让每个样本的 D 个特征独立完成归一化,不需要与其他样本交换统计信息。
LayerNorm 不维护运行均值和运行方差,训练与推理都使用当前样本自身的统计量。因此,它不受批大小波动影响,常用于 Transformer、序列模型以及小批量训练。
用 PyTorch 验证差异
下面的示例对同一个 2×4 张量分别应用 BatchNorm 和 LayerNorm,并切换 BatchNorm 的训练、推理模式。为了让结果便于核对,示例关闭了两层的可学习缩放和平移。
import torch
from torch import nn

x = torch.tensor([
    [1.0, 2.0, 3.0, 4.0],
    [5.0, 6.0, 7.0, 8.0],
])

bn = nn.BatchNorm1d(4, affine=False)
ln = nn.LayerNorm(4, elementwise_affine=False)

def rounded(matrix: torch.Tensor) -> list[list[float]]:
    return [[round(value, 4) for value in row] for row in matrix.tolist()]

# 训练模式下,BatchNorm 按列使用当前批次统计量
bn.train()
bn_train = bn(x)
ln_output = ln(x)

print("BN train:", rounded(bn_train))
print("LN:", rounded(ln_output))
print("BN feature mean:", [round(v, 4) for v in bn_train.mean(dim=0).tolist()])
print("LN sample mean:", [round(v, 4) for v in ln_output.mean(dim=1).tolist()])

# 推理模式下,BatchNorm 改用刚刚更新的运行统计量
bn.eval()
print("BN eval:", rounded(bn(x)))
预期输出:
BN train: [[-1.0, -1.0, -1.0, -1.0], [1.0, 1.0, 1.0, 1.0]]
LN: [[-1.3416, -0.4472, 0.4472, 1.3416], [-1.3416, -0.4472, 0.4472, 1.3416]]
BN feature mean: [0.0, 0.0, -0.0, 0.0]
LN sample mean: [0.0, 0.0]
BN eval: [[0.5369, 1.2271, 1.9174, 2.6077], [3.6047, 4.295, 4.9853, 5.6755]]
第一组均值说明 BatchNorm 让每个特征列接近零均值,LayerNorm 则让每个样本行接近零均值。BN eval 与训练输出不同,是因为推理阶段使用运行统计量,而不是重新按当前输入计算。
选择归一化层
卷积网络且批次稳定、批量较大时,BatchNorm 通常是直接有效的选择。批次很小、样本长度变化明显或模型以 Transformer 为主时,LayerNorm 更稳定,也更符合网络结构。
不要把 normalized_shape 误写成批次大小。LayerNorm(特征维度) 描述的是每个样本末尾需要归一化的形状,与一次输入多少条样本无关。
常见错误
验证或推理前忘记执行 model.eval(),会让 BatchNorm 继续使用当前小批次统计量,并继续更新运行统计量。训练恢复后则要重新调用 model.train(),否则 BatchNorm 会一直停留在推理行为。
批次只有一条样本时,某些 BatchNorm 输入形状无法得到有效的批次方差并可能报错。此时可以增大批次、改用 LayerNorm,或在卷积任务中评估 GroupNorm。