
机器学习与深度学习 / 系统课时
创建自定义数据集
创建自定义数据集
本课把一组交易记录封装成 PyTorch 标准数据集,实现样本数量查询、按索引读取和批量加载。完成后,你可以让业务数据直接接入 DataLoader,并保证每个样本返回稳定的张量结构。
学习目标
- 理解自定义数据集需要承担的三个职责
- 正确实现
__len__()与__getitem__() - 使用
DataLoader验证单样本和批量输出
Dataset 在数据管道中的位置
Dataset 不负责训练模型,它只回答两个问题:数据集中有多少条样本,以及给定索引时应返回什么。DataLoader 再根据批大小、是否打乱和并行参数,多次调用数据集并组装批次。
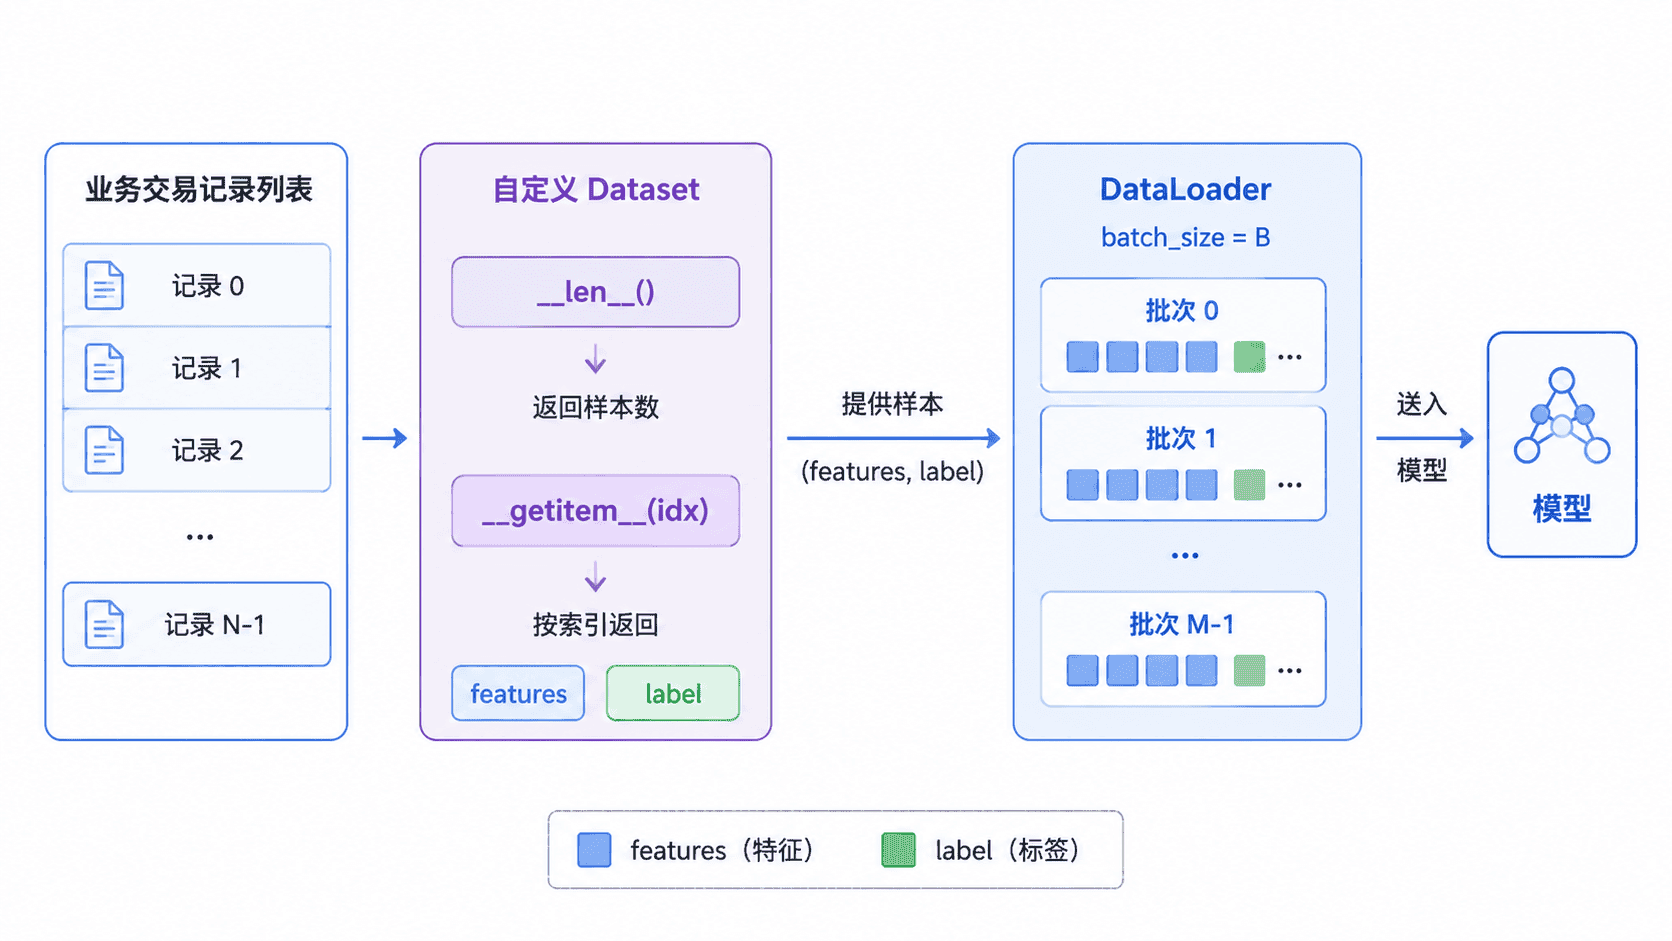
实现自定义 Dataset
下面使用内存中的交易记录演示完整实现。初始化阶段保存原始记录和类别映射,__len__() 返回记录数量,__getitem__() 负责类型转换、简单缩放并返回固定结构。
python
from typing import Any, Mapping, Sequence

import torch
from torch.utils.data import DataLoader, Dataset

class TransactionDataset(Dataset):
    def __init__(self, records: Sequence[Mapping[str, Any]]) -> None:
        # 初始化时固定记录顺序和类别映射,读取阶段不再改变它们。
        self.records = list(records)
        self.channel_to_id = {"app": 0, "web": 1}

    def __len__(self) -> int:
        return len(self.records)

    def __getitem__(self, index: int) -> dict[str, torch.Tensor]:
        if index < 0:
            index += len(self.records)
        if index < 0 or index >= len(self.records):
            raise IndexError("sample index out of range")

        record = self.records[index]
        # 数值字段统一转为 float32,类别字段映射为可训练的整数。
        features = torch.tensor(
            [
                float(record["amount_cent"]) / 100.0,
                float(record["hour"]) / 23.0,
                float(self.channel_to_id[record["channel"]]),
            ],
            dtype=torch.float32,
        )
        label = torch.tensor(int(record["is_fraud"]), dtype=torch.long)
        return {"features": features, "label": label}

def main() -> None:
    records = [
        {"amount_cent": 150, "hour": 23, "channel": "app", "is_fraud": 0},
        {"amount_cent": 300, "hour": 0, "channel": "web", "is_fraud": 1},
        {"amount_cent": 500, "hour": 12, "channel": "app", "is_fraud": 0},
    ]

    dataset = TransactionDataset(records)
    # 先验证单样本,再交给 DataLoader 检查批量结构。
    print(f"样本数: {len(dataset)}")

    sample = dataset[0]
    print("首个样本特征:", sample["features"].tolist())
    print("首个样本标签:", sample["label"].item())

    # DataLoader 会自动把相同键对应的张量堆叠成批次。
    loader = DataLoader(dataset, batch_size=2, shuffle=False)
    batch = next(iter(loader))
    print("批量特征形状:", tuple(batch["features"].shape))
    print("批量标签:", batch["label"].tolist())

if __name__ == "__main__":
    main()
预期输出:
text
样本数: 3
首个样本特征: [1.5, 1.0, 0.0]
首个样本标签: 0
批量特征形状: (2, 3)
批量标签: [0, 1]
保持结构稳定并完成验收
同一个数据集中的每条样本应返回相同的键、数据类型和形状,否则默认批量组装会失败。本例始终返回 features 和 label,其中 features 为长度 3 的 float32 张量,label 为标量 long 张量,适合常见分类损失函数。
原始数据缺字段、类别不在映射表中或索引越界时,应尽早抛出明确异常。真实项目还可以在初始化阶段校验必填字段,避免训练运行数小时后才暴露脏数据。完成实现后,至少检查以下结果:
len(dataset)与原始记录数量一致dataset[0]能返回模型可接收的张量DataLoader产生的批次第一维等于实际批大小- 多条样本的键、形状和数据类型完全一致
Dataset只定义单样本规则。批次大小、打乱、并行读取等策略应交给DataLoader,不要在__getitem__()中自行拼接批次。
按自己的节奏,确认真正理解。